1 每层激活显存的估算式
\[\text{Activations memory per layer} = s b h \left( 10 + \frac{24}{t} + 5 \frac{a s}{h t} \right)\]这个式子描述了 单层 Transformer 激活显存 与多种变量之间的关系:序列长度 $s$、micro-batch 大小 $b$、隐藏维度 $h$、注意力头数 $a$,以及张量并行度 $t$。展开后,前两项随 $sbh$ 增长,Attention Map 项随 $bas^2$ 增长;只有分到多张 GPU 的部分会对 $t$ 产生反比关系。
1.1 变量说明
| 符号 | 含义 |
|---|---|
| s | 序列长度(sequence length) |
| b | micro-batch 大小 |
| h | hidden size(隐藏维度) |
| a | 注意力头数(attention heads) |
| t | tensor parallel size(张量并行的 GPU 数) |
| p | pipeline parallel size(流水线并行度) |
| L | Transformer 层数 |
2 公式拆解
把括号展开,每卡每层的三项就是 $10sbh + 24sbh/t + 5bas^2/t$。下面用 $t=2$ 对照全局张量和两张卡各自保存的部分:
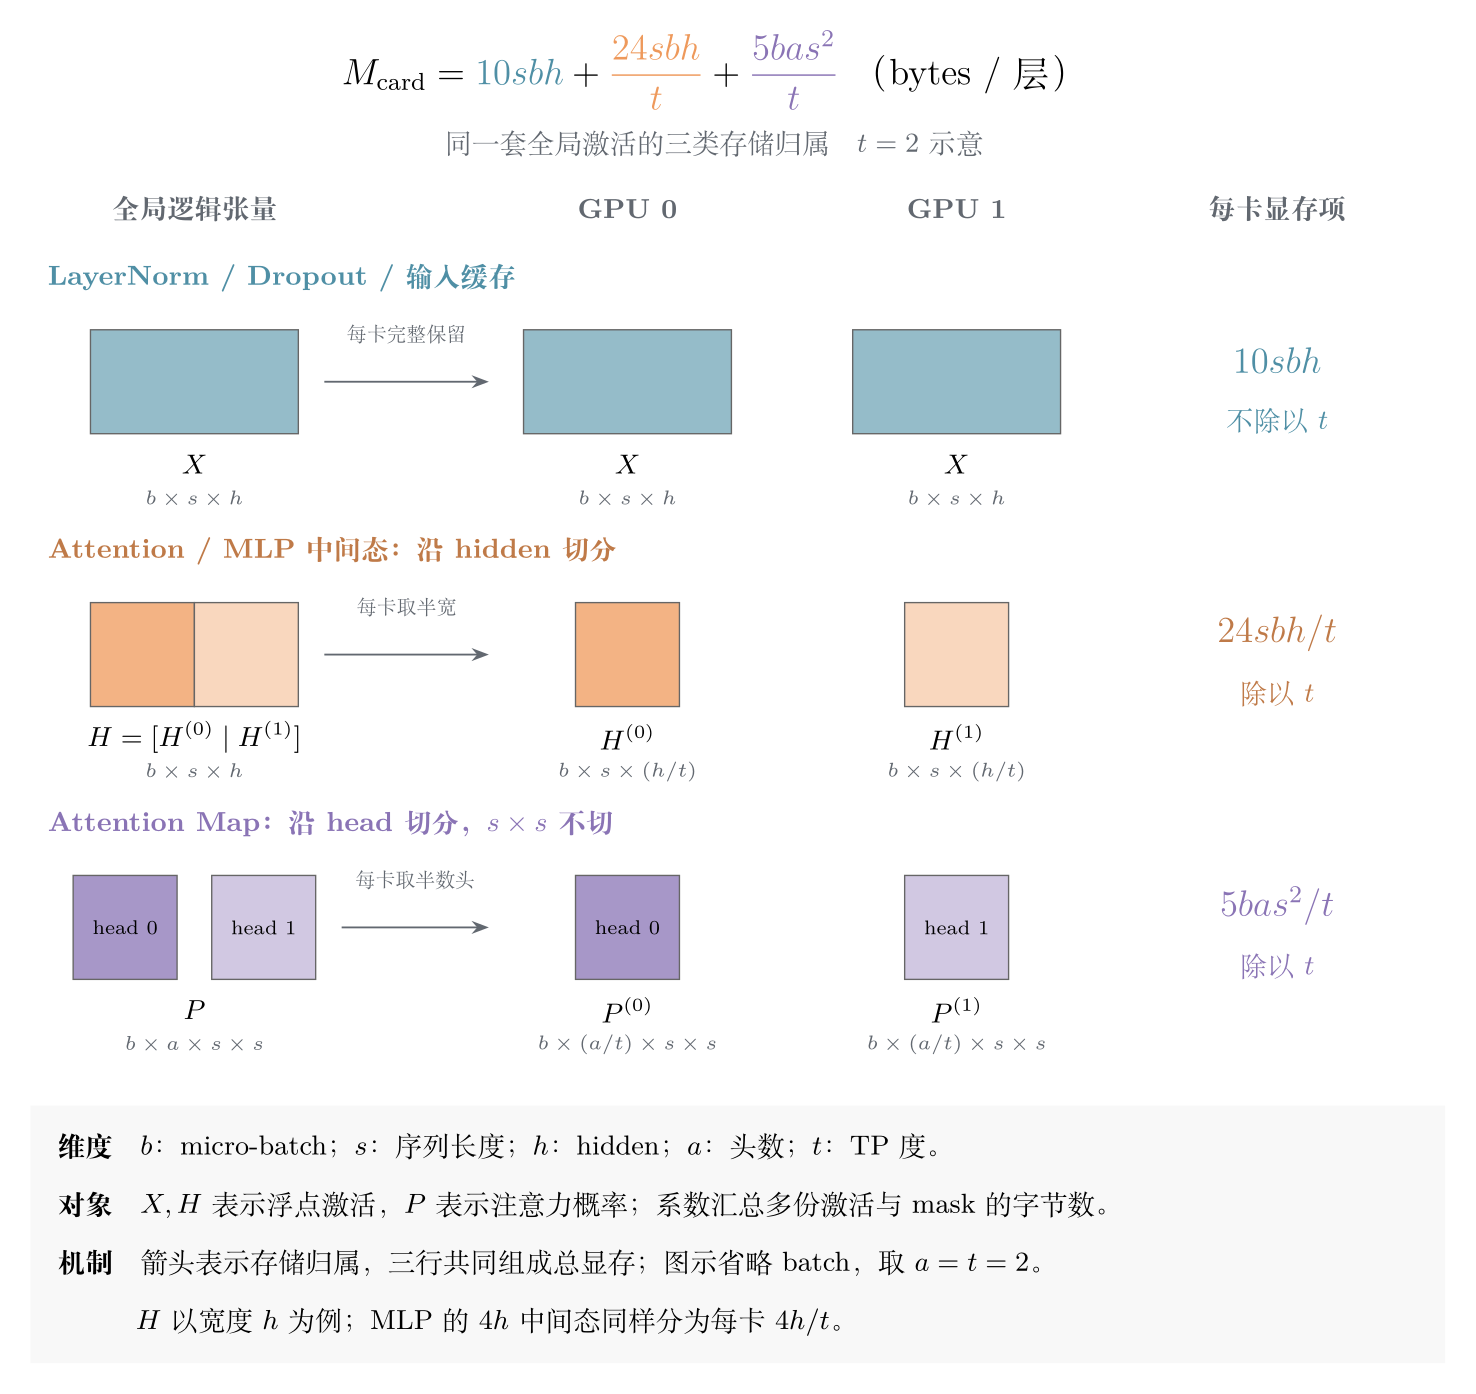
第一行两张卡保存同样大小的完整激活,所以 $10sbh$ 不除以 $t$;第二行各保留一段 hidden,第三行各保留一组 head,后两项才除以 $t$。第三行的方阵仍是完整的 $s\times s$:TP 减少的是每卡的头数,不是单个头的序列长度。图中的 $H$ 用宽度 $h$ 的中间态代表分片方式,MLP 的 $4h$ 中间态同理变为每卡 $4h/t$;它们共同计入 $24sbh/t$,不是一个 $H$ 张量就占这么多字节。
这里沿用原论文第 4.1–4.2 节的存储口径:浮点激活按 2 bytes、Dropout mask 按 1 byte 计,未做激活重计算,也未启用序列并行,并显式保存 Attention Map。系数汇总了反向传播需要保留的多份张量;其中 $5bas^2/t$ 包含 softmax、Attention Dropout 的相关存储,并非只存一份概率矩阵。图表示逻辑形状与保存归属。
2.1 LayerNorm / Dropout / 输入:固定项 10
$10sbh$ 来自两次 LayerNorm 的输入($4sbh$)、Attention 与 MLP 输出处的两个 Dropout mask($2sbh$),以及 QKV 投影和 MLP 第一层线性变换各自的输入($4sbh$),合计 $(4+2+4)sbh$ bytes。这里的 Dropout 指两个模块输出处的 Dropout;Attention Map 上的 Dropout 计入第三项。
在这里的纯 TP 方案中,这些张量在每张卡上各保留一份,因此该项不随 $t$ 下降。LayerNorm 需要完整的 hidden vector,但仍可沿序列维切分,这也正是后续序列并行能够继续压缩这部分存储的原因。
2.2 Attention / MLP 中间激活:24 从哪来
Attention 内部保存的 Q、K、V 各占 $2sbh$,输出投影的输入再占 $2sbh$,合计 $8sbh$。MLP 使用 $h\rightarrow4h\rightarrow h$ 的结构,GeLU 的输入和第二个线性层的输入各有 $4sbh$ 个元素,按每元素 2 bytes 计算,共占 $16sbh$。两部分相加就是:
\[\frac{(2+2+2+2)sbh+(8+8)sbh}{t}=\frac{24sbh}{t}\]这些中间态随 head 或 hidden 分片,每张卡只保存 $1/t$。QKV 投影和 MLP 第一层的完整输入已经计入固定项,这里不重复计算。系数 24 对应上述 GeLU MLP 结构;换成 SwiGLU 等结构时,应按实际中间维度和保存的张量重新统计。
2.3 Attention Map:5 从哪来
Softmax 输出占 $2bas^2$ bytes,作用在它上面的 Dropout mask 占 $bas^2$ bytes,Dropout 输出还需为后续与 V 的矩阵乘保存,占 $2bas^2$ bytes。因此,这一项的系数是 $2+1+2=5$:
\[\frac{(2+1+2)bas^2}{t}=\frac{5bas^2}{t}\]每卡负责 $a/t$ 个 head,所以总量除以 $t$,但每个 head 仍保存完整的 $s\times s$ 矩阵。固定其他变量时,序列长度翻倍会让这一项变成四倍。这里的 5 也依赖显式保存这些中间张量的实现;采用 FlashAttention 后,应按它实际保留的缓存重新估算。
3 代入一组数,TP 能省多少
取 $s=2048$、$b=1$、$h=4096$、$a=32$,沿用前面的存储口径。下表是公式手算结果,不是显卡实测;单位为 MiB($1\,\mathrm{MiB}=2^{20}$ bytes),每个数字都表示一个 micro-batch、每卡、每层的激活存储。
| TP 度 $t$ | 固定项 $10sbh$ | 中间态 $24sbh/t$ | Attention Map $5bas^2/t$ | 合计 |
|---|---|---|---|---|
| 1 | 80 | 192 | 640 | 912 |
| 2 | 80 | 96 | 320 | 496 |
| 4 | 80 | 48 | 160 | 288 |
| 8 | 80 | 24 | 80 | 184 |
这组参数下,公式可以直接写成 $M(t)=80+832/t$ MiB。TP 从 4 增加到 8,两项可分片存储确实各减半,但总量只从 288 MiB 降到 184 MiB,减少约 36.1%,因为固定的 80 MiB 还在。与 TP=1 相比,TP=8 的每卡激活存储降到了约五分之一,而非八分之一。
继续增大 TP,固定项所占比例还会提高。若要进一步减少它,就需要改变这些激活的保存方式,例如引入序列并行;Attention Map 的二次项则可以通过 FlashAttention 或选择性重计算处理。它们针对的存储不同,不能只用“多加几张 TP 卡”概括。
4 从每层激活到训练总显存
上面的结果只覆盖反向传播需要保留的单层激活。若一张卡负责全部 $L$ 层、只保留一个 micro-batch,且不做重计算,那么这些 Transformer 层的激活可粗估为 $L\,M(t)$。例如沿用算例,$L=32$、$t=8$ 时得到 $32\times184=5888$ MiB,即 5.75 GiB。
加入流水线并行后,要同时看每卡负责的层数和还未完成反向传播的 micro-batch 数。若层数均分为 $L/p$,某个 stage 在一个时刻为 $m$ 个 micro-batch 各保留了完整的本地层激活,可以粗估为 $m(L/p)M(t)$。实际保存量随调度和反向释放过程变化;$m$ 也不等于梯度累积的总步数。因此,不能只把 $L\,M(t)$ 除以流水线并行度 $p$,就当作激活峰值。
要估算训练所需的显卡容量,还需计入参数、梯度、优化器状态,以及 embedding、输出层和 loss 的相关张量、通信缓冲区、算子临时空间与内存分配开销。本文公式适合解释激活存储为何随 TP 变化,也能作为容量估算中的一项;最终峰值还取决于训练实现与调度。