Blackwell 数据中心 GPU(B200、GB200,SM100/SM103)围绕第五代 Tensor Core 引入了一块专用片上存储——TMEM(Tensor Memory)。本文整理 TMEM 的设计动机、tcgen05.mma 指令族的工作方式,以及从 Ampere 到 Blackwell 的 MMA 架构演进。
核心逻辑
每个 SM 配备 256 KB TMEM,与寄存器文件大小相同。TMEM 主要服务 tcgen05.mma,即 Blackwell 这一代新的 Tensor Core MMA 指令族(PTX ISA 8.6,支持 SM_100a/f、SM_103a/f)。
GEMM 的核心计算是:
D = A * B + D
MMA 指令把这个矩阵乘加以固定 tile shape 交给 Tensor Core 执行。由于 Tensor Core 吞吐远高于普通 SIMT CUDA core,一个原本用 SIMT 写的 GEMM 迁移到 MMA/Tensor Core 后,计算本身会变得非常快,瓶颈可能从 compute-bound 转移到 memory-bound。
这里的 memory 不只是 global memory,也包括 SMEM 布局、TMA 搬运、TMEM 读写、epilogue 从 TMEM 拷回寄存器等路径。
为什么需要 TMEM:accumulator 越来越大
矩阵乘法沿 K 分块计算时,输入 tile 可以不断更换,输出 tile 的部分和却要一直保留。Hopper 的 WGMMA 把这份 accumulator 放在线程寄存器中;输出 tile 越大,需要长期占用的寄存器也越多。
以一个 $128\times128$ 的 FP32 累加块为例,仅数据本身就需要:
\[128\times128\times4\ \text{bytes}=64\ \text{KiB}\]如果均摊到 128 个线程,相当于每线程 128 个 32-bit 寄存器,还没算地址、循环变量和其他临时值。这是用于理解容量压力的手算,不代表某个具体 kernel 的线程布局。寄存器占用较高会限制并发驻留;分配不下时,还可能出现 spill。
TMEM 将累加器从通用寄存器文件中独立出来,让 Tensor Core 直接更新这块片上存储。真正执行乘加的是 Tensor Core,TMEM 提供的是配套的存储与访问路径。它帮助缓解寄存器压力,但整个 kernel 的性能还取决于输入搬运、流水线和 epilogue。NVIDIA 编程指南明确将释放寄存器资源列为这一设计的特点。
架构演进
Ampere:     mma.sync        / Tensor Core warp-level MMA
Hopper:     wgmma.mma_async / warpgroup-level MMA
Blackwell:  tcgen05.mma     / UMMA / TMEM-backed MMA
Blackwell 上 tcgen05.mma 是 Hopper wgmma.mma_async 的替代者。wgmma.mma_async 在 Blackwell 上已被标记为 deprecated,不应在 SM100 上继续依赖。
TMEM 在 tcgen05.mma 里的位置
tcgen05.mma 的 PTX 签名大致为:
tcgen05.mma.cta_group.kind [d_tmem], a_desc, b_desc, idesc, ...
下面以 A/B 均来自 SMEM 的路径为例(A 也有来自 TMEM 的指令变体):
| 操作数 | 来源 |
|---|---|
| A | SMEM(通过 SMEM descriptor a_desc 传入) |
| B | SMEM(通过 SMEM descriptor b_desc 传入) |
| D / accumulator | TMEM([d_tmem] 为 TMEM 地址) |
Blackwell 的 MMA 累加器不再占用普通寄存器,而是放进 TMEM,从而大幅降低寄存器压力。
tcgen05.mma 由单个线程发射(issued by a single thread),而非 warp 集体发射,这是与 Hopper wgmma.mma_async(warpgroup 集体发射)的重要区别。
计算完成后,结果不能直接在 TMEM 里做普通 CUDA 运算。需要用 tcgen05.ld 把 accumulator 从 TMEM load 回寄存器,然后 epilogue 再做 scale、bias、activation、store 等后处理。
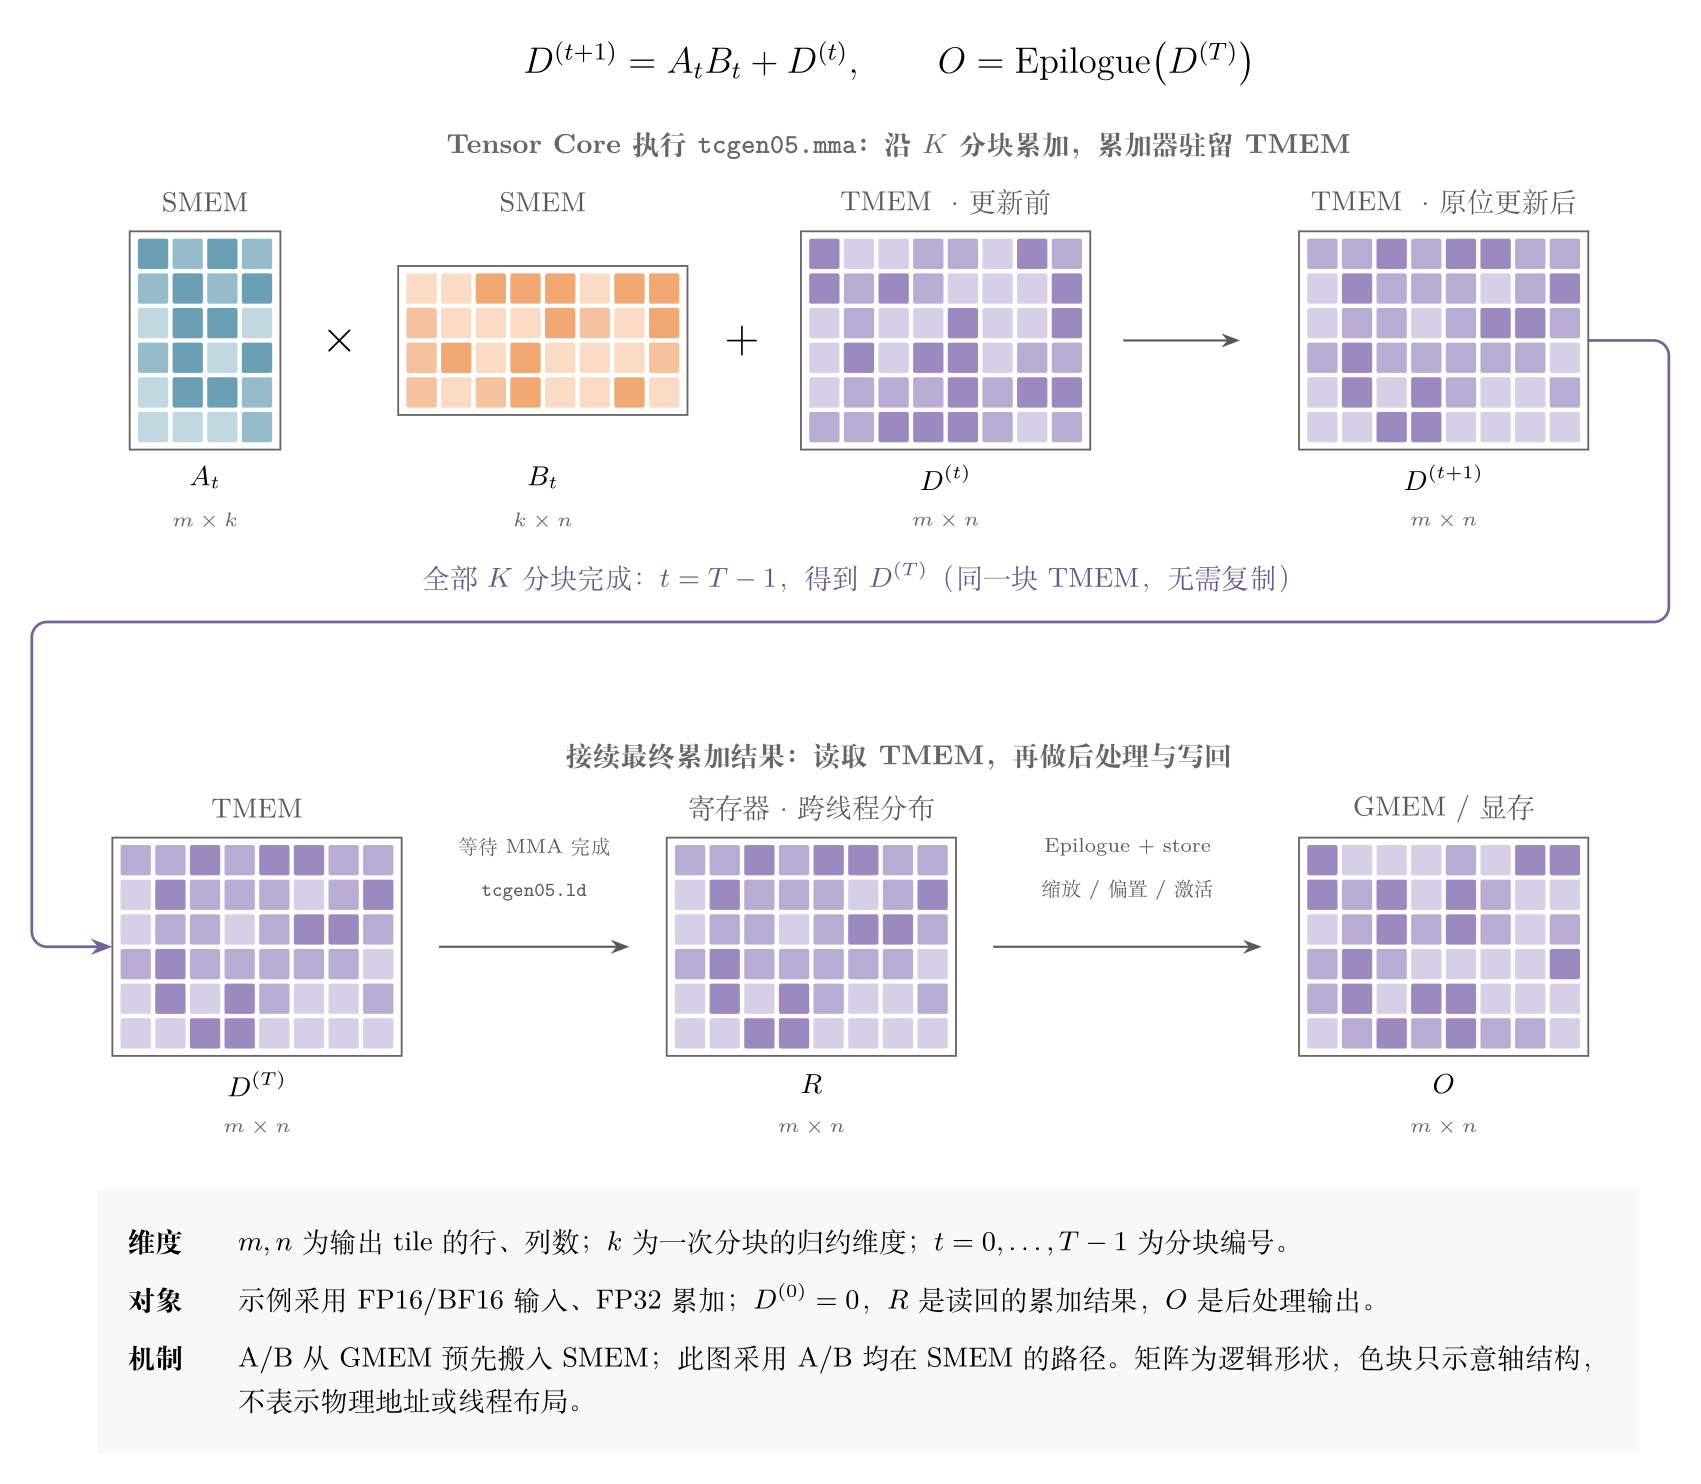
上排反复累加,下排接续最终结果
先固定一个输出 tile。图中 A 的形状是 $m\times k$,B 是 $k\times n$,因此每次矩阵乘法贡献一个 $m\times n$ 的结果。沿完整归约维度 K 一共处理 T 个分块,图里的 t 是分块编号,不是训练步数:
\[D^{(0)}=0,\qquad D^{(t+1)}=A_tB_t+D^{(t)},\qquad t=0,\ldots,T-1.\]这意味着上排会重复 T 次:换入下一组 A、B,再更新原来的 D。上排的“更新前”和“更新后”画的是同一块 TMEM 在两个时刻的状态,并没有分配两个累加器。这里 $D^{(0)}=0$ 是数学上的初始条件;实际指令可以在第一次 MMA 时关闭旧累加值的使用,不必先单独写入一整块零。
紫色跨行箭头连接的是最后一次更新。当 $t=T-1$ 时,上排右侧的 $D^{(t+1)}$ 就成为下排左侧的 $D^{(T)}$。两排之间没有数据复制,也不是上排每算一次就走一次下排。所有 K 分块完成后,才进入这张图的输出阶段。
此时先等待异步 MMA 完成,再通过 tcgen05.ld 把 TMEM 中的结果读到各线程的寄存器;读取完成后执行 scale、bias、activation 等 epilogue,最后写回 GMEM。图中 R 是这些寄存器片段合起来的逻辑矩阵,并非某一个线程拥有整块 R。实际 kernel 可以对不同输出 tile 做流水线重叠,图里只追踪一块 D 的生命周期。
D 是激活值,还是另一种中间结果
D 最准确的名字是“矩阵乘法累加器”:计算中是部分和,完成后是这个输出 tile 的乘法结果。以线性层为例:
\[Y=\operatorname{GeLU}(XW+b).\]前向时,可以把 D 理解为正在形成的 $XW$ 中间激活;加上 b、做完 GeLU 后才得到 Y。反向时,同样的矩阵乘法硬件又可能计算输入梯度或权重梯度,这时 D 承载的是梯度的部分和。
因此,“激活”描述数据在模型里的含义,“累加器”描述它在运算里的角色。TMEM 面向的是 Tensor Core 的矩阵计算,不能泛化为所有反复更新的激活值都会自动放进来的缓存。某些 MMA 变体也允许操作数 A 位于 TMEM;本图只展示 A/B 均位于 SMEM 的路径。
为什么不把这块面积用来加寄存器
增加通用寄存器当然也能缓解容量不足,但容量只是存储设计的一部分。寄存器文件还要为普通线程指令供给操作数,处理不同的读写请求,并连接各类执行单元。只增加存储容量,不代表供数带宽也增加;同时扩展带宽,又会带来读写通路、布线、功耗和时序上的成本。
回看上排,D 的使用方式相当集中:矩阵乘加反复读写同一块累加结果,直到 K 方向计算完毕。为这类访问单独提供 TMEM,可以让矩阵累加和普通线程工作分别使用各自的资源。寄存器仍然重要,下排的后处理就要用它,只是不必在整个 MMA 主循环期间都替 D 保管那一大块数据。
这是从工作负载和接口约束出发理解架构取舍,不代表公开资料给出了“TMEM 比等容量寄存器节省多少面积”的数字。也不能把收益解释成“原来每次累加都写显存,现在不用了”:上一代 Tensor Core 同样可以将累加结果保留在片上寄存器中。
“受限制的访问”具体限制在哪里
最直接的区别是指令接口。上排通过 tcgen05.mma 更新 D,下排通过 tcgen05.ld 把它读出;反向写入使用 tcgen05.st,SMEM 到 TMEM 的复制可使用 tcgen05.cp。普通 CUDA 算术指令不能直接拿 TMEM 地址当操作数,所以图里的通用后处理安排在读回寄存器之后。这些是本文用到的主要路径,不是整个指令族的完整清单。
其次,tcgen05.ld/st 是 warp 协作的块读写。参与线程使用同一基地址,选择指令支持的搬运形状,由规定的布局把数据分配到线程寄存器;不能像普通全局内存读写那样,让每个线程自由提交一套互不相关的地址。例如 .32x32b 描述的是 32 条数据通路上各 32 bit 的搬运形状,不是任意大小的逻辑矩阵。
对图中 SM100 的路径,warpgroup 内的四个 warp 通过 tcgen05.ld/st 分别访问 TMEM 的 0–31、32–63、64–95、96–127 行,各自可以访问这些行中的所有列。这些是物理 TMEM 行,并不自动等于图中逻辑 D 的矩阵行;内核还要建立相应的布局映射。具体规则见 PTX 的 Access restrictions。
最后还要处理完成顺序。单线程发射 MMA,不代表结果立即可读;warp 协作发出 load,也不代表异步读取已经结束。图中两排的连接处和下排读回后,都有需要满足的同步条件。TMEM 的专用性,既体现在硬件的数据路径上,也体现在编程时必须遵守这些访问与同步约束。
MMA shape 与 tiling
Tensor Core 是专用硬件,电路在设计时就固定了”一次能处理多大的矩阵块”。MMA 指令是 Tensor Core 的原子操作:
一条 MMA 指令 = 把一个固定大小的 A_tile 和 B_tile 喂给 Tensor Core,
                执行 D_tile += A_tile × B_tile,结果写回 D_tile。
shape 是硬件电路决定的,不能任意指定。比如 Ampere 的一个典型 atom 是 m16n8k16,硬件一次只能做这个尺寸。
实际 GEMM 的 M/N/K 远大于一条 MMA 指令的 tile,所以 CUTLASS/CuTe 做的事是分块(tiling):
大矩阵
  → CTA-level tile(一个 thread block 负责的块)
    → warp/warpgroup-level tile
      → MMA atom 大小的 tile(对应一条 MMA 指令)
整个大 GEMM 变成很多条 MMA 指令的循环叠加。例如 K=256、MMA atom K 维度为 16,则沿 K 循环 16 次,每次把 accumulator D 累加一次,最终 D 里存的就是完整的 A × B 结果。
dense FP16 的 tcgen05.mma 支持类似下面的 shape:
64 x N x 16
128 x N x 16
其中 N 也有倍数和上限约束。
兼容性与代际差异
不同代的 MMA 指令是架构绑定的:
| 指令 | 架构 | 状态 |
|---|---|---|
mma.sync |
Ampere (SM80) | 老路径,后续架构可能仍支持 |
wgmma.mma_async |
Hopper (SM90) | 在 Blackwell 上已 deprecated |
tcgen05.mma |
Blackwell (SM100/SM103) | 数据中心 Blackwell 新路径 |
消费级 vs 数据中心 Blackwell
消费级 RTX 50 系列(RTX 5090 等)使用 SM120(GB202),与数据中心 Blackwell SM100 是不同的架构目标:
- SM100(B200、GB200):有 TMEM,支持
tcgen05.mma,是本文讨论的主体。 - SM120(RTX 5090 等消费级):没有 TMEM,使用不同的 Tensor Core 编程模型,不能直接使用 SM100 的
tcgen05.mma代码路径。
因此,FlashAttention-4 等依赖 TMEM 的内核无法在消费级 RTX 50 系列上运行。
调用层次
底层最终是 PTX/inline asm 指令,但通常不直接手写裸 asm,而是走 CUTLASS/CuTe 的封装:
CUTLASS GEMM kernel
  → CuTe TiledMMA / MMA_Atom
    → SM100_MMA_* atom
      → tcgen05.mma PTX / inline asm
相关底层指令:
| 指令 | 功能 |
|---|---|
tcgen05.alloc |
分配 TMEM |
tcgen05.mma |
Tensor Core MMA(本图 A/B 来自 SMEM,D 在 TMEM;A 另有 TMEM 变体) |
tcgen05.ld |
TMEM → register |
tcgen05.st |
register → TMEM |
tcgen05.cp |
SMEM → TMEM |
tcgen05.dealloc |
释放 TMEM |
tcgen05.commit |
将先前异步操作的完成通知关联到 mbarrier |
tcgen05.mma 特点总结
- CTA 级,不再是传统 thread/warp 级语义
- 由单个线程发射(非 warpgroup 集体发射)
- 本图 A 来自 SMEM(通过 SMEM descriptor);另有来自 TMEM 的变体
- B 来自 SMEM(通过 SMEM descriptor)
- accumulator/D 必须在 TMEM
- 结果后处理前,需要用
tcgen05.ld从 TMEM 读回寄存器 - MMA shape 是受限的固定 tile shape,由 CUTLASS/CuTe 做 tile 映射
性能直觉
- SIMT GEMM 可能 compute-bound
- 换成 Tensor Core MMA 后,计算吞吐大幅提升,瓶颈经常转移到数据搬运和布局上
- 本图的输入路径是 GMEM → SMEM,Tensor Core 读取输入并在 TMEM 更新 D;输出路径是 TMEM → register → GMEM。A/B 不必先整体复制到 TMEM 才能计算。
参考资料
- NVIDIA tcgen05 MMA Programming Guide:数据流、累加器与结果读取
-
NVIDIA PTX ISA:Tensor Memory 与 tcgen05 指令(本文访问限制以 SM100 路径为例;核对日期 2026-09-20)
- NVIDIA CUTLASS Blackwell SM100 GEMM 文档
- libcu++ tcgen05.mma PTX wrapper
- Colfax CUTLASS Blackwell TMEM 教程
- Colfax CUTLASS Blackwell 2-SM UMMA 教程
- cuda-oxide Matrix Multiply Accelerators
- Mojo SM100 MMA API 文档
- SemiAnalysis: Dissecting NVIDIA Blackwell Tensor Cores
- Microbenchmarking NVIDIA’s Blackwell Architecture (arXiv)