关联阅读:另一套任务与 verifier 的组织方式,见 MiMo-V2.6-RL-oss:一条任务怎样成为 Agentic RL 环境。
0. 论文概览
CodeMidas 是小米 LLM Core 等团队提出的一套 Coding Agent 训练数据构造管线。思路是在开源仓库里挑一个已经实现好的功能,写出需求说明,把对应实现删掉,再让 agent 在这个仓库里把功能补回来。删掉的原实现留着生成测试、验证环境。经过清理和筛选,每个任务都能在容器里跑起来,由隐藏测试给出训练奖励。
这类任务通常从 issue、PR 或 commit 里提取:开发记录说明要修什么,对应的改动就是参考答案。CodeMidas 则直接从源代码提取功能,不要求仓库里已有相关的 issue、测试或文字说明,所以那些已经写好、却没有完整开发记录的功能也能拿来出题,任务来源宽了很多。
论文最终构造了 5,545 个任务,来自 3,185 个开源仓库,覆盖 23 种编程语言和 15 个技术领域。下面主要看这些任务是怎么做出来的。
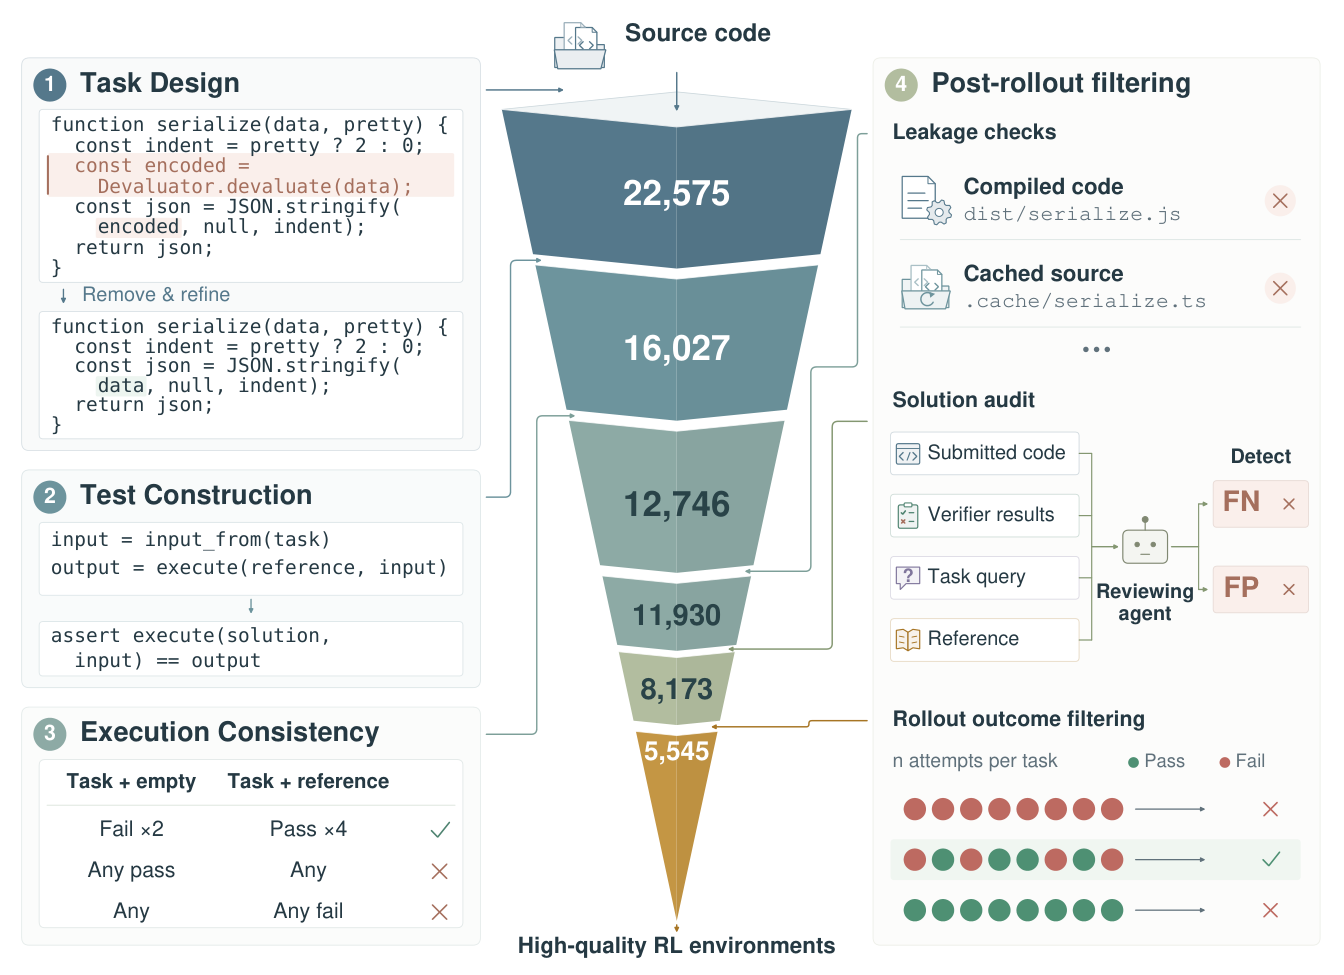
图 1:任务设计、测试构造、执行一致性检查和 rollout 后筛选。中间漏斗给出各阶段保留的任务数量,从 22,575 个候选逐步筛到 5,545 个训练环境。来源:论文 Figure 1。
1. 从仓库中选功能,生成任务起点
第一步是让 agent 读仓库结构和构建信息,找那些有公开入口、执行结果能观察到的功能。论文支持三类接口:命令行工具、纯函数和有状态的库 API,分别检查进程输出、函数返回值,以及多次调用之后的状态变化。
选定功能后,agent 顺着公开入口追踪相关实现和共享依赖,划出任务范围,然后删掉核心实现,并调整剩下的代码,让它成为一个能接着开发的起点。项目结构和共享组件都会保留;选题时也优先挑需要跨文件理解的功能。
需求说明和代码删改是同步完成的。说明里要写清输入、必须实现的公开接口和外部可观察的行为;内部用什么辅助函数、什么算法,交给求解 agent 自己决定。删了哪些代码,也要和要求补全的功能对得上。
处理完之后,原仓库变成两份副本:求解 agent 拿到的是缺了目标功能的代码;保留原实现的参考副本只用来构造测试,不会交给求解 agent。
2. 在原实现上执行,得到测试的预期结果
有了需求说明,下一步是构造 verifier,也就是最后给提交结果打分的可执行测试。
CodeMidas 先让 agent 把需求拆成测试输入和边界情况,再到参考副本上调用公开入口,记下实际执行结果。CLI 任务直接运行命令拿输出;纯函数任务生成输入输出用例;有状态 API 则生成调用序列,检查前后调用之间的依赖。每个测试还会标明自己覆盖的是哪条需求。论文第 3.2 节
预期值来自原实现的真实执行,而不是让模型去猜输出。但原实现的细节不能全写进断言。比如需求只规定抛出某类异常,就不该要求异常文案逐字一致;需求没规定输出顺序,也不能因为参考实现碰巧用了某种顺序,就把别的顺序判错。
所以测试生成之后,还要逐条审查断言。agent 会找出断言里那些题目并没有要求的限制,比如固定文案、偶然的顺序和内部结构,把它们换成对外部行为的检查。如果某个断言依赖私有符号,又找不到对应的行为检查方式,整个任务直接丢弃。改完的测试还要在参考实现上重跑一遍,确认依然能通过。
这一轮过后,测试输入和断言才算定下来,用于后续评分。到这里,任务已经有了需求、待补全的代码和测试,但它在实际求解时靠不靠得住,还没验证过。
3. 准备容器,检查起点失败、答案通过
环境从统一的基础容器镜像起步,由 agent 按项目声明安装依赖,备好构建和运行要用的资源。必要的软件包、数据文件和构建包装脚本留下;可能暴露原实现的东西都要清掉,包括编译产物、缓存副本和构造 agent 留下的文件。和目标功能相关的原始测试也会删掉。
这一步很实在:源码虽然删了,安装目录里可能还躺着完整版本,构建产物里也可能留着能直接调用的原功能。求解 agent 要是翻到这些,就用不着真去开发了。
接着,每个任务要在六个全新的容器里、按训练时的运行设置跑一遍检查:
- 两个容器使用待补全的起点代码,两次都必须失败。
- 四个容器放入参考答案,四次都必须通过。
这样既验证了补全前后的 fail-to-pass 关系,又靠重复执行筛掉了一部分不稳定的任务。起点已经能通过测试,或者放回参考答案仍然失败的,都进不了下一阶段。论文第 3.3 节
4. 让 agent 真正做题,再筛一遍
前面的检查只跑了起点代码和参考实现。换一种实现能不能被正确评分、环境里有没有漏掉的答案,得真去求解才能暴露出来。所以 CodeMidas 在 RL 训练之前又安排了三类 rollout 筛选,一次 rollout 就是 agent 从接到任务到提交结果的一次完整尝试。
第一类是 leakage filtering。一个对抗性 agent 专门找绕过开发工作的捷径,把整个可见环境里的缓存、编译产物、已安装的项目副本和遗留文件都翻一遍,并记下可疑利用方式对应的命令和输出。随后由另一个审查过程对照参考答案和 verifier 核实这些证据,一旦确认能靠泄漏材料绕过任务,这个环境就丢掉。
第二类检查 verifier 对 agent 解法的判决是否正确。每个任务让 coding agent 做四次,再由 reviewing agent 把提交代码、测试输出、交互轨迹、需求说明、verifier 和参考答案放在一起看,判断实现到底满不满足需求。
这里要找两种问题:实现不符合要求却通过了测试,是假阳性,说明测试漏掉了错误;实现符合要求却被测试拒绝,是假阴性,说明测试可能约束过度。查出这类 verifier 缺陷的任务都会移除。“参考实现能通过”这项检查覆盖不到的情况,即写法和参考答案不同的实现能否得到合理评分,正好由这一步补上。
最后是 rollout outcome filtering:用一个 frontier model 对每个任务做多次尝试,只保留有成功也有失败的任务。全部通过或全部失败,可能是难度问题,也可能是测试太弱、需求有遗漏之类的缺陷。论文没有再去细分原因,两类一律筛掉。
这轮筛选看的是给定模型、给定求解预算下的表现,留下的是一批有区分度的题目;到了后续训练,每组采样也不一定都既有成功又有失败。完整筛选过程见论文第 3.4 节。
5. 这些环境怎样用于 GRPO
走完上面这些步骤,每个训练任务由三部分组成:需求说明、容器化的开发环境、隐藏的可执行 verifier。求解时 agent 可以在环境里读代码、改代码、自己测试,而 verifier 一直放在求解环境之外,评分时才注入。奖励就是测试跑出来的 0 或 1,不用 reward model,也不用学出来的 verifier。
论文用这些任务对 MiMo-V2.5 做 GRPO 训练,batch size 为 32,每个任务采样 32 条 rollout,并关掉了优势的标准差归一化。以组内平均奖励作基线,优势写成:
\[A_i=r_i-\frac{1}{G}\sum_{j=1}^{G}r_j,\qquad G=32.\]比如一组里一半通过、一半失败,通过轨迹的优势就是 $0.5$,失败轨迹是 $-0.5$;要是整组全通过或全失败,优势就全为零。这也是前面要专门筛出能产生不同求解结果的任务的原因。训练配置见论文附录 A。
效果上,作者报告 DeepSWE 通过率从 10.0% 提升到 21.7%,Terminal-Bench v2.1 从 63.7% 提升到 72.2%;ProgramBench 的 Almost Solved(通过至少 95% 测试的任务比例)从 4.5% 提升到 21.5%。论文第 4 节
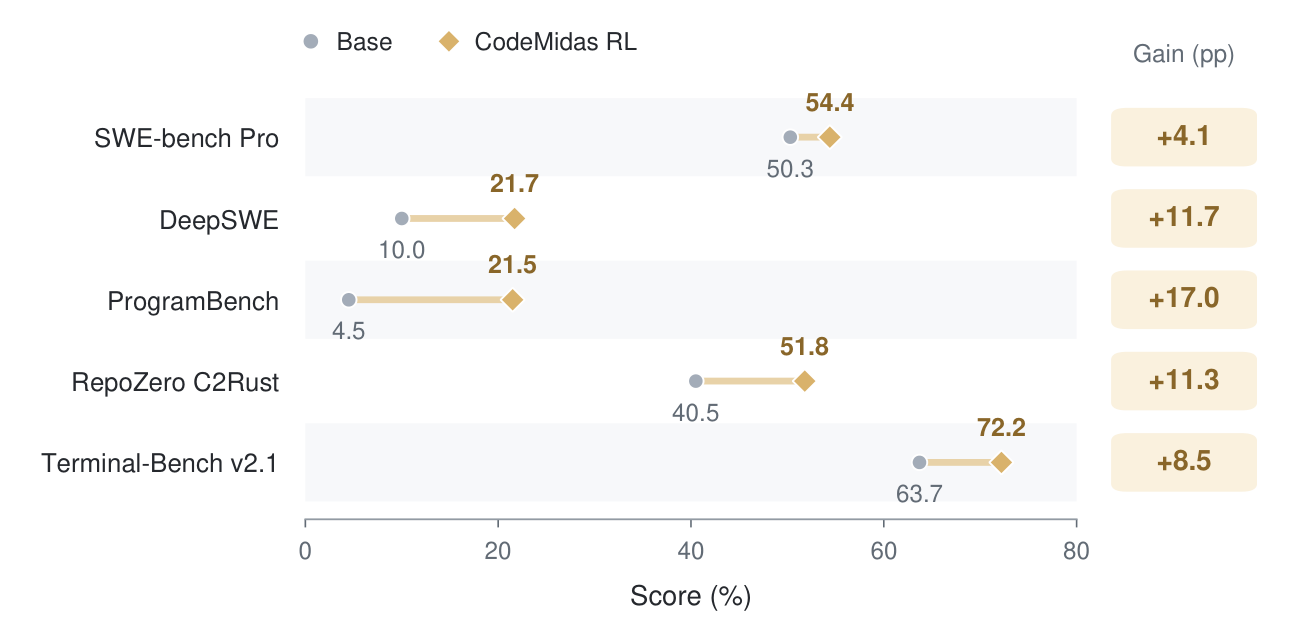
图 2:初始 MiMo-V2.5 与 CodeMidas RL 后的分数比较,右侧增量的单位为百分点;ProgramBench 使用 Almost Solved,其余为通过率。来源:论文 Figure 5。
和数据管线关系更直接的是质量消融:同样的训练配置下,处理过的 3k 任务在 SWE-bench Pro、DeepSWE 和 CodeMidas Val 上都超过了未处理的 8k 任务。8k 对照没做环境清理、执行一致性检查和三类 rollout 筛选,所以这组对比体现的是这些步骤合在一起的效果。另外,高质量任务池从 1k 扩到 3k、再扩到完整的 5,545 个任务,三项评测的分数也一路上涨。论文第 5.1 节
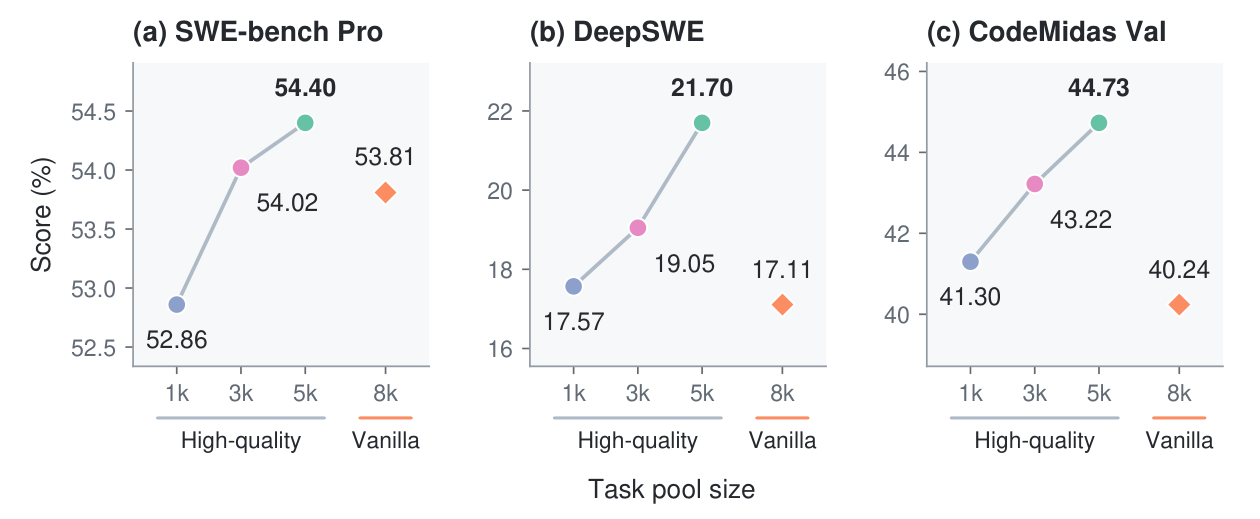
图 3:圆点对应高质量任务池的 1k、3k 和完整 5k(5,545)设置,菱形是未经清理和筛选的 8k 对照。三个子图的纵轴范围不同,比较时看分数,别直接比线段斜率。来源:论文 Figure 8。
总的来看,CodeMidas 的功夫基本都花在训练之前:从仓库里提取能描述清楚的功能,用原实现构造测试,再通过实际执行和 agent 求解来检验环境。最后送进 GRPO 的奖励只是一个 0 或 1,但要让这个 0 或 1 靠得住,前面整套任务构造和筛选都少不了。