引子:为什么今天还要重读 ReAct
ReAct 提出的「想一步、做一步、看结果」循环,就是今天几乎所有 LLM agent 的运行时。Claude Code、Cursor 的 agent 模式、SWE-agent 以及各家的 function calling,底层拓扑都没有离开它。
这篇论文发表于 ICLR 2023(Yao et al., arXiv:2210.03629)。实验用的是 PaLM-540B 加 few-shot prompting,按今天的标准已经算很原始,HotpotQA 的分数也远不如监督学习 SoTA。但它留下的不是分数,而是一个抽象:把「思考」也当成一种动作。
本文围绕三个问题展开:
- ReAct 到底提出了什么,哪些实验结论今天依然成立;
- 用 mini-swe-agent 这个约百行的 agent,看 ReAct 循环落到代码里是什么样;
- 它如何塑造了后来的 agent 框架,又如何反过来改变了 LLM 模型本身的训练方式。
ReAct 究竟提出了什么
ReAct 的核心只有一句话:把动作空间从环境动作 A 扩充为 A ∪ L(L 是语言空间),让模型在「推理」和「行动」之间交替。
形式化:思考是一种不碰环境的动作
传统 agent 在时刻 t 根据上下文 c_t 选一个环境动作,环境返回观察 o_t。ReAct 允许模型选一个语言动作(thought),它不作用于环境,也不产生观察,只更新上下文:
\[\hat{A} = A \cup L, \qquad \hat{a}_t \in L \;\Rightarrow\; c_{t+1} = (c_t,\ \hat{a}_t)\] \[\hat{a}_t \in A \;\Rightarrow\; c_{t+1} = (c_t,\ \hat{a}_t,\ o_t)\]这个看似平凡的扩充带来两个方向的收益:
- Reason to act:thought 用来制定、维护、调整高层计划,处理异常(「搜不到这个词,换个说法再搜」)。
- Act to reason:行动从外部环境带回真实信息,给推理提供事实依据,压住幻觉。
thought 的密度也是设计选择:HotpotQA / FEVER 这类知识任务用稠密交替(每步都想),ALFWorld / WebShop 这类长程决策任务用稀疏 thought,让模型自己决定何时「想一想」。后者正是今天 thinking budget、自适应思考的雏形。
一条典型轨迹
论文在 HotpotQA 上只给了三个故意做弱的 Wikipedia 动作:search[entity]、lookup[string]、finish[answer]。轨迹长这样(示意):
Question: Aside from the Apple Remote, what other device can control the program Apple Remote was originally designed to interact with?
Thought 1: I need to search Apple Remote and find the program it was originally designed to interact with.
Action 1: search[Apple Remote]
Observation 1: The Apple Remote is a remote control ... originally designed to control the Front Row media center program ...
Thought 2: Apple Remote was originally designed to control Front Row. I need to search Front Row next.
Action 2: search[Front Row]
Observation 2: Could not find [Front Row]. Similar: ['Front Row (software)', ...]
Thought 3: Front Row is not found. I need to search Front Row (software).
Action 3: search[Front Row (software)]
Observation 3: Front Row is a discontinued media center software ... controlled by an Apple Remote or the keyboard function keys.
Thought 4: Front Row can be controlled by an Apple Remote or the keyboard function keys. So the answer is keyboard function keys.
Action 4: finish[keyboard function keys]
注意 Thought 3:搜索失败后,模型用一句话修正了策略。纯 Act 版本没有这个缓冲,往往在无效动作上反复打转。
关键实验结论(PaLM-540B)
| 任务 | ReAct | 最强对照 | 说明 |
|---|---|---|---|
| HotpotQA (EM) | 27.4;与 CoT-SC 互为回退时 35.1 | CoT-SC 33.4 | 单独用不如 CoT-SC,组合才最好 |
| FEVER (Acc) | 60.9;CoT-SC → ReAct 64.6 | CoT-SC 60.4 | 事实核查更依赖外部证据 |
| ALFWorld (成功率 %) | 最好 71 / 最差 48 | Act 45,BUTLER 37 | 最差一次仍赢对照的最好成绩 |
| WebShop (Score / SR) | 66.6 / 40.0 | IL+RL 62.4 / 28.7 | 仅 1-shot;人类 82.1 / 59.6 |
比分数更值得记住的是三个分析结论:
- 幻觉 vs 推理错误:人工分析 200 条 HotpotQA 轨迹,CoT 失败的主因是幻觉(56%),ReAct 幻觉为 0%。代价是 ReAct 有 47% 的失败来自推理错误,包括重复循环卡死;23% 来自搜到无用信息后无法恢复。
- 收益来自规划,不是复述:ReAct-IM(只复述环境反馈的 Inner Monologue 风格)在 ALFWorld 只有 53%。真正有用的是目标分解和常识前瞻。
- 微调翻盘:只用 3000 条正确轨迹微调,8B 的 ReAct 超过 62B 的所有 prompting 方法,62B 超过 540B。prompting 时 ReAct 在小模型上最差,微调后最好——学「怎么去查」比背知识更能泛化。这一条后面会反复提到。
附录还有一个彩蛋:GPT-3(text-davinci-002)跑 ReAct,HotpotQA 30.8、ALFWorld 78.4,全面超过 PaLM-540B。指令微调过的模型天然更适合这套范式。
代码里的 ReAct:拆解 mini-swe-agent
mini-swe-agent 是 SWE-agent 团队做的极简 agent:核心循环约百行、只有一个 bash 工具、消息历史纯追加。它几乎就是 ReAct 的「参考实现」,只不过环境从 Wikipedia API 换成了 shell。下文代码来自仓库 2026-09 的提交 04d809c,有删减。
对照表:论文概念 → 代码
| ReAct 概念 | mini-swe-agent 中的对应 |
|---|---|
| 上下文 c_t | self.messages,只追加不修改 |
| Thought(语言动作) | 模型回复中代码块之前的自然语言 |
| Action(环境动作) | 一条 bash 命令(文本模式正则抽取,或原生 tool call) |
| Observation | env.execute() 的输出,套模板后作为 user 消息回灌 |
finish[answer] |
echo COMPLETE_TASK_AND_SUBMIT_FINAL_OUTPUT |
| few-shot 示例 | system / instance 模板里的 <format_example> |
| 步数上限(HotpotQA 7 步) | step_limit、cost_limit、wall_time_limit_seconds |
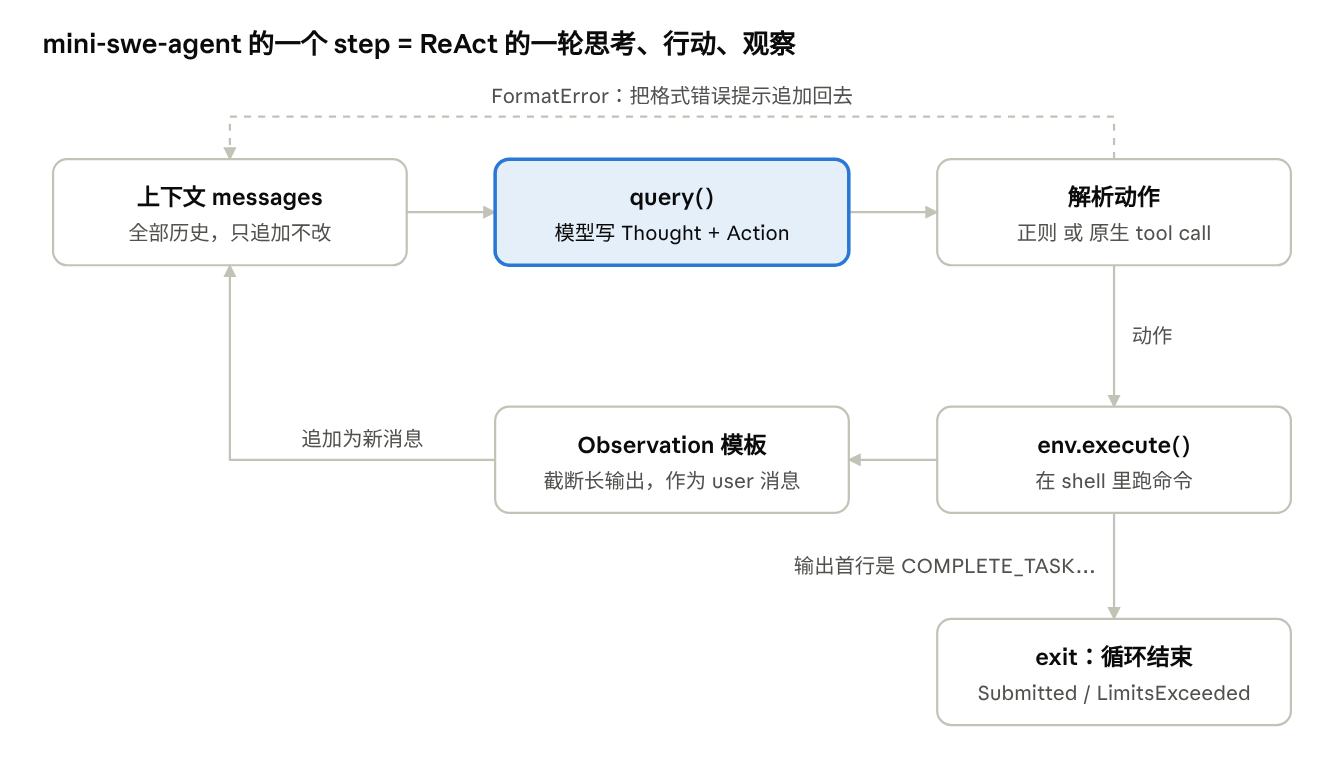
实线是正常的一轮:模型出动作、shell 执行、观察回灌;虚线是格式错误时把提示追加回上下文。两条路最终都回到 messages,只有 exit 消息能结束循环。
1. 主循环:run() 与 step()
# src/minisweagent/agents/default.py
def run(self, task: str = "", **kwargs) -> dict:
    self.messages = []
    self.add_messages(
        self.model.format_message(role="system", content=self._render_template(self.config.system_template)),
        self.model.format_message(role="user", content=self._render_template(self.config.instance_template)),
    )
    while True:
        try:
            self.step()
        except FormatError as e:          # 模型没按格式输出动作
            self.add_messages(*e.messages)
        except InterruptAgentFlow as e:   # 提交、超限等控制流
            self.add_messages(*e.messages)
        if self.messages[-1].get("role") == "exit":
            break
    return self.messages[-1].get("extra", {})

def step(self) -> list[dict]:
    return self.execute_actions(self.query())
这就是 ReAct 的 while 循环。step() 只有一行:问模型(得到 Thought + Action),执行动作(得到 Observation)。所有「非正常」情况——格式错误、提交、超限——都用异常携带一条消息追加进历史,循环靠最后一条消息的 role 是否为 exit 来终止。
2. query:Thought + Action 一次生成
def query(self) -> dict:
    if 0 < self.config.step_limit <= self.n_calls or 0 < self.config.cost_limit <= self.cost:
        raise LimitsExceeded({"role": "exit", "content": "LimitsExceeded", ...})
    self.n_calls += 1
    message = self.model.query(self.messages)   # 整段历史一起发给模型
    self.add_messages(message)
    return message
与论文一致,Thought 和 Action 在同一次生成里出现,模型看到的是完整的 c_t。步数和花费上限正是论文里「重复循环卡死」问题的工程兜底。
3. 提示词:要求「先想再做」
文本模式的配置 mini_textbased.yaml 几乎把 ReAct 格式写进了 system prompt:
system_template: |
  Your response must contain exactly ONE bash code block with ONE command ...
  Include a THOUGHT section before your command where you explain your reasoning process.
  <format_example>
  Your reasoning and analysis here. Explain why you want to perform the action.

  ```mswea_bash_command
  your_command_here
  ```
  </format_example>
「THOUGHT 在前、动作在后」、「每轮只有一个动作」——这就是 ReAct 的稠密交替模式。强制单动作是为了让每个决策都建立在上一步的真实观察之上。
4. 动作解析:从正则到 tool call
# src/minisweagent/models/utils/actions_text.py
def parse_regex_actions(content, *, action_regex, format_error_template, ...):
    actions = [a.strip() for a in re.findall(action_regex, content, re.DOTALL)]
    if len(actions) != 1:
        raise FormatError({"role": "user", "content": render(format_error_template, ...)})
    return [{"command": action} for action in actions]
这正是 ReAct 时代的做法:从自由文本里用正则把 Action: 抠出来,抓不到就报格式错误让模型重来。文件头的注释很说明问题:
This was the method used for mini-swe-agent v1.0 and the original SWE-agent. As of mini-swe-agent v2.0, we strongly recommend to use toolcalls instead.
v2 默认改用模型原生的 function calling,工具定义就是一个 JSON Schema:
# src/minisweagent/models/utils/actions_toolcall.py
BASH_TOOL = {
    "type": "function",
    "function": {
        "name": "bash",
        "description": "Execute a bash command",
        "parameters": {"type": "object",
                       "properties": {"command": {"type": "string"}},
                       "required": ["command"]},
    },
}
从正则到 tool call 的迁移,恰好是「ReAct 如何反过来改变模型」的缩影:曾经靠 prompt 约定的格式,后来被训进了模型和 API 协议。
5. Observation 回灌:上下文工程的起点
def execute_actions(self, message: dict) -> list[dict]:
    outputs = [self.env.execute(action) for action in message.get("extra", {}).get("actions", [])]
    return self.add_messages(*self.model.format_observation_messages(message, outputs, ...))
观察要先套模板才回灌。输出超过 10000 字符时,模板只保留头尾各 5000 字符,并提醒模型换个更精确的命令:
observation_template: |
  <returncode>{{output.returncode}}</returncode>
  {% if output.output | length < 10000 -%}
  <output>{{ output.output }}</output>
  {%- else -%}
  <warning>The output of your last command was too long. ...</warning>
  <output_head>{{ output.output[:5000] }}</output_head>
  <output_tail>{{ output.output[-5000:] }}</output_tail>
  {%- endif -%}
ReAct 论文里 Observation 是几句 Wikipedia 摘要,不存在这个问题。一旦环境变成 shell,「观察怎么回灌」就成了独立的工程问题,也就是今天说的上下文工程。
6. 终止:finish[] 的 shell 版
# src/minisweagent/environments/local.py
def _check_finished(self, output: dict):
    lines = output.get("output", "").lstrip().splitlines(keepends=True)
    if lines and lines[0].strip() == "COMPLETE_TASK_AND_SUBMIT_FINAL_OUTPUT" and output["returncode"] == 0:
        raise Submitted({"role": "exit", "content": "".join(lines[1:]), ...})
终止本身也是一个动作:模型自己决定何时交卷。对应论文里的 finish[answer],只不过答案从一个字符串变成了一份代码 diff。
为什么这么简单就够了
mini-swe-agent 没有规划器、没有记忆模块、没有专门的编辑工具,却能在 SWE-bench Verified 上拿到不错的成绩。它说明的是:当模型足够强时,ReAct 循环本身就是充分的 agent 架构,复杂度应该交给模型,而不是脚手架。这也是下一节和第五节的主线。
对后续 Agent 的影响
ReAct 之后的 agent 演进,大致可以概括为:循环的拓扑没变,循环里每一个组件都被工程化了。
1. 循环成为默认运行时
ReAct 发表后不久,LangChain 的第一批 agent(zero-shot-react-description)几乎原样照搬了 Thought: / Action: / Action Input: / Observation: 格式,把它变成了开发者的默认模板。之后的 AutoGPT、LangGraph 的 create_react_agent、SWE-agent、OpenHands,直到 Claude Code 这类编码 agent,核心都是同一个「模型 → 工具 → 结果回灌」的 while 循环。各家的差异在工具集、上下文管理和外层编排,而不在循环本身。
2. Action 从文本约定变成协议
ReAct 的 Action 是 prompt 里约定的字符串,要靠正则解析,模型偶尔还会自己编出 Observation。于是业界一步步把它标准化:
- Function calling:2023 年起主流 API 提供结构化的工具调用,工具用 JSON Schema 描述,模型输出结构化的调用请求,结果以专门的 tool result 消息回传。Thought / Action / Observation 三种角色自此有了协议层面的位置。
- MCP(Model Context Protocol):2024 年底发布,把「环境提供哪些动作」也标准化了。ReAct 里手写的
search[] / lookup[],变成了可以即插即用的工具服务器。
mini-swe-agent 从 v1 正则解析到 v2 推荐 tool call,正是这条路的缩影。
3. 环境接口成为设计对象:ACI
ReAct 论文故意把 Wikipedia API 设计得很弱,以显示推理的作用。但它也暴露了一个事实:动作空间和观察格式的设计,直接决定 agent 的上限。SWE-agent(2024)把这一点提炼为 Agent-Computer Interface:给 agent 设计专门的文件查看、搜索、编辑命令,并对输出做截断和格式化。有趣的是,同一团队后来的 mini-swe-agent 反向验证:模型变强后,只给一个 bash 也够了,ACI 的价值收缩到了「观察怎么截断」这类少数地方。
4. 上下文工程:Observation 回灌的后果
ReAct 把每一步的观察都追加到上下文里。轨迹短时这没问题,但编码 agent 一个任务动辄几十上百步,上下文很快会被撑爆。今天的一系列工程手段都是在处理这个问题:输出截断(如 mini-swe-agent 的头尾各 5000 字符)、长会话自动摘要压缩、把大文件写入磁盘而不是放进上下文、用子 agent 隔离大量的中间观察。
5. 外层编排:在循环之上加一层
ReAct 是单步贪心的:每一步只看当前上下文做决定,不会回头反思。后续工作大多是在它外面套一层:
| 方向 | 代表工作 | 在 ReAct 基础上加了什么 |
|---|---|---|
| 反思 | Reflexion(2023) | 失败后用语言总结教训,写入记忆再重试 |
| 搜索 | Tree of Thoughts、LATS(2023) | 把单条轨迹扩展为树搜索,可回溯 |
| 计划先行 | Plan-and-Execute、编码 agent 的 plan mode | 先生成完整计划,经人审批后再执行 |
| 多 agent | 主 agent + 子 agent 的分工架构 | 每个子 agent 自己跑一个 ReAct 循环,只回传结论 |
这些改进很多在论文里就有影子:ReAct → CoT-SC 的互相回退是「主路径失败就降级」的雏形;附录中人只改两句 thought 就把失败轨迹拉回来的实验,则是今天「可编辑、可审批的计划」的思想源头——改想法比改动作省力得多。
6. 安全边界与工程兜底
论文的 ethics statement 已经意识到接入真实动作的风险,实验里刻意限定「不能真买、不能真改 Wikipedia」。今天的沙箱执行、权限确认、危险命令拦截,以及 mini-swe-agent 里的 step_limit、cost_limit、连续格式错误上限,都是同一类问题的工程答案。
对 LLM 模型本身的影响
ReAct 最深远的影响可能不在框架,而在模型:它把「轨迹」变成了一种可以训练的数据形态。曾经靠 few-shot prompt 「教」给模型的东西,一步步被训进了权重。
1. 论文自己就埋下了伏笔:在轨迹上微调
第二节提到,3000 条正确轨迹就能让 8B 模型超过 62B 的 prompting。这说明「怎么用工具」是一种可以通过少量数据学会、而且泛化很好的技能。后续的 FireAct、AgentTuning 等工作沿着这条路把多任务、多格式的 agent 轨迹拿来做 SFT;今天各家的后训练数据里,工具使用轨迹已经是标配。
2. 工具调用成为模型的原生能力
ReAct 时代,模型只是在「续写一段恰好长得像轨迹的文本」,所以会出现格式错误,甚至自己编出 Observation。后来的模型在训练中就见过大量结构化的工具调用:它知道调用之后应该停下来等结果,知道如何解读 tool result,知道何时并行调用多个工具。mini-swe-agent 里 FormatError 那一整套重试逻辑,在原生 tool call 下大多数时候已经用不到。
3. Thought 被内化为「推理模型」的思考
ReAct 的 thought 是写在可见输出里的一两句话。推理模型出现后,这部分变成了独立的思考通道,而且长度可以自适应。关键的一步是交错思考(interleaved thinking):模型在两次工具调用之间可以重新思考,而不是只在开头想一次。这其实就是 ReAct 的 Thought → Action → Observation → Thought 交替,只不过 Thought 从 prompt 约定变成了模型结构的一部分。论文里「稀疏 thought,让模型自己决定何时想」的设计,也对应到了今天的 thinking budget 和自适应思考。
4. 在环境里做强化学习
SFT 只能模仿已有的好轨迹。更进一步的做法是把模型放进环境里跑 ReAct 循环,用结果是否正确(测试是否通过、答案是否对)作为奖励做 RL。这时一条完整的轨迹就是一个 episode,每一步的 Thought + Action 是策略输出,Observation 是环境状态转移。与此对应,mini-swe-agent 把每次运行保存为统一格式的轨迹文件:
# src/minisweagent/agents/default.py — serialize()
agent_data = {
    "info": {"exit_status": ..., "submission": ..., "model_stats": {...}},
    "messages": self.messages,          # 完整的 Thought / Action / Observation 序列
    "trajectory_format": "mini-swe-agent-1.1",
}
简单的循环 + 统一的轨迹格式,恰好是做评测和生成训练数据最需要的东西。这也是 mini-swe-agent 这类极简 agent 在研究界受欢迎的原因之一。
5. 从「模型 + 框架」到「模型即 agent」
把以上几点连起来看,可以看到一个清晰的趋势:原本在框架里的东西不断被下沉到模型里。
| 能力 | ReAct(2022)由谁负责 | 今天由谁负责 |
|---|---|---|
| 输出格式 | few-shot 示例 + 正则解析 | 模型原生 tool call |
| 何时思考、想多少 | 人工设定稠密 / 稀疏 | 模型自适应的思考 |
| 失败后如何恢复 | 外部回退到 CoT-SC | 很大程度上由模型在循环内自行调整 |
| 何时停止 | finish[] + 步数上限 |
模型判断为主,步数 / 花费上限兜底 |
框架并没有消失,而是把精力转向了模型处理不了的部分:上下文管理、权限与沙箱、工具生态、多 agent 协作。ReAct 定义的接口——模型输出动作、环境返回观察——恰好是这两者的分界线。
局限与反思
ReAct 自己承认的缺陷,大多至今仍是 agent 的主要失败模式,只是缓解手段变了。
| 论文中的问题 | 当时的表现 | 今天的常见缓解 |
|---|---|---|
| 重复循环卡死 | 推理错误占失败的 47%,作者怀疑与 greedy decoding 有关 | 步数 / 花费上限、循环检测、更强的模型自我纠偏 |
| 检索失败后无法恢复 | 占失败的 23% | 外层反思与重试、更强的工具(全文搜索、grep) |
| 上下文无限增长 | 短任务中不明显 | 输出截断、自动压缩、子 agent 隔离 |
| 单步贪心、不会回头 | 一句错误 thought 就能让整条轨迹偏离 | 先计划、人工审批、树搜索 |
| 依赖 few-shot 示例 | 示例增多反而不涨 | 在轨迹上做 SFT / RL,把格式训进模型 |
还有一点值得注意:ReAct 单独使用时并不总是最好的。在 HotpotQA 上它不如 CoT-SC,只有两者互相回退时才最强。内部知识和外部检索是互补的,这一点在今天「先用模型自己的知识、不确定再去查」的 agent 行为里依然成立。
反过来,有些东西已经被淘汰:文本形式的 Action: 解析被原生 tool call 取代,手工设定 thought 密度被模型自适应思考取代,全量追加上下文被各种压缩策略取代。留下来的是那个最核心的抽象。
结语
ReAct 留给后来者的,是一个小到可以写进一个公式的抽象:思考是一种不碰环境的动作。围绕这个抽象,框架层把动作协议化、把上下文工程化;模型层把格式、思考和恢复能力训进了权重。mini-swe-agent 用百行代码就能工作,恰恰说明这个循环本身已经不再是瓶颈——真正的差异,在于循环里的模型有多强,以及环境和上下文设计得有多好。
如果只有 30 分钟重读原文,建议顺序:Sec 2(形式化)→ Table 2(失败分析)→ 附录 D.2 的三组轨迹对比(ReAct / Act / ReAct-IM)→ Fig 3(微调结论)。
参考资料
- Yao et al., ReAct: Synergizing Reasoning and Acting in Language Models, ICLR 2023;项目页
- mini-swe-agent 源码(本文引用提交
04d809c,2026-09):agents/default.py、config/mini_textbased.yaml、models/utils/actions_text.py、models/utils/actions_toolcall.py、environments/local.py - mini-swe-agent 控制流说明
- Yang et al., SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering, 2024
- Shinn et al., Reflexion: Language Agents with Verbal Reinforcement Learning, 2023
- Chen et al., FireAct: Toward Language Agent Fine-tuning, 2023