1. 浮点计算基础概念
1.1 FLOP(Floating Point Operation)
FLOP 表示一次基本的浮点运算,例如加法 $x + y$ 或乘法 $x \times y$。
1.2 FLOPs
FLOPs 表示“总共做了多少浮点运算”,即计算工作量的度量。
例如,训练 GPT-3 的总计算量约为:
\[3.14 \times 10^{23} \text{ FLOPs}\]1.3 FLOP/s 或 FLOPS
FLOP/s(FLOPS) 表示“每秒能执行多少次浮点运算”,是硬件的速度指标。
例如:
- NVIDIA A100:FP16/BF16 Tensor Core 稠密峰值约 312 TFLOP/s。
- NVIDIA H100 SXM:FP16/BF16 Tensor Core 稠密峰值约 989 TFLOP/s,结构化稀疏峰值约 1979 TFLOP/s。
这里都是理论峰值,989 TFLOP/s 不是实测速度。计算 MFU 时要对齐设备型号、精度和稠密/稀疏口径。参见 NVIDIA GPU 性能背景说明与 H100 规格。
2. 线性模型的 FLOPs 计算
2.1 示例:线性层矩阵乘法
以一个简单线性层为例:
y = x @ w
设:
- $B$ = batch size(样本数)
- $D$ = 输入维度
- $K$ = 输出维度
矩阵乘法 $(B \times D) \times (D \times K)$ 包含:
- 1 次乘法:$x[i][j] \times w[j][k]$
- 1 次加法
按一次乘加计 2 FLOPs 的常用口径,近似计算量为(精确点积计数为 $BK(2D-1)$):
\[\text{actual_num_flops} = 2 \times B \times D \times K\]2.2 其他算子的 FLOPs 量级
在本文讨论的稠密 Transformer 中,矩阵乘法通常是主要的 FLOPs 来源。
其他算子的 FLOPs 数量级:
| 算子类型 | FLOPs 复杂度 | 说明 |
|---|---|---|
| ReLU、GELU、SiLU | $O(B \times D)$ | 常数取决于激活函数及其实现 |
| LayerNorm、Softmax、Dropout | $O(B \times D)$ 或 $O(B \times L)$ | 包含逐元素运算或归约 |
做大模型的粗略 FLOPs 估算时,通常先统计矩阵乘法。但 FLOPs 少不代表耗时少:归约、访存和 kernel 启动仍会影响实际速度。
3. FLOPs 与Transformer
3.1 Transformer 模型 FLOPs 分解
记:
- $B$:batch size
- $L$:sequence length(序列长度)
- $H$:hidden size(隐藏维度)
以下统计一个标准多头 Attention、FFN 中间维度为 $4H$ 的 Transformer Block 的前向计算,不含 bias、归一化和逐元素操作。Attention 的形状按各头分别计算,表中 FLOPs 已对所有头求和;记头数为 $n_h$,每头维度为 $d_h=H/n_h$。
| 模块 | 计算形式 | 近似 FLOPs | 含义 |
|---|---|---|---|
| Attention QKV projection | $[B, L, H] \times [H, 3H]$ | $2BLH(3H)$ | 从 hidden 生成 Q、K、V |
| Attention 乘积 $(QK^\top)$ | $[B,n_h,L,d_h] \times [B,n_h,d_h,L]$ | $2BL^2H$ | 序列内自注意力 |
| Attention 输出 $(AV)$ | $[B,n_h,L,L] \times [B,n_h,L,d_h]$ | $2BL^2H$ | 加权聚合结果 |
| Attention 输出投影 | $[B,L,H] \times [H,H]$ | $2BLH^2$ | 合并各头后投影 |
| FFN 前后两层线性 | $[B, L, H] \times [H, 4H] + [B, L, 4H] \times [4H, H]$ | $2BLH(8H)$ | MLP 两个线性层 |
因此,一个 Block 的前向 FLOPs 为:
\[F_{\text{block,fwd}}\approx 24BLH^2+4BL^2H\]除以 $BL$,得到每个 token、每个 Block 的前向计算量 $24H^2+4LH$。其中线性层参数量约为 $12H^2$,所以线性部分正好是“每个 token、每个参数约 2 FLOPs”。Attention 的 $QK^\top$ 和 $AV$ 没有可训练权重,却也要执行矩阵乘法,需单独计数。
这里对 Attention 采用完整 $L\times L$ 矩阵的计量口径;若按因果 Attention 有效三角区域统计,Attention 项约减半。比较不同 MFU 结果时要统一这一口径。
3.2 总体 FLOPs 估算公式
整个训练的总 FLOPs 近似为:
\[\text{Total FLOPs} \approx 6 \times N_{\text{params}} \times N_{\text{tokens}}\]其中:
- $N_{\text{params}}$:参与稠密矩阵乘法的参数量;若有 $n_\ell$ 个上述 Block,仅这些 Block 就约有 $12n_\ell H^2$ 个参数。
- $N_{\text{tokens}}$:训练总 token 数
- 系数 6:一次前向 GEMM 约计 2,计算输入梯度与权重梯度的两次反向 GEMM 合计约计 4,第 5 节展开推导。
$6N_{\text{params}}N_{\text{tokens}}$ 适合线性层占主导的粗估。沿用上面的完整 Attention 矩阵口径,并把反向计为前向的两倍,包含 Attention 乘积的估算为:
\[F_{\text{train}}\approx \left(6N_{\text{params}}+12n_\ell LH\right)N_{\text{tokens}}\]序列越长,第二项越不能忽略。这里的 $L$ 是固定序列长度,$N_{\text{tokens}}$ 是整个训练累计处理的 token 数。PaLM 附录 B 使用了相同的计量思路。
4. 理论算力与实际速度
4.1 代码计时与 MFU
实际测量矩阵乘法性能:
actual_time = time_matmul(x, w)
actual_flop_per_sec = actual_num_flops / actual_time
与硬件规格表比较:
promised_flop_per_sec = get_promised_flop_per_sec(device, x.dtype)
gemm_utilization = actual_flop_per_sec / promised_flop_per_sec
上面测到的是单个 GEMM 的算力利用率。模型训练的 MFU (Model FLOPs Utilization) 要用完整训练步的耗时:
\[\text{MFU} = \frac{F_{\text{model,step}}}{t_{\text{step}}\times n_{\text{GPU}}\times P_{\text{peak,GPU}}}\]$F_{\text{model,step}}$ 是一次优化器更新对应的全局 batch 的模型前反向 FLOPs,包含梯度累积覆盖的全部 micro-batch;$t_{\text{step}}$ 是同一更新的实测耗时,$P_{\text{peak,GPU}}$ 是单卡、对应精度的理论峰值。GPU 计时要预热并等待异步计算完成,多卡测量要覆盖通信和同步。
MFU 的分子通常不计激活重计算产生的额外 FLOPs,但这些计算会占用训练时间。把重计算也纳入分子则属于 HFU(Hardware FLOPs Utilization)的计量思路,二者的区别见 PaLM §4.1。通信、访存、kernel 启动以及矩阵形状都会影响 MFU,不能把 $1-\text{MFU}$ 直接解释为 GPU 空闲时间。
5. 前向与反向 FLOPs 分析
先看一层 $Y=XW$:$X\in\mathbb{R}^{B\times D}$,$W\in\mathbb{R}^{D\times K}$。令 $dY=\partial loss/\partial Y$ 为后续计算传回的梯度,链式法则给出 $dX=dY\,W^\top$、$dW=X^\top dY$。
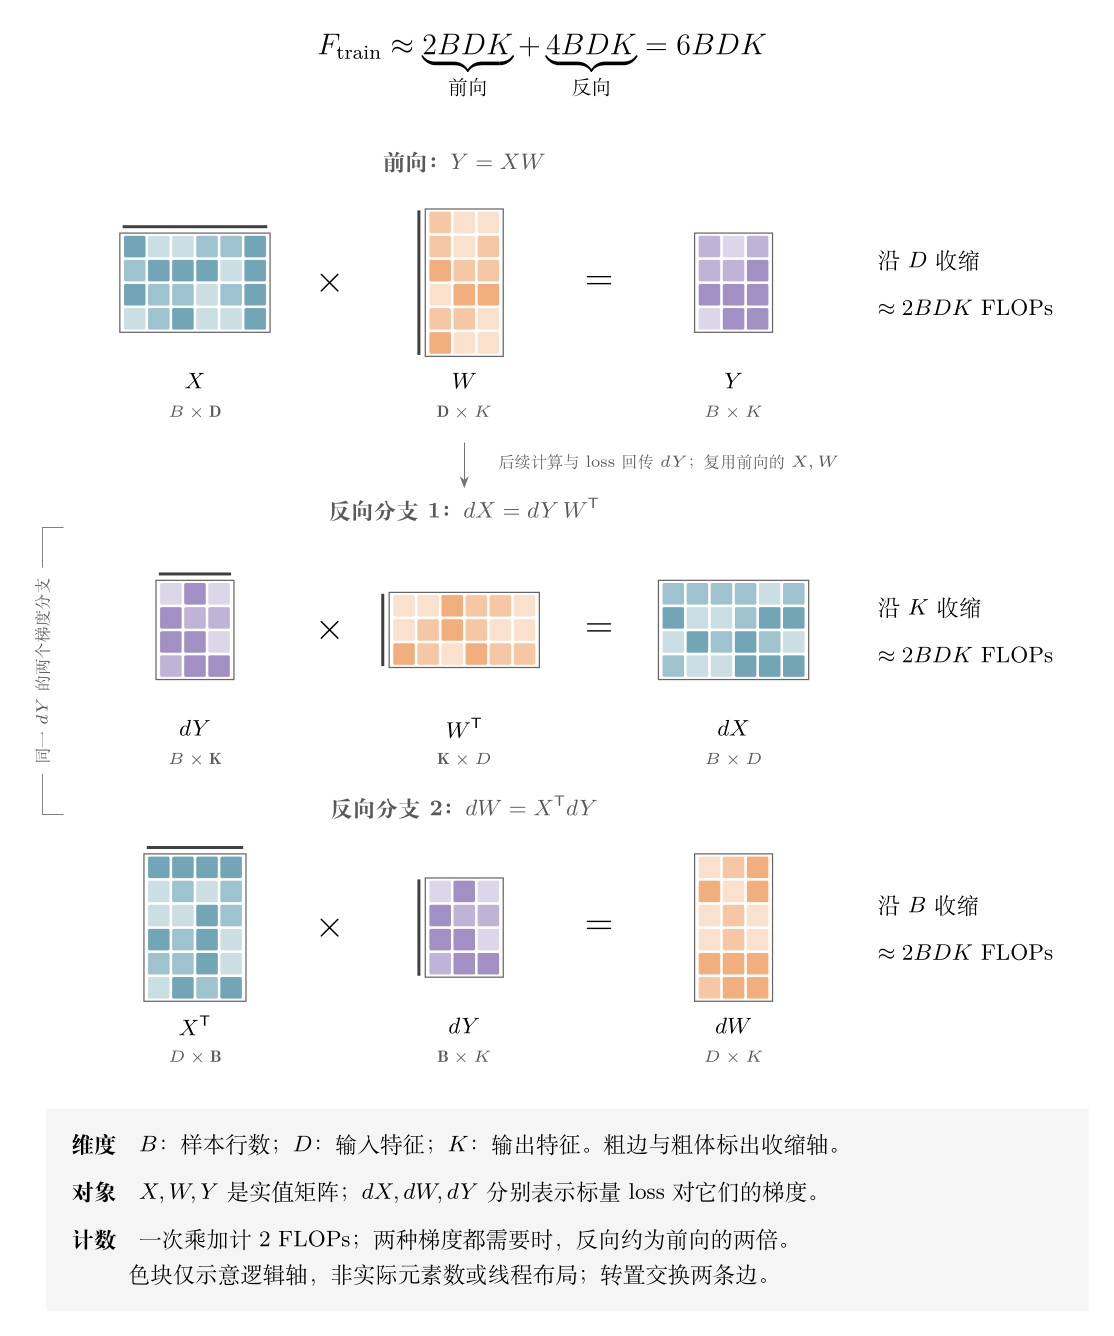
三行分别沿 $D$、$K$、$B$ 收缩,结果分别保留 $B\times K$、$B\times D$、$D\times K$。虽然矩阵方向变了,每行的计算量都约为 $2BDK$,于是“前向一次、反向两次 GEMM”合计约为 $6BDK$。两个反向分支共享 $dY$,并不表示先算 $dX$ 再用它算 $dW$;图中 $X^\top$、$W^\top$ 表示逻辑转置,也不要求显式复制一份转置矩阵。
这里假设输入梯度和权重梯度都需要,且不计 bias、激活、loss 和优化器更新。对于 Transformer 的逐 token 线性层,可以把 $[B,L,D]$ 的前两维合并为 $BL$ 行,图中的样本行数相应替换为 token 数 $BL$。
5.1 模型与张量形状
以两层线性模型为例:
x --w1--> h1 --w2--> h2 -> loss
维度设定:
- $x$: [B, D]
- $w_1$: [D, D]
- $w_2$: [D, K]
- $h_1 = x @ w_1$: [B, D]
- $h_2 = h_1 @ w_2$: [B, K]
- $loss = mean(h_2^2)$
5.2 前向 FLOPs
矩阵乘法 $(m \times n) @ (n \times p)$ 的 FLOPs 约为 $2mnp$。
- 第一层:$2BD^2$
- 第二层:$2BDK$
合计前向 FLOPs:
\[\text{Forward FLOPs} = 2B(D^2 + DK)\]5.3 反向 FLOPs(链式法则)
针对 $w_2$
- 计算 $w_2$ 梯度: $(D \times B) @ (B \times K)$ → $2BDK$
- 计算 $h_1$ 梯度: $(B \times K) @ (K \times D)$ → $2BDK$
合计: 反向 FLOPs(与 $w_2$ 相关)= $4BDK$
针对 $w_1$
- 计算 $w_1$ 梯度: $(D \times B) @ (B \times D)$ → $2BD^2$
- 若需 $x.grad$: $(B \times D) @ (D \times D)$ → $2BD^2$
合计: 反向 FLOPs(与 $w_1$ 相关,包含 $x.grad$)= $4BD^2$
若 $x$ 是不需要梯度的原始输入,可省略最后一项;若它是上游可训练层的输出,则通常仍需计算这个梯度以继续反传。因此,这个两层模型在不计算 $x.grad$ 时,前反向总量约为 $4BD^2+6BDK$,而不是 $6B(D^2+DK)$。
5.4 加总与“2/4/6 规则”
综合上述结果(包含 $x.grad$):
| 阶段 | FLOPs | 说明 |
|---|---|---|
| 前向 | $2 \times$ 数据点 × 参数数 | 单次推理 |
| 反向 | $4 \times$ 数据点 × 参数数 | 梯度计算与传播 |
| 总计 | $6 \times$ 数据点 × 参数数 | 一次训练迭代 |
最终得到著名的一阶估算公式:
\[\text{训练总 FLOPs} \approx 6 \times N_{\text{params}} \times N_{\text{tokens}}\]该经验公式来源于稠密线性层推导,是全参数训练常用的一阶估算。长序列时要补上第 3 节的 Attention 项;冻结参数或 MoE 稀疏激活时,要按实际参与的矩阵乘法重新统计,不能直接套用总参数量。
参考资料: The FLOPs calculus of language model training — Dzmitry Bahdanau, Medium