长上下文推理时,显存里除了模型权重,还要留出不断增长的 KV cache。注意力设计的一个核心问题,就是怎样减少历史状态的存储和读取,同时保留足够的表达能力。
本文先从 MHA、MQA、GQA 的头共享关系讲起,再看滑窗、状态空间模型和 MLA。它们改变的对象并不相同:头之间可以共享 K/V,token 之间可以减少连接,历史信息也可以改用 latent 或递归状态保存。文末按具体型号整理了近期模型的公开配置,核对日期为 2026-09-21。
1 从 MHA 看 KV cache 的成本
标准多头注意力(MHA)为每个头配置独立的 Q、K、V 投影。单个头的计算为:
\[\operatorname{Attention}(Q,K,V)=\operatorname{softmax}\!\left(\frac{QK^\top}{\sqrt{d}}+M\right)V,\]其中 $d$ 是每头维度,$M$ 是因果或 padding mask,softmax 沿 Key 位置归一化。不同头分别计算,输出拼接后再经过输出投影。MHA 是理解后续变体的起点,但不能据此把整个 LLaMA、Qwen 家族都归为 MHA:不同代际和规格会采用不同结构,具体例子见第 6 节。
自回归解码每次只产生少量新 token,却需要读取历史 K/V。设 batch 为 $B$、缓存长度为 $T$、KV 头数为 $H_{kv}$、K/V 每头维度均为 $d$、每元素占 $s$ 字节,单层缓存为:
\[\operatorname{Bytes}_{KV}=2BTH_{kv}ds.\]系数 2 分别对应 K 和 V。以 $B=1,T=32768,H_{kv}=32,d=128$、BF16 为例,单层就是 512 MiB;若 32 层都采用相同结构,则为 16 GiB。这还没有计入权重、临时激活和缓存管理开销。序列、并发和层数一起增长时,KV cache 就会成为实际的容量与带宽问题。
2 GQA / MQA:共享 K/V 的推理减法
MQA 和 GQA 保留多个 Query 头,通过减少 KV 头数来降低缓存量。同组 Query 使用相同的 K/V,但仍会产生各自的注意力分布。
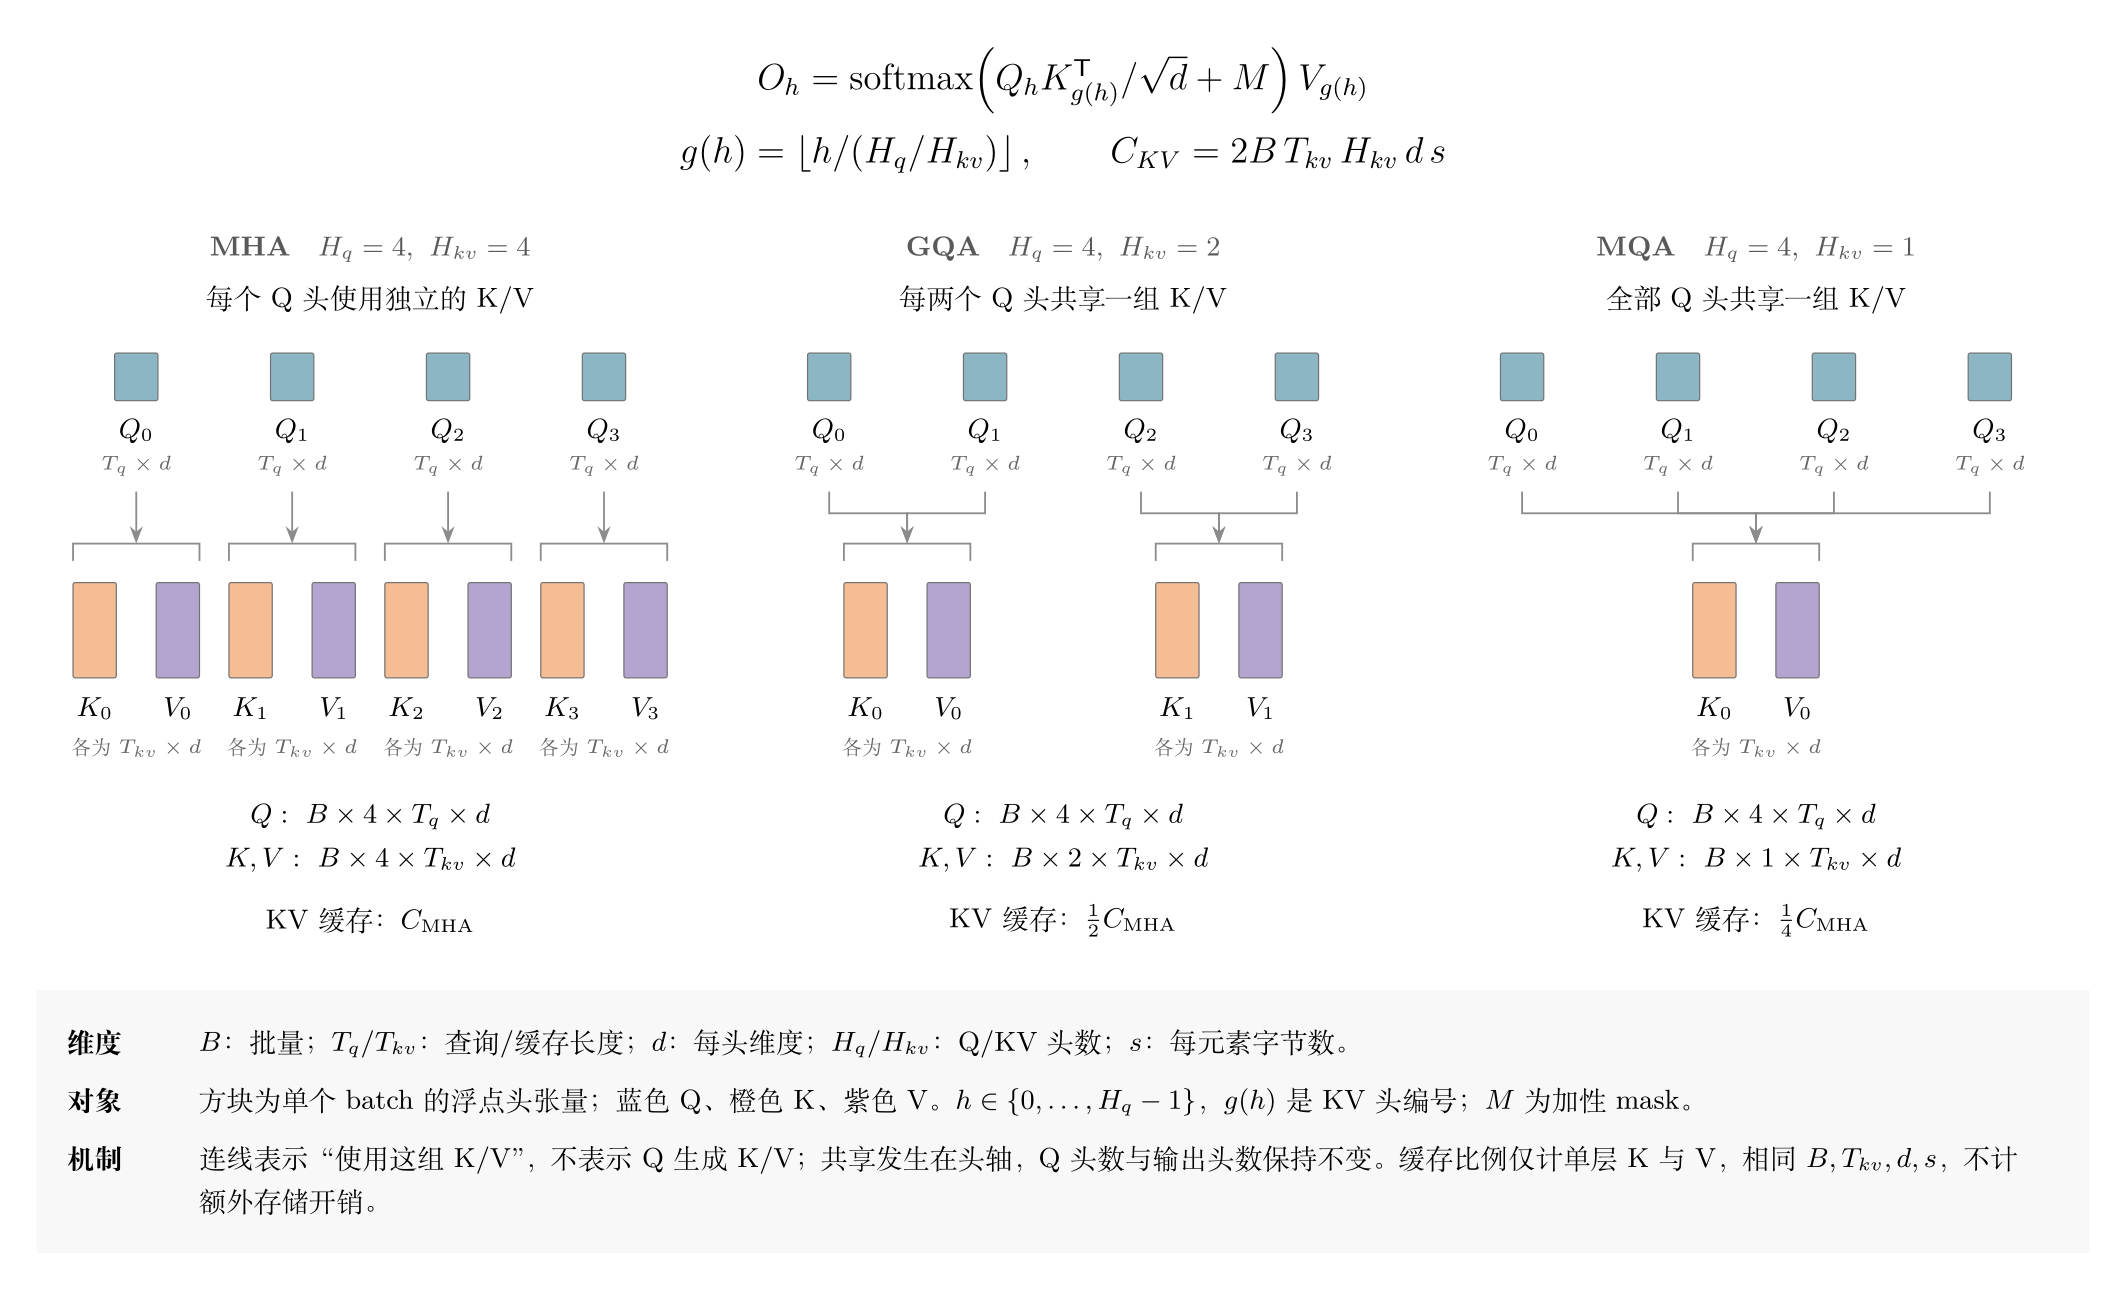
图中固定 $H_q=4$:MHA 为每个 Q 头配置独立的 K/V;GQA 示例让相邻两个 Q 头共享一组 K/V;MQA 则让全部 Q 头共享一组 K/V。连线表示使用关系,不表示由 Q 生成 K/V;即使共享 K/V,不同 Q 头仍分别计算注意力分数和输出。图中省略 batch 轴,方块高、宽分别表示序列轴和每头特征轴,长度仅作示意。
完整张量按 [batch, head, sequence, head_dim] 排列。设缓存长度为 $T_{kv}$、每头维度为 $d$、每元素占 $s$ 字节,单层 K 与 V 合计占用 $2BT_{kv}H_{kv}ds$ 字节。在其余条件相同时,缓存相对 MHA 的比例为 $H_{kv}/H_q$,因此图中的比例为 $1,1/2,1/4$;这不代表整个模型显存或推理耗时按相同比例下降。分组采用等大小、连续编号,要求 $H_q$ 能被 $H_{kv}$ 整除。结构依据:GQA 论文。
2.1 MQA:全部 Query 共享一组 K/V
MQA 取 $H_{kv}=1$。所有 Query 头共享一份 Key 投影和一份 Value 投影;K 与 V 仍是两个不同的对象,并不是共用同一个权重矩阵。缓存不再随 Query 头数增加,但仍随 batch、序列长度和层数增长。
共享 K/V 会约束各头可用的表示空间,但不意味着各头输出相同:不同的 Query 经过点积与 softmax 后,可以对同一组历史 Value 分配不同权重。质量与速度的取舍需要结合训练和实现评估,不能直接用一个固定的困惑度损失或加速倍数概括。
2.2 GQA:在头数与缓存之间选择分组
GQA 取 $1<H_{kv}<H_q$,每组 $H_q/H_{kv}$ 个 Query 头共享一组 K/V。这里要分清两个数字:num_key_value_heads 是 KV 组数,H_q/H_{kv} 才是每组 Query 的数量。组数等于 Query 头数时退化为 MHA,组数为 1 时就是 MQA。
沿用前面的算例,只改变 KV 头数,可以直接算出存储差异:
| 结构 | Q 头数 | KV 头数 | 每组 Q 头数 | 单层 KV cache |
|---|---|---|---|---|
| MHA | 32 | 32 | 1 | 512 MiB |
| GQA | 32 | 8 | 4 | 128 MiB |
| MQA | 32 | 1 | 32 | 16 MiB |
表中固定 $B=1,T=32768,d=128,s=2$,是理论存储量。减少 KV 读取有利于带宽受限的解码,但最终延迟还受 batch、kernel、并行方式和硬件影响,不能直接按缓存比例换算。
这些结构通常在模型训练时就已确定。已有 MHA checkpoint 也可以经过转换和继续训练得到 GQA;GQA 论文 给出了一条 uptraining 路径。它不是推理时随意合并几个头就能保持效果的开关。
3 稀疏 / 滑动窗口:改连接模式
另一条思路是不触碰 head,而是改「谁能注意谁」。减少每个 token 可以访问的位置,就能减少有效的注意力连接。逻辑上的可见性矩阵仍是 $N\times N$,计算和访存能省多少,还取决于实现是否真正跳过被屏蔽的位置。
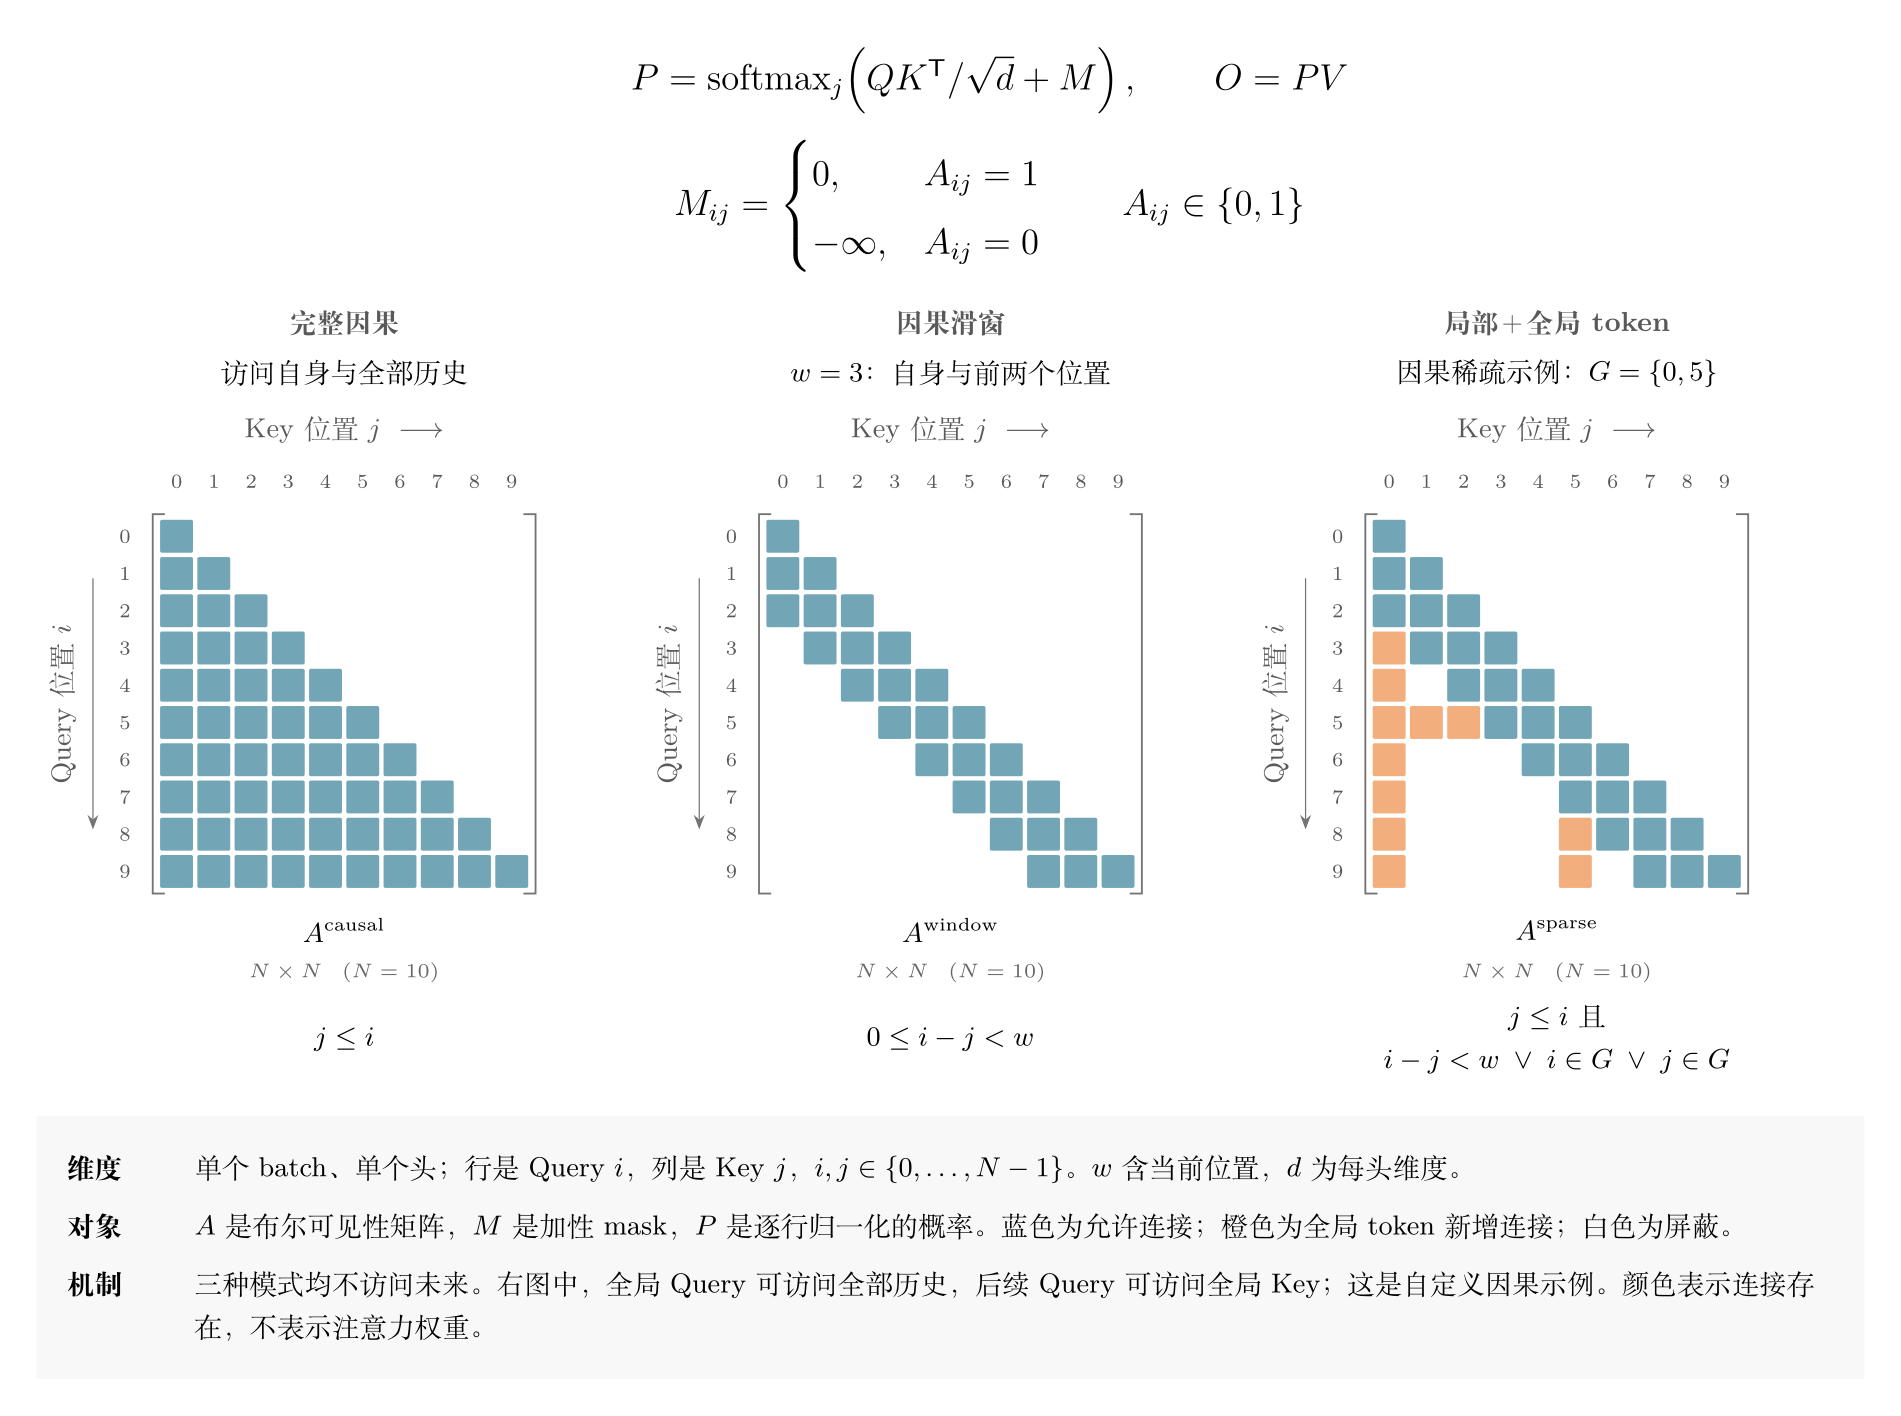
图中横轴为 Key 位置 $j$,纵轴为 Query 位置 $i$,每个有色格子表示该行可以访问该列,颜色不表示注意力权重。三张图都包含当前位置,并屏蔽未来:完整因果模式保留下三角;滑窗取 $w=3$,每个位置最多访问自己和前两个位置。例如第 $i=8$ 行,完整因果模式可以访问 $0\ldots8$,滑窗只保留 ${6,7,8}$。
右图在滑窗基础上指定全局 token 位置 $G={0,5}$:全局 Query 可访问全部历史,后续 Query 也可访问这些全局 Key。因此第 8 行还能访问位置 0 和 5;第 5 行则能访问 $0\ldots5$。橙色只标出超出滑窗的新增连接。这是用于解释机制的自定义因果示例;局部窗口与全局连接的组合可参考 Longformer,具体模型的全局位置及连接规则可能不同。
滑窗是一种具体的稀疏连接规则。固定窗口宽度 $w$ 后,单层有效连接数约为 $O(Nw)$;若再引入固定数量的全局位置,则增加相应的全局连接。要把这种结构转成实际收益,kernel 必须跳过不需要计算的部分,不能只是算完稠密分数后再填 mask。
头共享与滑窗可以同时使用。Mistral 7B v0.1 就结合了 GQA 与滑窗:前者减少每个位置存多少组 K/V,后者限制每个 Query 读取哪些历史位置。在因果解码中,窗口覆盖当前位置及其之前的 token;双向编码器则可以采用左右窗口。
缓存的释放策略也必须与连接模式一致。纯滑窗层可以回收窗口外的 K/V,采用 ring buffer 等方式复用存储;保留全局 token 的层,还要保存这些位置;完整全局注意力层则需要更长的历史。混合模型不能把所有层都按同一个窗口截断。跨层传播可以扩大信息的间接覆盖范围,但“通过中间表示传递”与“直接检索远处某个 token”仍是不同的能力。
4 状态空间与线性注意力:改变历史信息的保存方式
再往前一步,可以不再显式保留每个历史 token 的 K/V,而是让新输入更新一份递归状态。状态空间模型(SSM)走的就是这条路线:在固定模型配置下,解码状态的大小不必随着序列长度持续增长。不过,历史信息被汇入状态后,模型也不再拥有与完整注意力相同的逐 token 访问方式。
Jamba 是 Transformer 与 Mamba 混合的例子:部分层维护递归状态,部分层仍做注意力。估算这类模型的显存时,要分别计算状态层和注意力层,不能把“SSM 状态固定”推广成“整个模型没有 KV cache”。
近期的混合架构还包括线性注意力。例如 Qwen3.6-35B-A3B 每三个 Gated DeltaNet 层搭配一个 Gated Attention 层,后者使用 GQA。Gated DeltaNet 属于线性注意力,不应直接称为 Mamba;两者都能采用递归状态进行解码,但状态更新规则不同。
这也解释了为什么只问“一个模型用了哪种头”有时不够:还要继续看它的哪些层使用标准 attention,哪些层使用其他状态更新机制,以及各层如何管理缓存。
5 MLA:把历史 K/V 留在低维空间
GQA 减少的是 KV 头数。如果希望每个头仍能使用不同的 K/V 表示,又不想把所有头展开后的结果都放进缓存,可以换一个存储对象:保存能生成这些 K/V 的低维表示。这就是 DeepSeek 提出的 Multi-head Latent Attention(MLA)的核心思路。结构定义见 DeepSeek-V2 技术报告 §2.1。
5.1 一份 latent,生成各个头的 K/V
下面统一采用行向量、右乘权重的记法,与论文的列向量写法互为转置。设第 $j$ 个 token 的输入为 $x_j\in\mathbb{R}^{1\times D}$,先投影到宽度为 $r$ 的共享表示:
\[c_j=\operatorname{RMSNorm}(x_jW^{DKV}),\qquad W^{DKV}\in\mathbb{R}^{D\times r}.\]这里把官方 V3 实现中的 latent 归一化也写出来;后面的推导直接使用归一化后的 $c_j$,不会把这个非线性步骤合并进权重。每个头 $h$ 再通过自己的投影,得到内容 key 与 value:
\[k^C_{j,h}=c_jU^K_h,\qquad v_{j,h}=c_jU^V_h, \qquad U^K_h\in\mathbb{R}^{r\times d_c},\quad U^V_h\in\mathbb{R}^{r\times d_v}.\]上标 $C$ 表示内容分支,$d_c$、$d_v$ 分别是每头内容 key 与 value 的维度。所有头共享同一个 $c_j$,但 $U^K_h,U^V_h$ 不同,因此展开后的 K/V 仍可因头而异。这里的低秩结构是模型训练时学到的参数化方式,不是把任意现成 MHA 的缓存无损压缩一下。
不过,若每生成一个 token,都把历史 latent 重新展开成全部头的 K/V,缓存虽小了,计算和搬运却可能变多。接下来要解决的就是:能否直接对 latent 做 attention?
5.2 把 Key 投影移到 Query 侧
先只看内容打分。当前 token 为 $t$,第 $h$ 个头的内容 query 为 $q^C_{t,h}\in\mathbb{R}^{1\times d_c}$。利用矩阵乘法结合律:
\[q^C_{t,h}(k^C_{j,h})^\top =q^C_{t,h}(U^K_h)^\top c_j^\top =\widetilde q_{t,h}c_j^\top, \qquad \widetilde q_{t,h}=q^C_{t,h}(U^K_h)^\top.\]这一步把当前 query 变成 $1\times r$,随后直接与历史 latent 点积。$U^K_h$ 不再需要逐个作用于历史 token。注意这里是等价地改写 MLA 自己的计算,并没有近似 attention 分数。
Value 侧也可以把投影移到加权求和之后。设 $p_{t,h,j}$ 是最终的注意力概率,则:
\[o_{t,h}=\sum_{j\leq t}p_{t,h,j}(c_jU^V_h) =\left(\sum_{j\leq t}p_{t,h,j}c_j\right)U^V_h.\]因此先在 latent 空间求出 $z_{t,h}=\sum_jp_{t,h,j}c_j$,再恢复当前头的输出即可。最后仍按 head 拼接,经过输出投影 $W^O$。$U^V_h$ 还可与对应的输出投影块作代数合并,但具体是否合并,应由实现的计算代价决定。
5.3 RoPE 单独走一条分支
如果直接给内容 key 加 RoPE,位置相关的旋转矩阵会夹进上述乘法链。不同历史位置对应不同旋转,不能再靠一个与位置无关的投影,把它们统一移到当前 query 侧。
MLA 为此把内容与位置分开:$q^C,k^C$ 不旋转;另生成较短的 $q^R_{t,h},k^R_j$ 承载 RoPE,其中 $k^R_j$ 在所有头之间共享,宽度为 $d_R$。历史位置 $j$ 的位置 key 为:
\[k^R_j=\operatorname{RoPE}_j(x_jW^{KR}),\qquad W^{KR}\in\mathbb{R}^{D\times d_R}.\]把内容与位置两部分拼接后,点积自然分成两项。对当前 token 能访问的 $T$ 个位置,将 $c_j$ 堆成 $C\in\mathbb{R}^{T\times r}$,将 $k^R_j$ 堆成 $K^R\in\mathbb{R}^{T\times d_R}$,就得到图中的计算:
\[p_{t,h}=\operatorname{softmax}_{j}\!\left( \frac{\widetilde q_{t,h}C^\top+q^R_{t,h}(K^R)^\top}{\sqrt{d_c+d_R}} \right),\qquad o_{t,h}=(p_{t,h}C)U^V_h.\]这里是单 token 因果解码,缓存只包含截至当前位置的有效 token;批量 prefill 或带 padding 时还需加入相应 mask。分母沿用内容与位置拼接后的维度 $d_c+d_R$,不会因为代数变换改成 $r+d_R$;长上下文配置可能另有缩放修正。
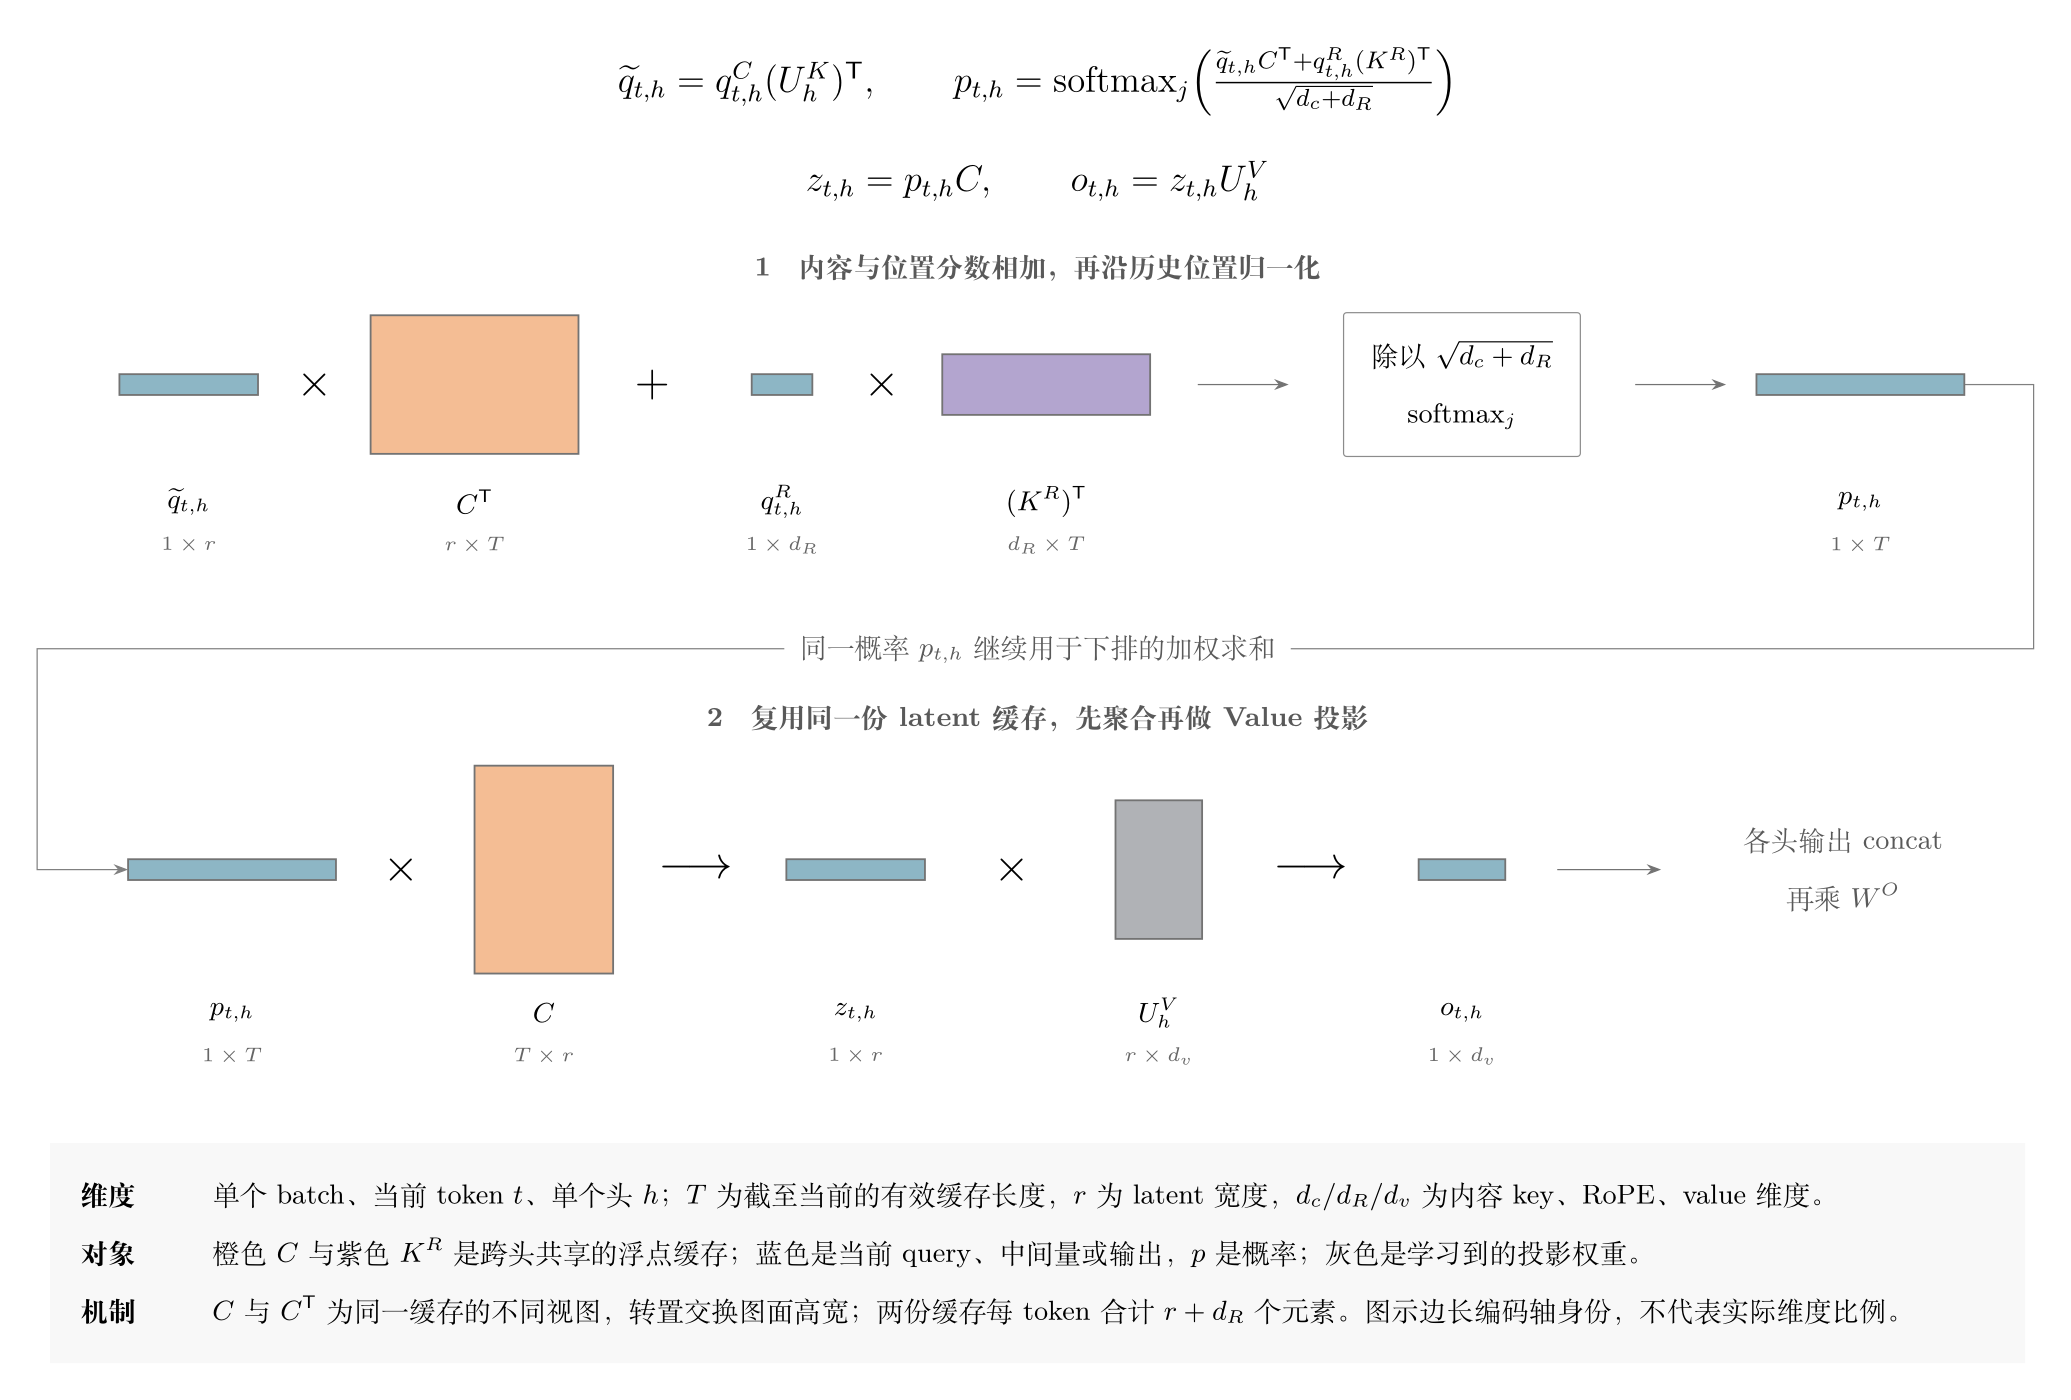
图中橙色 $C$ 在上排以转置形式参与打分,下排以原形状参与加权求和,是同一份缓存。紫色 $K^R$ 只贡献位置分数;两项分数相加之后才做一次 softmax。右侧箭头把上排得到的概率 $p_{t,h}$ 接到下排,最终产生当前头的输出。
在 DeepSeek-V3 官方 MLA.forward 实现 中,absorb 路径对应这套顺序:kv_cache 保存归一化后的 latent,pe_cache 保存旋转后的共享 key;q_nope 先乘 Key 投影权重,再与 kv_cache 打分。Query 自身也可以采用低秩投影,但不需要把历史 Query 留在 KV cache 中。
5.4 缓存到底省在哪里
设 batch 为 $B$,缓存长度为 $T$,每元素占 $s$ 字节。单层 MLA 的两份持久缓存分别是 $B\times T\times r$ 和 $B\times T\times d_R$,合计:
\[\operatorname{Bytes}_{MLA}=BT(r+d_R)s.\]这里没有额外的系数 2:$c_j$ 已经联合承载了内容 K 和 V,另一项是共享的 RoPE key。作为对照,若显式缓存每个头展开后的完整 K 与 V,元素数为 $BTH(d_c+d_R+d_v)$。
用 DeepSeek-V3 671B 官方配置 手算:$H=128,r=512,d_c=128,d_R=64,d_v=128$。每个 token、每层的 latent 缓存为 $512+64=576$ 个元素;逐头展开则为 $128\times(128+64+128)=40960$ 个元素。同精度下两者约相差 71.1 倍。例如 $B=1,T=32768$、缓存采用 BF16,每层分别约为 36 MiB 和 2.5 GiB。这是两种缓存布局的理论比较,不是与某个 GQA 模型的实测对比,也不代表推理速度提升相同倍数。
MLA 仍然需要沿历史位置计算注意力,latent 维度 $r$、额外投影以及 kernel 的实现都会影响速度。它与上一节的稀疏注意力改变了不同的对象:稀疏模式减少可见连接,MLA 则改变每个历史 token 的缓存表示。实际部署时,应同时看缓存容量、带宽和计算量。
延伸阅读:缓存与效果的极限拉扯:从 MHA、MQA、GQA 到 MLA。
6 近期模型分别用了什么
下面按 2026-09-21 核对的公开资料整理代表性型号,包含 2026 年模型与仍常见的上一代模型,不是完整排行榜。多模态模型这里只看语言主干;视觉编码器可能采用另一种注意力。Q/KV 表示 Query 头数与 KV 头数,不表示张量宽度。
| 具体模型 | 注意力类型 | 配置与需要区分的地方 | 官方依据 |
|---|---|---|---|
| Qwen3-32B | GQA | Q/KV = 64/8,每组 8 个 Q 头 | 配置 |
| Qwen3.5-397B-A17B | 线性注意力+GQA | layer_types 以三个线性层、一个完整注意力层交替;完整注意力 Q/KV = 32/2 |
配置 |
| Qwen3.6-35B-A3B | Gated DeltaNet+GQA | 每三个 DeltaNet 层搭配一个 Gated Attention 层;后者 Q/KV = 16/2 | 模型卡 |
| Gemma 4 E2B | MQA+局部/全局层混合 | Q/KV = 8/1;还使用跨层 KV cache sharing | 官方实现 |
| Gemma 4 E4B | GQA+局部/全局层混合 | Q/KV = 8/2;同样包含跨层缓存共享 | 官方实现 |
| Gemma 4 31B | GQA+局部/全局层混合 | Q 为 32;局部层 KV 为 16,全局层 KV 为 4;全局层另设 k_eq_v_global |
官方实现 |
| Mistral Small 3.2 24B | GQA | 语言主干 Q/KV = 32/8 | 配置 |
| Mistral Small 4 119B | MLA | 32 个 Q 头,KV latent 宽度 256,RoPE 宽度 64 | 参数、实现文档 |
| Kimi K2.6 | MLA | 64 个 Q 头,KV latent 宽度 512,RoPE 宽度 64 | 模型卡、配置 |
| DeepSeek-V3.2 | MLA+DSA 稀疏选择 | 保留 latent 结构,并加入 DeepSeek Sparse Attention;配置有 index_topk=2048 |
模型卡、配置 |
| DeepSeek-V4-Flash | 压缩混合注意力 | 官方定义为 CSA+HCA;配置 Q/KV = 64/1,并有滑窗与分层压缩比,不能仅用“普通 MQA”概括 | 模型卡、配置 |
MHA 也有明确例子,但要把代际写清楚。 初代 Gemma 7B 是 Q/KV = 16/16 的 MHA,同代 Gemma 2B 则是 8/1 的 MQA;这是 Google 官方配置 中可以直接核对的两个对照。它们是历史例子,不应包装成最新模型;同样不能因为初代用了 MHA,就推断后续 Gemma 都使用 MHA。
阅读配置时,对普通 attention,$H_{kv}=H_q$ 对应 MHA,$H_{kv}=1$ 对应 MQA,中间值对应 GQA。但这条判断有前提:如果配置还有 kv_lora_rank、qk_nope_head_dim 等 MLA 字段,或者分层的 layer_types、压缩参数,就必须继续看实际实现。例如 Kimi K2.6 的 num_key_value_heads 与 Q 头数相同,却使用 MLA,不能据这两个数字把它判成普通 MHA。
本文没有用推测给 GPT、Claude 等未在此核实头结构的闭源型号归类。对具体部署,最有用的信息是精确的 checkpoint、语言主干配置和推理实现,而不是模型家族名称。