1. 并行要解决的两个问题
把模型从一张卡搬到八张卡上,显存会变成原来的八分之一,训练也会快八倍吗?实际跑起来,往往两件事都没有这么简单:参数已经分片,激活仍可能 OOM;显存够用了,又可能有大量时间在等通信。
先把训练显存分成三部分:参数、梯度和优化器状态组成的模型状态;为反向传播保留的激活;以及当前算子、通信和内存分配所需的临时空间。ZeRO 主要减少第一部分,TP、SP、CP 和重计算还会改变第二部分。能否放下模型,要把三部分放在一起看。
放得下之后,问题才变成吞吐:每张卡分到多少计算,需要搬多少数据,这些通信能否与计算重叠。下面先算显存,再算通信,最后把两者放回 batch 和网络拓扑中讨论。推导以训练为主,推理中的 KV cache 不放进这套激活账本。
2. 统一符号与估算口径
| 符号 | 含义 |
|---|---|
| $s$ | 序列长度 |
| $b$ | 每个 DP 副本、每个 micro-batch 的序列条数;TP 组共享这些样本 |
| $m$ | 每次优化器更新、每个 DP 副本处理的 micro-batch 数 |
| $B$ | 每次优化器更新的全局序列条数,即 global batch size |
| $h$、$a$ | hidden size、Attention 头数 |
| $F$、$L$ | FFN 中间维度、Transformer 层数 |
| $d$、$t$、$p$ | 数据并行度、张量并行度、流水并行段数 |
| $N_\theta$ | 模型参数总元素数 |
| $q$ | 通信中每个元素的字节数;bf16/fp16 通常取 2 |
在每个 micro-batch 大小相同的情况下,
\[B=dmb,\qquad n=bs,\qquad U=dn=dbs.\]这里 $n$ 是一个 DP 副本单次 micro-batch 的 token 数,$U$ 是所有 DP 副本在这一轮 micro-batch 中处理的 token 总数;一次优化器更新处理 $mU=Bs$ 个 token。后面的 GEMM 和通信比较都按单次 micro-batch 计算,不能直接把包含梯度累积的 $Bs$ 填进去。
全文用 $M$ 表示字节数,用 $V$ 表示每卡发送的通信字节数。接收量通常与发送量相同,但不重复相加。激活公式中的 34、5 等系数已经包含 dtype 的字节数,不能再乘一次 $q$。矩阵及配图中的 $X$ 专门表示激活,不再兼任数据并行度。
3. 模型状态:ZeRO 分掉了什么,运行时又要搬回什么
3.1 从 Adam 的存储账本开始
Adam 为每个参数保存一阶、二阶动量。设参数和梯度各占 2 bytes,两份动量各占 4 bytes,暂不计 fp32 master weights,那么 DDP 每卡的模型状态就是
\[M_{\mathrm{DDP}}=(2+2+4+4)N_\theta=12N_\theta\quad\text{bytes}.\]ZeRO 逐步把优化器状态、梯度、参数沿 $d$ 张卡分片。按上述精度,静态存储可以直接写成下面这张表。ZeRO 原论文
| 方法 | 每卡参数 | 每卡梯度 | 每卡优化器状态 | 每卡合计(bytes) |
|---|---|---|---|---|
| DDP | $2N_\theta$ | $2N_\theta$ | $8N_\theta$ | $12N_\theta$ |
| ZeRO-1 | $2N_\theta$ | $2N_\theta$ | $8N_\theta/d$ | $4N_\theta+8N_\theta/d$ |
| ZeRO-2 | $2N_\theta$ | $2N_\theta/d$ | $8N_\theta/d$ | $2N_\theta+10N_\theta/d$ |
| ZeRO-3 / FSDP full shard | $2N_\theta/d$ | $2N_\theta/d$ | $8N_\theta/d$ | $12N_\theta/d$ |
如果实现还保存 fp32 master weights,DDP 再加 $4N_\theta$ bytes;若它随优化器状态分片,ZeRO 对应加 $4N_\theta/d$。梯度保留为 fp32 时,也要把梯度一列的 2 换成 4。这样比记住“每参数固定 12 或 16 bytes”更容易适配具体实现。
这张表描述保存状态的归属。ZeRO-3 在计算时还会临时聚合参数,因此 $12N_\theta/d$ 不能直接当作训练峰值显存。
3.2 同样是分片,FSDP 与 TP 的数据移动对象不同
DDP 在反向传播中按梯度 bucket 就绪触发 All-Reduce,让梯度通信尽量与后面的反向计算重叠。它通常不是等整个 backward 结束后,只发起一次通信。PyTorch DDP 原理
FSDP full shard 则在一个计算单元使用权重前 All-Gather 参数;若前向后释放完整权重,反向前还要再聚合一次。反向算出的梯度通过 Reduce-Scatter 求和并分片,随后各卡只更新自己负责的状态。计算单元的粒度由包装、分组和调度决定,不一定恰好是一层。FSDP 工作流程
这也解释了 FSDP 与 TP 的区别:FSDP 计算一个单元时会临时取得完整权重,处理本 DP 副本的输入;TP 每卡始终使用自己的权重分片,通过通信把各卡算出的激活或梯度组合起来。前者的主要通信量随参数规模增长,后者的主要通信量随 token 数和隐藏维度增长。后面“小 batch 为什么难扩展”的推导,就从这个差别出发。
4. TP 与 PP:同步通信和流水气泡分别怎么计算
4.1 TP:每层都要支付的通信成本
TP 把一个矩阵乘法分给多张卡同时做。例如 MLP 先把升维权重按列切分,再把降维权重按行切分,最后对各卡的部分和做 All-Reduce。常规 Megatron TP 在一层 Transformer 的 Attention 和 MLP 中,前向共做两次 All-Reduce,反向也做两次。Megatron-LM,§3.2
先统一一次 collective 的计量。记
\[\rho(k)=\frac{k-1}{k}.\]对一个完整大小为 $S$ bytes 的张量,ring All-Reduce 每卡发送约 $2S\rho(k)$ bytes;Reduce-Scatter 和 All-Gather 各发送 $S\rho(k)$ bytes。这里的 2 来自归约、收集两个阶段;All-Gather 的 $S$ 指聚合后的完整大小。NCCL 通信量说明
每次 TP All-Reduce 处理的激活有 $bsh$ 个元素,因此每卡、每层、每个 micro-batch 的前向加反向通信量为
\[V_{\mathrm{TP,layer}} \approx 4\times 2qbsh\rho(t) =8qbsh\rho(t)\quad\text{bytes}.\]取 bf16 时 $q=2$。如果只写 $8bsh\rho(t)$,单位就是元素数。这一估算针对常规 TP,不包含 SP 为恢复保存分片而增加的通信。
TP 没有 PP 的流水填充、排空气泡,但 collective 仍可能让计算等待。增大 $t$ 会缩小每卡的 GEMM,却不会让上述通信量按 $1/t$ 下降,所以 TP 通常优先放在带宽高、延迟低的机内链路上;是否继续增大 $t$,要看释放的显存和增加的通信能否换来收益。
4.2 PP:先分清气泡开销比与气泡占比
PP 把 $L$ 层分为 $p$ 个 stage,每个 stage 持有其中一段。相邻 stage 在前向发送激活,在反向发送激活梯度。若 stage 边界的完整张量形状为 $b\times s\times h$,每个边界、每个 micro-batch 的双向数据合计约为 $2qbsh$ bytes;若边界张量还由 TP/SP 分片,则继续按实际分片计量。
通信只发生在 stage 边界,代价是流水线需要填充和排空。在各 stage 耗时均衡、忽略通信、采用非交错的同步流水调度时,设一个 stage 的前向、反向耗时分别为 $\tau_f,\tau_b$,有
\[T_{\mathrm{useful}}=m(\tau_f+\tau_b),\qquad T_{\mathrm{bubble}}\approx(p-1)(\tau_f+\tau_b).\]因此,两种常见写法分别是
\[\frac{T_{\mathrm{bubble}}}{T_{\mathrm{useful}}}\approx\frac{p-1}{m}, \qquad \frac{T_{\mathrm{bubble}}}{T_{\mathrm{total}}}\approx\frac{p-1}{m+p-1}.\]前一个是相对有效计算时间的额外开销,后一个才是总时间中的气泡占比。比如 $p=8,m=32$,两者分别约为 21.9% 和 17.9%。Megatron-LM 的流水模型
增加 $m$ 可以摊薄一次迭代的填充、排空开销,但还要满足 $B=dmb$。固定全局 batch 时,$m$ 与 $b$ 需要一起调整;把 micro-batch 切得过小,又会降低单次 GEMM 的效率。PP 的调参因此同时涉及流水利用率和单卡计算效率。
5. 激活显存:34 和 5 是怎样加出来的
模型状态分片以后,长序列训练仍可能被激活卡住。要解释这件事,先固定一套可以逐项核对的结构:经典 MHA、$h\rightarrow4h\rightarrow h$ 的 GeLU MLP、每层两次 LayerNorm;浮点激活按 2 bytes、Dropout mask 按 1 byte 保存,不做激活重计算,并显式保存 Attention 概率相关张量。下面沿用 Reducing Activation Recomputation in Large Transformer Models,§4 的账本,忽略 bias、LayerNorm 统计量等较小项。
这些前提给出的,是一个 micro-batch、每卡每层为反向保留的激活字节数。先看没有模型并行时,为什么会得到
\[M_{\mathrm{act}}=34sbh+5bas^2 =sbh\left(34+5\frac{as}{h}\right).\]5.1 二次项:三个保存对象合起来是 5 bytes
MHA 中每个头的 Attention 概率矩阵有 $s\times s$ 个位置,全局形状为 $(b,a,s,s)$。在这套实现中,Softmax 输出保存 $2bas^2$ bytes,Attention Dropout 的 mask 保存 $bas^2$ bytes,Dropout 输出还要为后续乘 $V$ 保留 $2bas^2$ bytes,于是
\[M_{\mathrm{quadratic}}=(2+1+2)bas^2=5bas^2.\]所以 5 汇总的是不同 dtype 的三个对象,不表示每个位置存了五个 bf16 元素,也不要求再把原始 logits 单独算进去。其余参数固定时,序列长度翻倍,这部分保存量就变成四倍。
取 $b=1,a=32,s=32768$,可以直接算出
\[5bas^2=5\times32\times32768^2 \approx1.718\times10^{11}\ \text{bytes} =160\ \text{GiB}.\]约 172 GB,而且只是一层的二次项。这个算例说明,32K 训练中显式保存这些矩阵很快就会超过单卡容量,必须改变保存或计算方式。
5.2 线性项:Attention、MLP 和 LayerNorm 分别占多少
Attention 里与序列长度线性相关的部分,包括 QKV 投影共享的输入、Q/K/V 本身、输出投影的输入,以及模块输出处的 Dropout mask。按上述精度,它们依次贡献
\[M_{\mathrm{attn,linear}} =(2+4+2+2+1)sbh=11sbh.\]这里 $4sbh$ 是 Q、K 两份,紧接着的 $2sbh$ 是 V;与 $s^2$ 相关的 Attention Dropout 已经放在上一节。
MLP 的第一个 Linear 保存输入,占 $2sbh$;GeLU 保存其 $4h$ 宽的输入,占 $8sbh$;第二个 Linear 保存 GeLU 输出,再占 $8sbh$;模块输出处的 Dropout mask 占 $sbh$。因此
\[M_{\mathrm{MLP}}=(2+8+8+1)sbh=19sbh.\]两次 LayerNorm 各保存一个 $b\times s\times h$ 的输入,合计 $4sbh$。把三部分相加,线性系数就是
\[34=11+19+4.\]换成 GQA、SwiGLU 或融合内核时,要按实际的头数、中间宽度与保存对象重算。这里真正可复用的是“形状 × dtype 字节数 × 保存份数”的方法,而不是把 34 当成所有 Transformer 都适用的常数。
6. TP、重计算、SP 与 CP 分别改变哪部分激活
6.1 TP 为什么还剩下不缩小的 $10sbh$
将前面的线性账本按保存归属重新分组,就能得到 TP 公式。两次 LayerNorm 的输入占 $4sbh$,Attention 和 MLP 模块输出处的 Dropout mask 占 $2sbh$,QKV 投影与 MLP 第一个 Linear 的输入占 $4sbh$。常规 TP 每卡仍保存这些完整副本,合计 $10sbh$。
其余 $24sbh$ 的线性激活跟随 head 或 FFN 通道分片;Attention 概率相关对象按 head 分片,每卡只保留 $a/t$ 个头。在可均分的前提下,
\[M_{\mathrm{TP}}=10sbh+\frac{24sbh}{t}+\frac{5bas^2}{t}.\]TP 减少的是每卡的头数,每个头的 $s\times s$ 矩阵仍然完整。因此,不断增加 $t$ 只能压缩后两项,最后会遇到 $10sbh$ 这块不变的底座。它来自当前的复制策略;LayerNorm 虽然需要每个 token 的完整 $h$,不同 token 之间仍可独立计算,这就是 SP 能继续分片的原因。原论文,§4.2
6.2 选择性重计算与 FlashAttention:减少保存的二次项
选择性重计算不长期保存 Attention 核心区域的若干中间结果,反向需要时再从保留的输入恢复。按原论文的近似账本,移去主要的二次存储项后,得到
\[M_{\mathrm{TP+selective}}\approx sbh\left(10+\frac{24}{t}\right).\]这表示保存策略变了,不是数值上把 $5as/h$ 近似成了 0。普通 Attention 即使做重算,执行时仍可能临时生成完整的 $s\times s$ 张量。
FlashAttention进一步改变了计算方式:通过分块和在线 Softmax 避免将完整 Attention 矩阵写入 HBM,并在反向中重算所需块。它同样消除了主要的二次保存开销,但会保留 Q/K/V、输出和归一化统计等线性大小的状态。两者都能缓解长序列的激活压力,具体线性系数则取决于实现。
6.3 Sequence Parallel(SP):把顽固的 “10” 也按序列切开
SP 复用同一组 $t$ 张 TP 卡,把每卡在这些区域负责的序列缩短为 $s/t$,每个 token 仍保留完整的 $h$ 维。原本在行并行输出端执行的 All-Reduce,可以拆成两个边界上的通信:
- 先用 Reduce-Scatter 跨卡求和,再沿序列维分发结果;每卡在自己的 token 上做 Dropout、残差和 LayerNorm。
- 进入下一个 TP 计算块时,用 All-Gather 沿序列维拼回完整输入,再执行列并行 GEMM。
沿用 TP 激活显存图 的符号和配色,下面只展开蓝绿色的重复激活。这里具体取 LayerNorm 输出、下一列并行 Linear 的输入为 $X$;第 $r$ 张卡保留 $X_r=X[:,\mathcal I_r,:]$,其中 $\mathcal I_r$ 是它负责的序列区间。
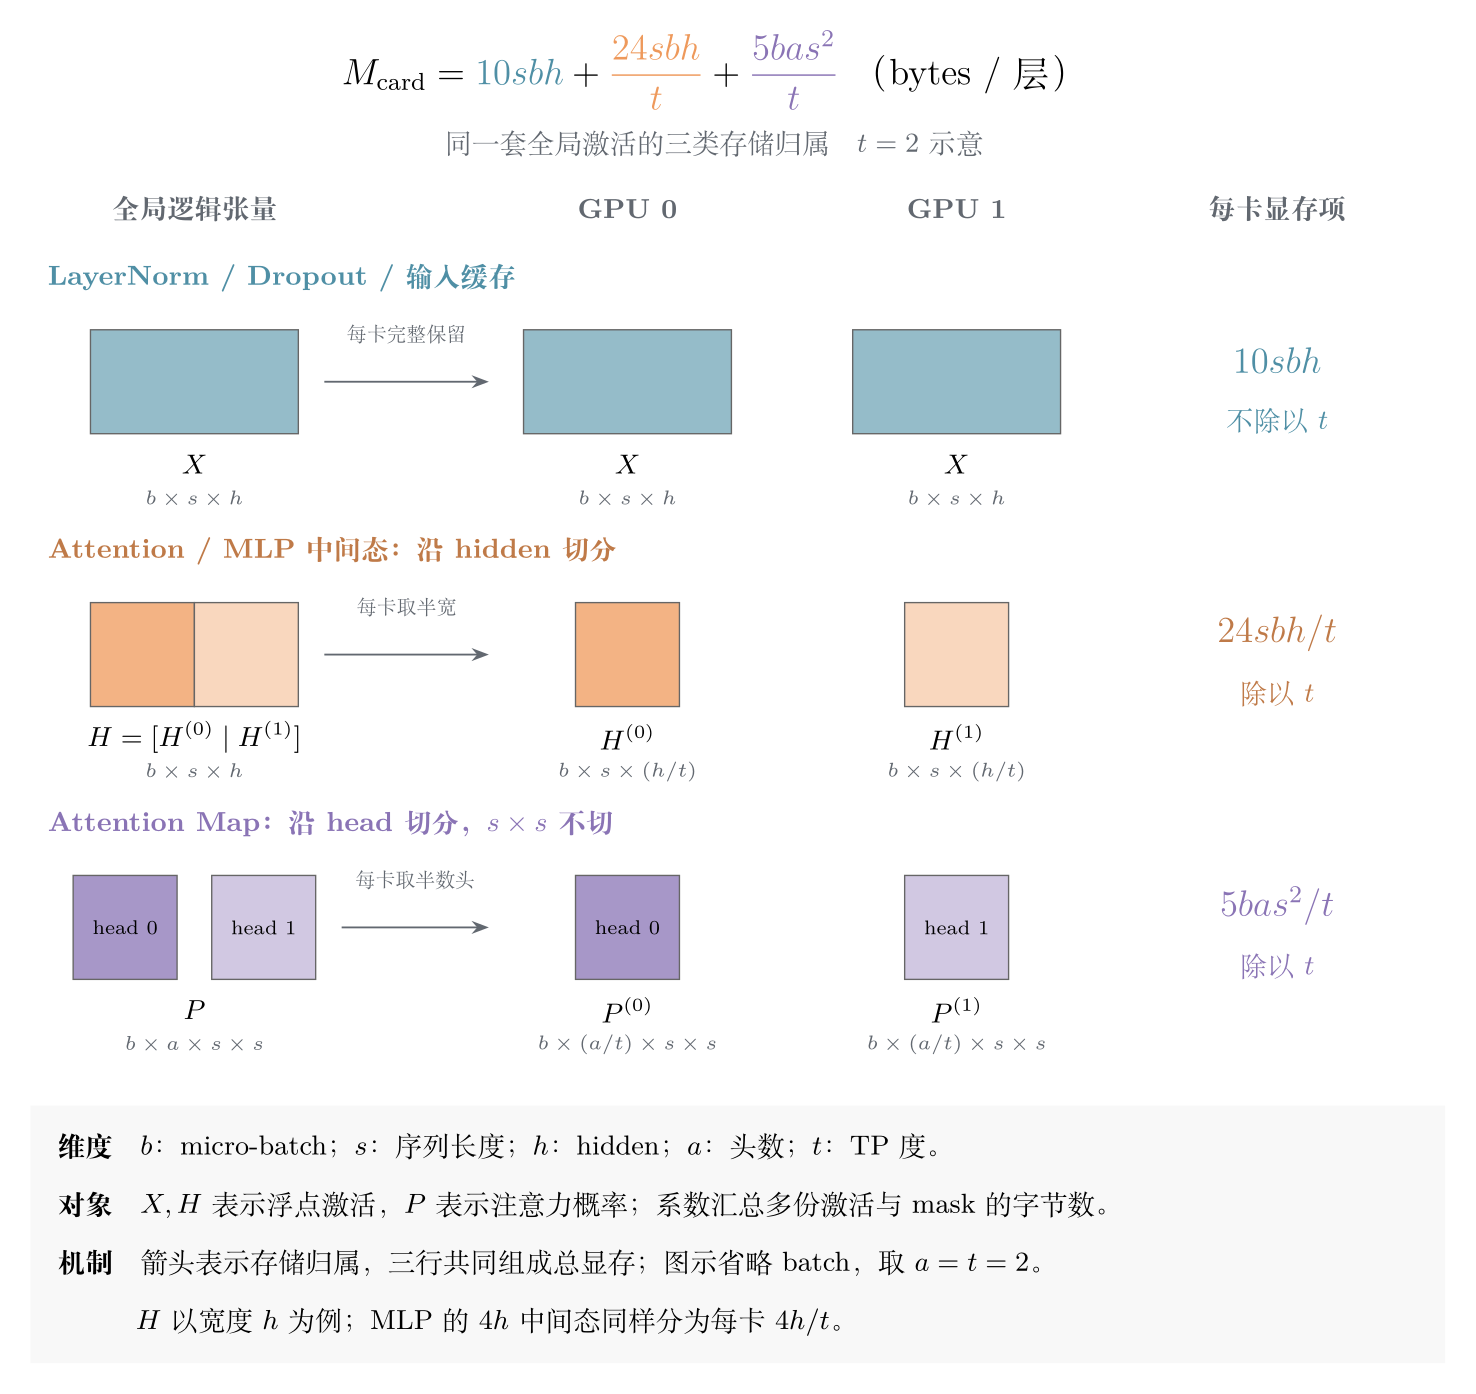

看中间一列,张量的高度从 $s$ 变成 $s/t$,宽度仍是 $h$。右侧虽然又出现了完整 $X$,但它只供当前计算使用,用完即可释放;为反向长期保留的是 $X_r$,计算权重梯度需要完整输入时再聚合。LayerNorm 输入和相关 Dropout mask 也按序列保存,于是这些缓存合计的 $10sbh$ 变为 $10sbh/t$。原图中橙色 $H$ 和紫色 $P$ 所对应的两项继续沿用 TP 分片,不再额外除以 $t$。
按 ring 通信模型,边界上的 Reduce-Scatter + All-Gather 与 All-Reduce 的基础数据量等价。为避免保存完整 GEMM 输入,原论文第 4.2.2 节还在反向增加了 All-Gather,并将其与输入梯度计算重叠,因此“不增加通信量”只适合描述前面的边界替换。图中只画这一类缓存的代表张量,公式统计的是前面账本里的全部保存激活。
因此 TP + SP 的激活公式变为: \(\text{Activations} = sbh \left( \frac{34}{t} + 5\frac{as}{ht} \right)\)
如果再叠加前一节的选择性重计算,在同一存储口径下有: \(\text{Activations} \approx sbh \left( \frac{34}{t} \right)\)
这就是原论文中“保存激活随并行度线性缩放”的含义。使用 FlashAttention 时,也应按实际内核保留的张量重新统计线性系数。
6.4 CP 与 Ulysses:把长序列分给更多设备
Megatron SP 在同一 TP 组的部分算子区域按序列分片,进入 TP 计算区域时还会聚合完整序列。CP 则引入独立的上下文并行组,让各卡在更多计算阶段持续负责不同的 token;本地的 Linear、MLP 不需要因 CP 额外通信,而 Attention 必须取得其他序列片段的信息。Megatron CP 说明
取得远端信息有不同做法:可以聚合 K/V,也可以沿环传递 K/V 块并逐块计算 Attention。Ulysses 使用另一条路线,通过 All-to-All 在“完整 head、部分序列”和“部分 head、完整序列”之间转换布局。
以不叠加 TP 的 MHA 为例,设 CP/Ulysses 组大小为 $c$、每头维度为 $d_h=h/a$。Q/K/V 在 Attention 前通过一次 All-to-All,从每卡 $(b,a,s/c,d_h)$ 变为 $(b,a/c,s,d_h)$;Attention 输出再通过一次 All-to-All 转回序列分片。因此一次前向共两次 All-to-All。基本等分方案要求 $a$ 能被 $c$ 整除,GQA 或与 TP 叠加时还要考虑本地 Q/KV 头的分配约束。Ulysses 设计
这与 SP 处理的重复激活是不同层面的划分。CP 可以与 TP、SP 组合,但 Attention 采用聚合、环式交换还是 All-to-All,会影响临时缓冲和通信方式,不能只在上一节公式外再机械地除一个 $c$。
6.5 对照同一套激活账本
| 配置 | 每卡每层保存的激活(bytes) |
|---|---|
| 无模型并行 | $sbh(34+5as/h)$ |
| TP | $sbh(10+24/t+5as/(ht))$ |
| TP + SP | $sbh(34/t+5as/(ht))$ |
| TP + 选择性重计算 | $sbh(10+24/t)$ |
| TP + SP + 选择性重计算 | $34sbh/t$ |
表中采用第 5 节的结构和存储口径;最后两行省略了较小的保存项。FlashAttention 和 CP 需要结合具体实现单独计量。
把单层结果扩展到训练峰值,还要看一张卡同时保留了多少层、多少个尚未完成反向的 micro-batch。没有 PP、只保留一个 micro-batch 时,可以先用 $L M_{\mathrm{act}}$ 估算;有 PP 时,每卡层数减少,但多个 micro-batch 的激活会同时存活,数量由调度决定。最后还要加上模型状态、当前权重聚合和算子缓冲,才能判断容量是否够用。
7. Batch size scaling:为什么不同并行方式对 batch 的反应不同
7.1 从两次 Linear 重推计算量与通信量
为了把差别算清楚,这一节只取 $h\rightarrow F\rightarrow h$ 的两层 MLP,暂不计 Attention、bias、逐元素运算和重计算。一轮 micro-batch 的全组输入有 $U$ 个 token。一次 Linear 的前向需要 $2UhF$ FLOPs,两次合计 $4UhF$;反向分别计算输入梯度、权重梯度,需要约 $8UhF$ FLOPs。
若同时使用 $d$ 路 DP/FSDP 和 $t$ 路 TP,每张卡处理 $n=U/d$ 个 token、每个 Linear 的 $1/t$ 权重,因此
\[\mathrm{FLOPs}_{\mathrm{fwd}}=\frac{4UhF}{dt},\qquad \mathrm{FLOPs}_{\mathrm{bwd}}=\frac{8UhF}{dt}.\]通信继续沿用第 4 节的 ring 发送量口径。为使各行可直接比较,这里统一假设参数、梯度、激活通信都采用 $q$ bytes;每个 micro-batch 都同步梯度。TP 使用复制的边界输入,保留 Linear 反向所需输入,不启用 SP;FSDP 在前向后释放完整参数,反向重新聚合。
两次 Linear 总共有 $2hF$ 个参数。DP 反向做梯度 All-Reduce,发送量为 $2\times q(2hF)\rho(d)$。FSDP 前向做一次完整权重的 All-Gather,反向再做权重 All-Gather 和梯度 Reduce-Scatter,所以前后向发送量分别为 $q(2hF)\rho(d)$ 和 $2q(2hF)\rho(d)$。这些是两层权重各自 collective 的合计。
TP 则在一个 MLP 的前向和反向各有一次 All-Reduce,每次处理 $nh$ 个元素。混合方案把这两类通信相加,其中 FSDP 只聚合当前 TP rank 的 $2hF/t$ 个参数:
| 策略 | 每卡前后向 FLOPs 合计 | 前向发送量(bytes) | 反向发送量(bytes) |
|---|---|---|---|
| DP,$t=1$ | $12UhF/d$ | $0$ | $4qhF\rho(d)$ |
| FSDP,$t=1$ | $12UhF/d$ | $2qhF\rho(d)$ | $4qhF\rho(d)$ |
| TP,$d=1$ | $12UhF/t$ | $2qUh\rho(t)$ | $2qUh\rho(t)$ |
| FSDP + TP | $12UhF/(dt)$ | $2qUh\rho(t)/d+2qhF\rho(d)/t$ | $2qUh\rho(t)/d+4qhF\rho(d)/t$ |
令 $t=1$,混合行就退化为 FSDP;令 $d=1$,它就退化为纯 TP。这也说明前后向 TP 通信项为什么相同:两边都只有一次同样大小的 All-Reduce。若改变输入保存策略、打开 SP 或增加重计算,就应把新增 collective 另计,而不是只改表中的一个系数。
7.2 计算量除以通信量,才能解释曲线
定义 $\mathcal I=\mathrm{FLOPs}/V$,表示每发送一个字节对应多少计算。对 FSDP 和 TP,前后向合计分别给出
\[\mathcal I_{\mathrm{FSDP}}=\frac{2n}{q\rho(d)},\qquad \mathcal I_{\mathrm{TP}}=\frac{3F}{qt\rho(t)}.\]FSDP 每次搬的参数、梯度大小基本固定,$n$ 越大,每次通信可以对应越多计算;TP 搬的是激活,计算量与通信量都随 token 数增长,所以这个简化模型下的比值与 batch 无关。混合方案则是
\[\frac{1}{\mathcal I_{\mathrm{FSDP+TP}}} =\frac{q\rho(d)}{2n}+\frac{qt\rho(t)}{3F}.\]这个式子把两种限制放在了一起:增大 $n$ 能摊薄 FSDP 的权重通信,但 TP 那一项仍在。固定 $d,t$ 时,混合方案的比值会逐渐接近 TP 所决定的平台;如果每个 batch 都重新选择 $d,t$,得到的则是不同配置的性能包络。
比较不同策略时,应固定总卡数和总工作量。例如不使用 PP/CP,设 $N=dt$,全组 token 数为 $U$:纯 FSDP 每卡处理 $U/N$ 个 token,纯 TP 每卡参与全部 $U$ 个 token 的分片计算。不能把两者的每副本 $n$ 固定成一样,再称为同一 workload 的比较。

图源为 How to Scale Your Model:Combining FSDP and Tensor Parallelism 的现行原图。它是 TPU v5p 的 $4\times4\times4$ mesh、FFN 宽度约 30K 下的模型估计。原图把全组 token 数记为 $B$,因此横轴 $B/N$ 对应本文的 $U/N$;图内 100、850 的简写也应按这个横轴理解。绿色曲线允许随 batch 调整混合并行配置。
纵轴是计算时间与通信时间之比,不是实测吞吐或 MFU。若暂用统一的计算吞吐 $\Pi$、网络带宽 $\beta$,该比值约为 $\mathcal I\beta/\Pi$。源图采用 TPU 的网络与分片模型,不能用上面的 ring 表直接复现其阈值;它说明的是 batch 增长时,固定权重通信更容易被计算覆盖这一趋势。
因此,“小 batch 更偏向模型并行”应理解为:在固定总 token 数、固定设备数时,减少 DP 度、引入适量 TP,可能改善每卡计算与通信的比例。它不是 batch 小就一定要开 TP,更不是把 TP 度拉满就一定更快。小矩阵效率、消息延迟和不同并行组的链路带宽,都可能改变最终结果。
7.3 梯度累积改变什么
增大 $m$ 会增加一次更新的全局 batch $B=dmb$,但单次 GEMM 的 token 数仍然是 $n=bs$。如果问题来自 micro-batch 太小,单纯多跑几次同样的小 GEMM,并不会把它们变成一次大 GEMM。
梯度累积可以通过延后同步摊薄一部分通信。例如 DDP 配合 no_sync(),可以在前 $m-1$ 次只累积本地梯度,最后一次再同步。但 FSDP 的参数聚合、TP 的激活通信仍然要配合各次计算发生;延后梯度同步还可能改变峰值显存。PyTorch 的梯度累积与同步说明
所以调参时要分别看 $b$ 和 $m$:前者影响单次计算尺寸,后者满足更新所需的全局 batch,并在 PP 中影响流水填充开销。
8. 把公式用于并行组合
8.1 先满足容量,再安排通信和拓扑
先按实际精度估算模型状态,再看单层激活和调度中同时存活的 micro-batch。模型状态占主导时,ZeRO/FSDP 可以先减少副本;长序列激活占主导时,应结合 FlashAttention、SP、重计算和 CP;单个计算块过大时,TP 才能直接缩小每卡的矩阵与中间计算。
需要 TP 时,优先将同组 GPU 放在机内高速互联上,但 TP 度以显存和效率为准。达到容量要求后继续增加 TP,可能因为 GEMM 变小、同步变多而得不偿失。跨节点可以用 PP 分层,代价是 stage 均衡和气泡;CP 则需要围绕 Attention 的 KV 交换或 All-to-All 评估网络,不能直接套用 PP 的通信判断。Megatron-LM 对并行组合的分析
对于不含 CP、EP 的基本 3D 并行,设备数为 $N=dtp$。选择 $t,p$ 后,剩余设备用于扩大 $d$,同时检查 $B=dmb$ 是否还能给每个副本足够大的 micro-batch。这比固定执行“先开满机内 TP,再加 PP”的顺序更贴近前面的成本模型。
8.2 重计算省出的显存怎样换成吞吐
重计算增加了工作量,却可能提高整机吞吐。若把一次前向成本记为 $C_f$、反向近似记为 $2C_f$,完整重做一次前向会让总计算从 $3C_f$ 变为 $4C_f$,额外 FLOPs 约为三分之一。这是算术近似,执行时间还取决于算子、通信和调度。
省下的显存可以用于更大的 micro-batch,也可以让更多 micro-batch 同时在流水中推进。两条收益要分开看:增大 $b$ 可能改善 GEMM 效率;在 $b$ 固定且允许增大全局 $B$ 时,增大 $m$ 可以减小气泡占比 $(p-1)/(m+p-1)$。若全局 $B$ 固定,单纯增大 $b$ 反而会减小 $m$,所以不能把“更大的 batch”笼统等同于“更少的气泡”。
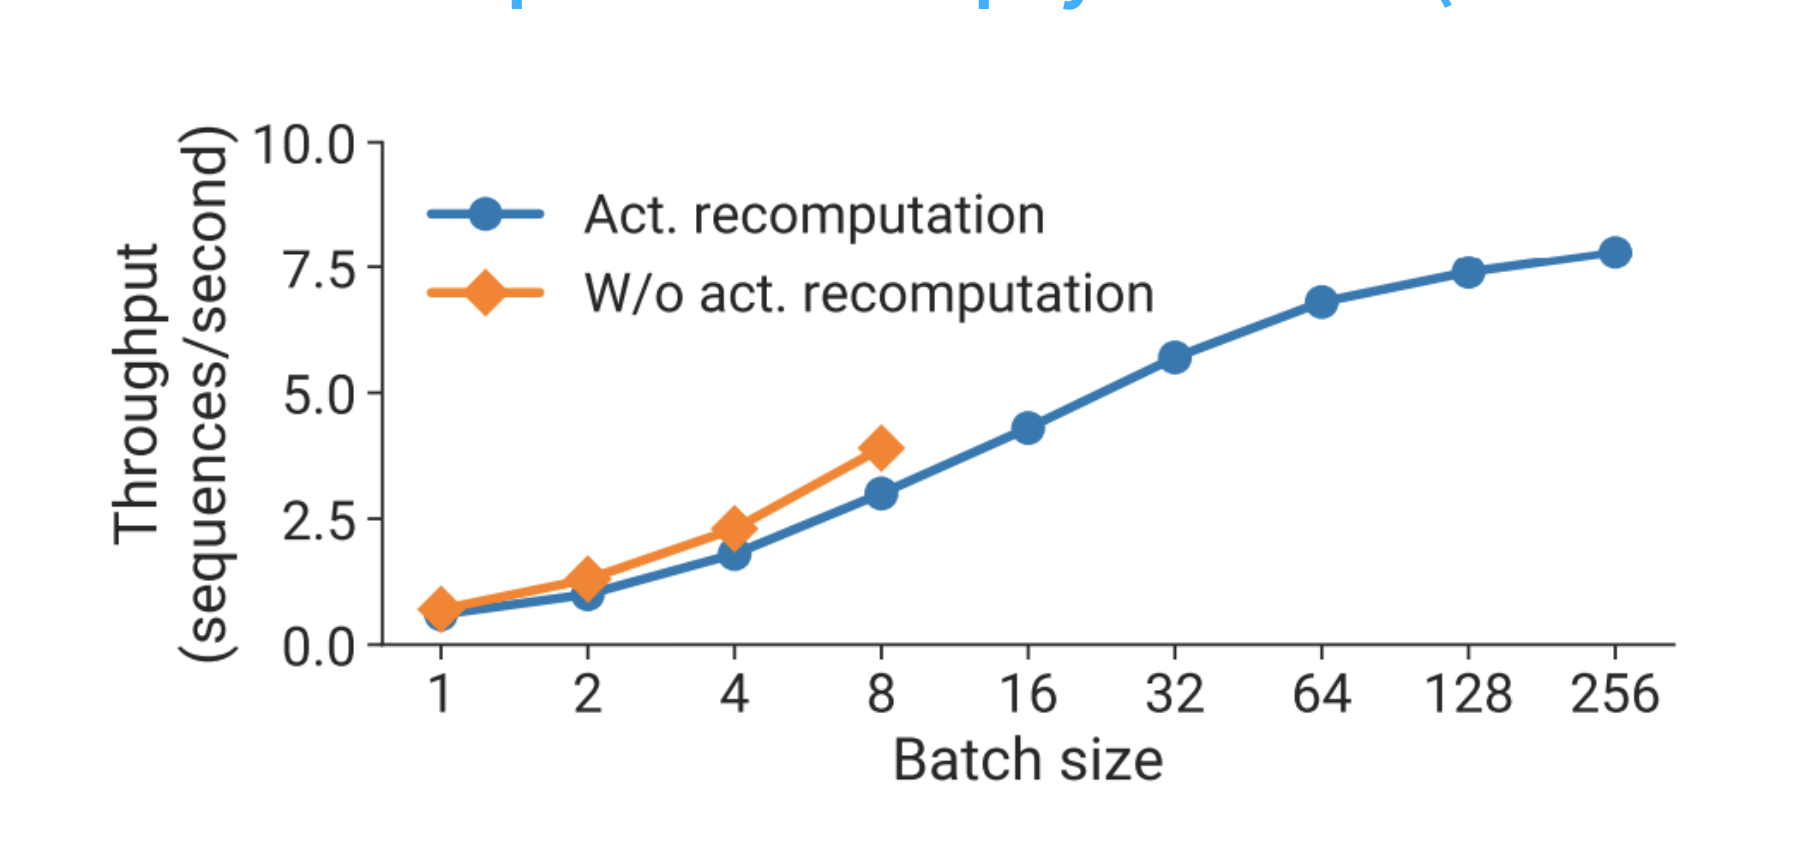
图源为 Narayanan 等,2021,Figure 17 与 §5.6:145B GPT、128 张 80 GB A100,TP=8、PP=16,因此 DP=1;横轴是全局 batch 的序列条数。小 batch 时重算曲线更低,但它能扩展到更大的 batch,最高吞吐超过不开重算时可达到的最佳值。论文将这项收益归因于更小的流水气泡;该实验段落没有给出 micro-batch 大小,不能据图反推出具体 $m$。
8.3 三个训练配置,分别对应不同约束
OLMo-7B 使用 PyTorch FSDP 训练;Dolma 是其预训练语料的名称。这个例子说明,并不是每个模型都需要把 TP、PP 一起用上,FSDP 本身就可以是一条训练扩展路线。OLMo 报告,§2–3
Llama 3 405B 的预训练配置则体现了序列长度如何改变资源分配。在 16,384 张 H100 上,8K 序列使用 TP=8、CP=1、PP=16、DP=128;128K 序列改为 TP=8、CP=16、PP=16、DP=8。这里 DP 使用 FSDP,两组配置的设备数都满足 $N=dtpc$。随着上下文变长,更多卡被分配给同一样本的 CP,数据并行副本数相应减少。Llama 3 报告,Table 4 与 §3.3.2
DeepSeek-V3 训练使用 PP=16、跨 8 个节点的 EP=64,以及 ZeRO-1,报告明确没有采用 TP。它是 MoE 模型,EP 将专家分给不同设备,token 路由带来的通信又是一种约束;不能用前面 dense MLP 的 TP 表替代 EP 分析,也不能把推理部署中的 TP/SP 配置搬到训练上。DeepSeek-V3 报告,§3.2
这些配置可以帮助定位问题,却不能替代当前 workload 的测量。公式先给出显存和通信的量级,实际选择则要回到每个 micro-batch 的 token 数、具体的张量保存方式、collective 所走的链路,以及流水线上真正发生等待的位置。