关联阅读:Transformer 加速技巧 混合精度训练(AMP) Sequence Parallel 与 Context Parallel
1. 标准 Attention 的内存瓶颈
把 Attention 写成代码,最直接的实现就是三步:先算 Q @ K.T,再做 softmax,最后乘 V。公式很短,中间结果却可能比输入大得多。
固定一个 head,设序列长度为 $N$,head 维度为 $d$,并令 $Q,K,V\in\mathbb R^{N\times d}$:
\[S=\frac{QK^{\mathsf T}}{\sqrt d},\qquad P=\operatorname{softmax}(S),\qquad O=PV\]$Q$、$K$、$V$ 和输出 $O$ 都是 $N\times d$,而 $S$ 和 $P$ 是 $N\times N$。例如 $N=8192,d=64$,按每个元素 2 字节手算,一份 $Q$ 只占 1 MiB,一份分数矩阵却要 128 MiB。这还只是一个 head。
在分别执行矩阵乘、softmax、矩阵乘的朴素实现里,$S$ 算完要写回 HBM,softmax 再读出它、写入 $P$,后面的矩阵乘又要读出 $P$。这些中间矩阵不仅占显存,还反复消耗显存带宽。尤其是 softmax 的逐元素运算和归约,很容易受数据搬运限制。[1]
FlashAttention 要解决的问题由此变得具体:能不能让分数算出来以后,就在片上接着完成后续计算,不把完整的 $S$、$P$ 写回显存?
2. FlashAttention 的核心思想
矩阵乘本来就可以分块,麻烦在 softmax:某个 query 对当前 key 块的权重,还取决于其他 key 的分数。只把矩阵切小,仍然无法独立完成每一块的归一化。
FlashAttention 把分块计算与 online softmax 放在一起处理。每次只生成一个局部 tile,同时保留足以合并后续块的状态;已经消费过的分数和权重便可以丢弃。反向传播需要它们时,再从输入和保存的逐行统计量重建。这就是 tiling、online softmax 和 recomputation 在同一条计算链中的分工。[1]
这里的“精确”指计算的是原来的 dense Attention,没有通过稀疏化或低秩近似改变公式;浮点运算顺序变化仍可能带来舍入差异。
2.1 Tiling:沿着一个 tile 看数据怎样流动
先固定 query 块 $Q_i$,让 key/value 块 $K_j,V_j$ 依次经过它。$B_r$ 是 query 块行数,$B_c$ 是 key/value 块行数。下面采用 FA-2 [2] 的扫描顺序和未归一化输出写法,便于看清哪些状态需要留下来。
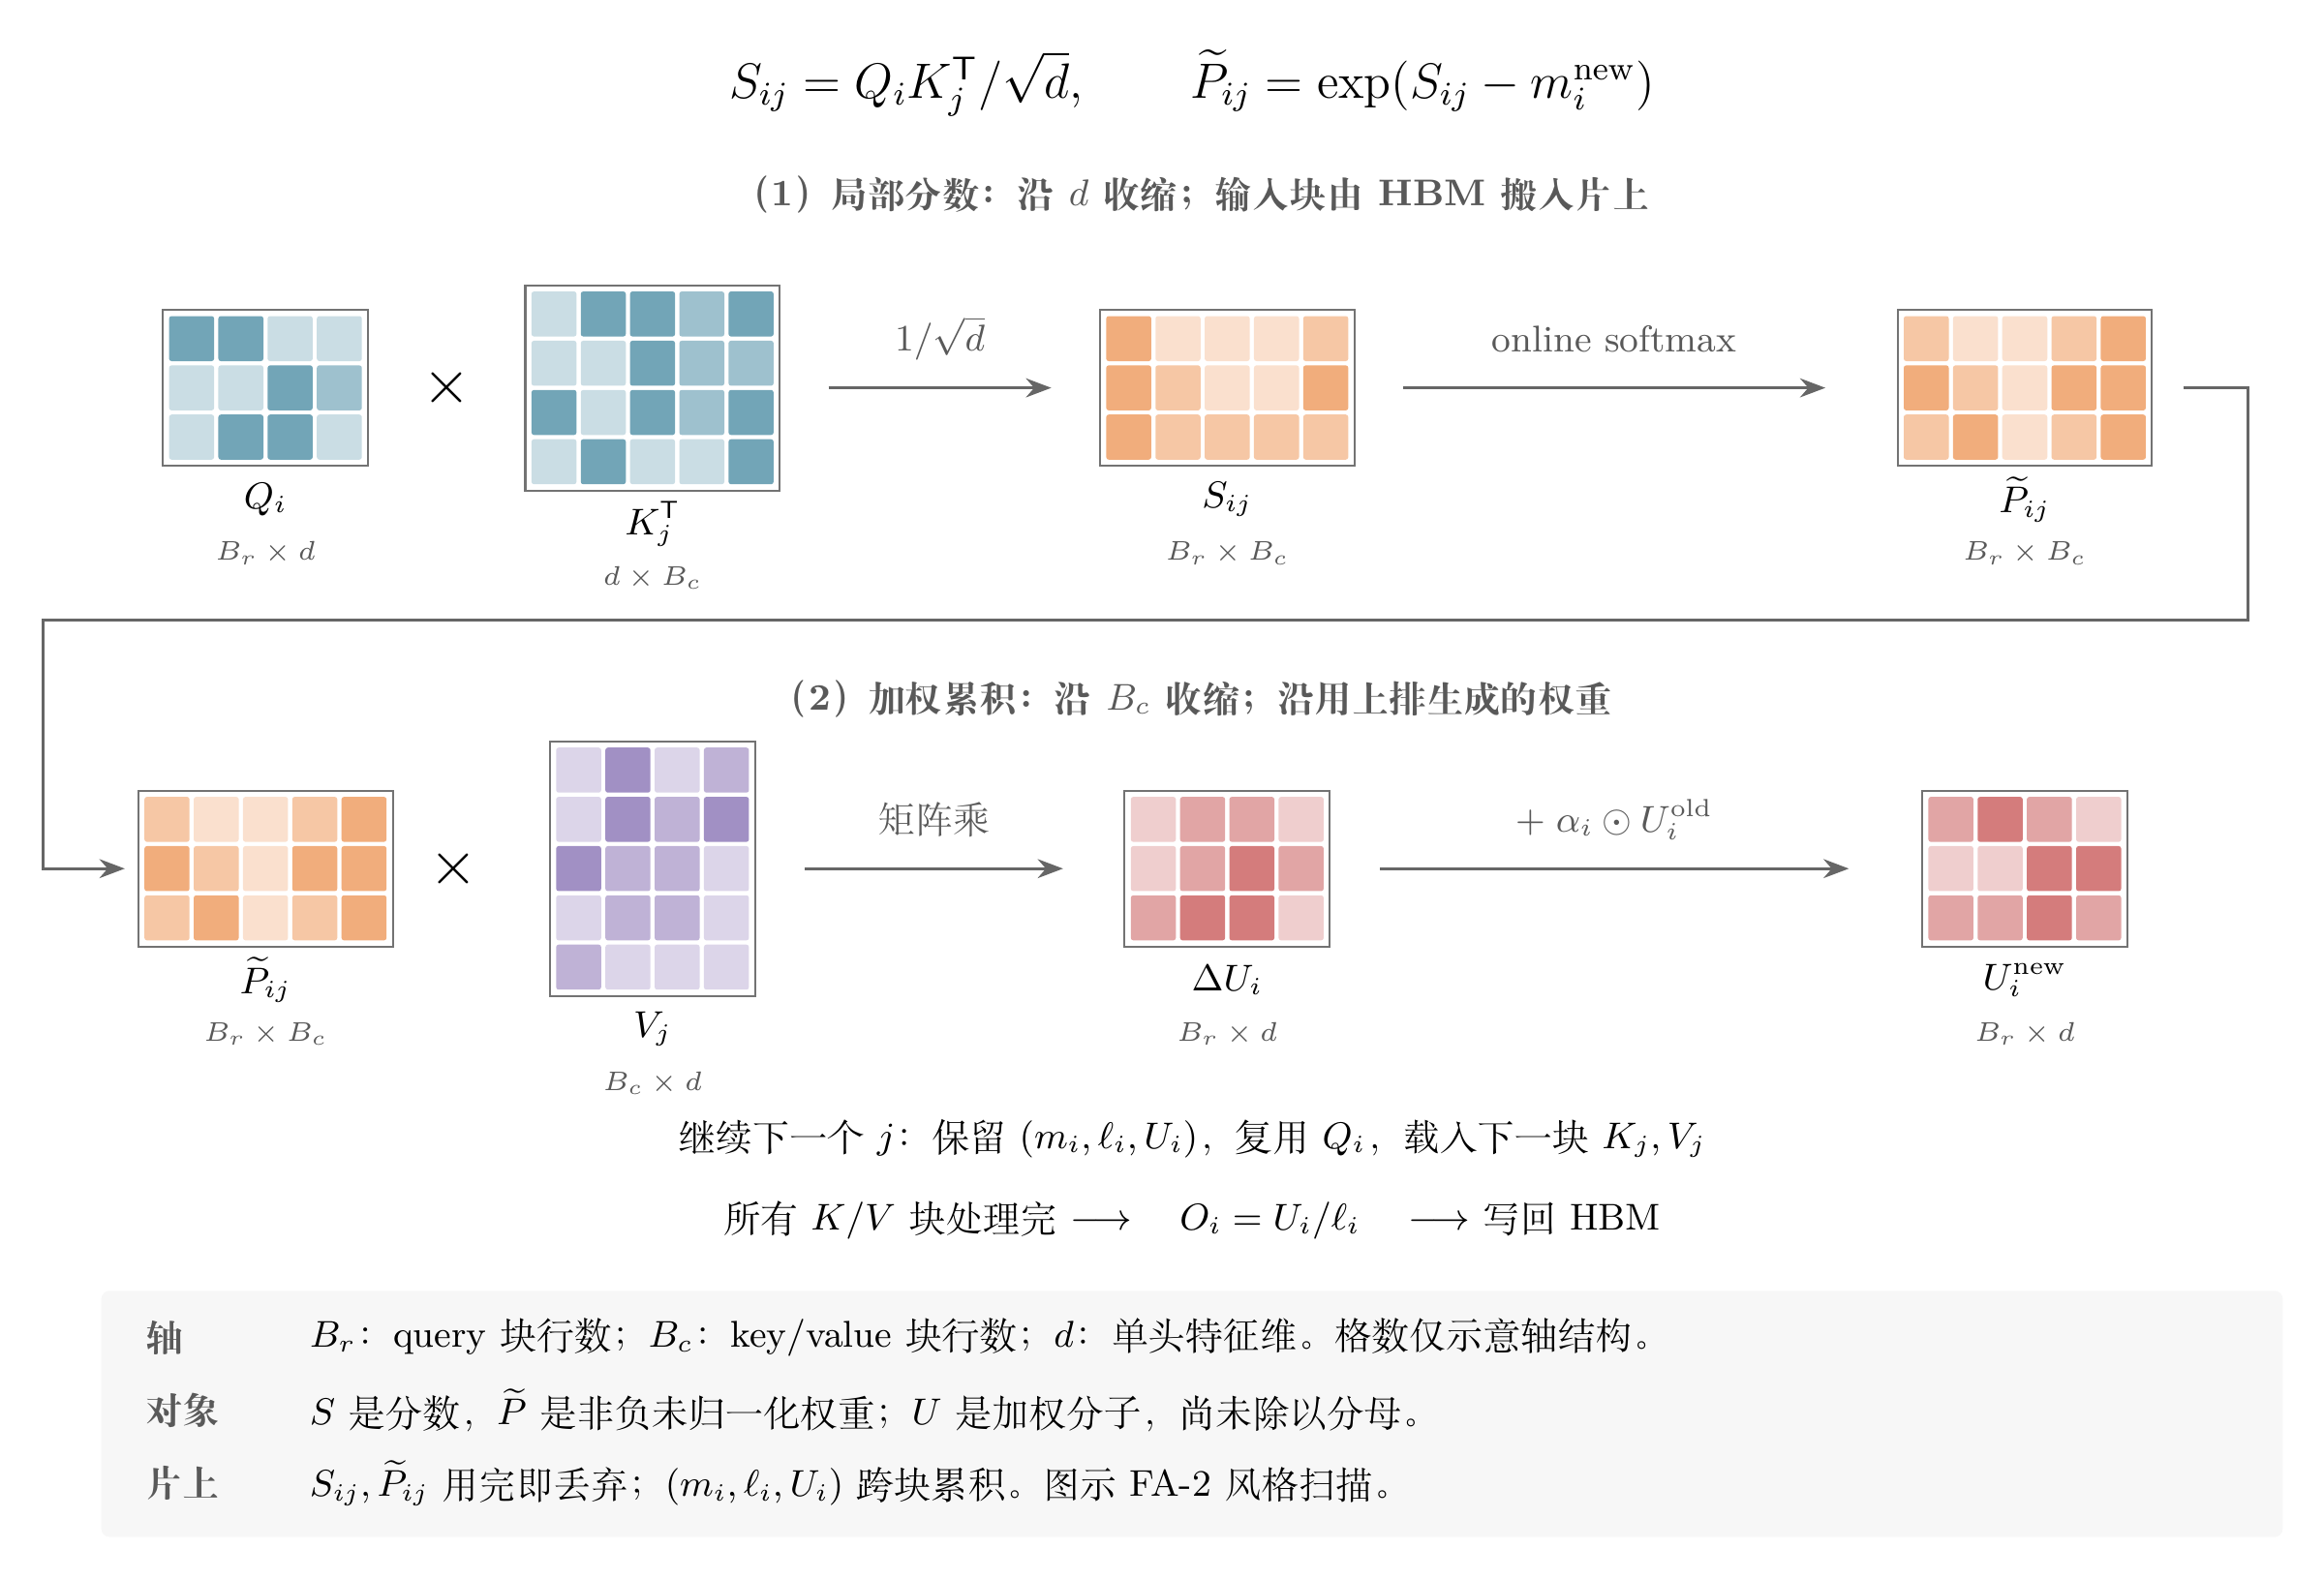
从第一排左侧的两个蓝色块开始:$Q_i$ 的每一行是一个 query,$K_j^{\mathsf T}$ 的每一列是一个 key。两者沿共同的特征维 $d$ 做点积,乘上 $1/\sqrt d$,就得到橙色分数块 $S_{ij}$。它有 $B_r$ 行、$B_c$ 列,每个元素表示当前 query 与当前 key 的匹配分数。
沿着箭头向右,online softmax 把分数变成未归一化权重 $\widetilde P_{ij}$。两块橙色矩阵的形状完全一样,变的是元素的含义:从分数变成指数权重。此时还不能按当前块单独归一化,因为后面可能还有 key 没有参与计算。
图中的长折线把这份权重接到第二排。$\widetilde P_{ij}$ 与紫色的 $V_j$ 相乘,沿 $B_c$ 维收缩,得到红色的 $\Delta U_i$。这一步把“当前 query 对各个 key 的权重”换成“当前 value 块对输出的贡献”,因此形状回到 $B_r\times d$。
第二排最右侧还要加上旧贡献,但先乘一个逐行缩放系数 $\alpha_i$。更新后的 $U_i$ 是到目前为止的输出分子。接下来换一块 $K_j,V_j$,重复两排计算;只有看完全部 key,才用累计分母 $\ell_i$ 除它,得到最终的 $O_i$。这个缩放系数为什么必需,下一张图会展开。
再看哪些数据需要留下:$Q_i$ 在这轮扫描中复用,$(m_i,\ell_i,U_i)$ 跨块保留;$S_{ij}$ 和 $\widetilde P_{ij}$ 完成本块计算后就可以释放片上空间。这样完整的 $N\times N$ 中间矩阵始终没有出现。
图中的“片上”包括 shared memory 和寄存器,矩阵形状表示逻辑张量,不表示线程或物理存储布局。$B_r,B_c$ 的选择受片上容量、head 维度和 kernel 配置约束。原始 FA-1 [1] 的循环顺序不同,会在块间读写部分输出状态;两者共同省去的是完整分数和概率矩阵的 HBM 读写。
2.2 Online Softmax:新块来了,旧贡献怎样接着用
现在回到第一张图中间的 online softmax 箭头。假设前面已经处理了一些 key,新块里却出现了更大的分数。为了数值稳定,需要改用新的最大值做指数基准;旧分母和旧输出分子也必须跟着调整,才能与新块相加。
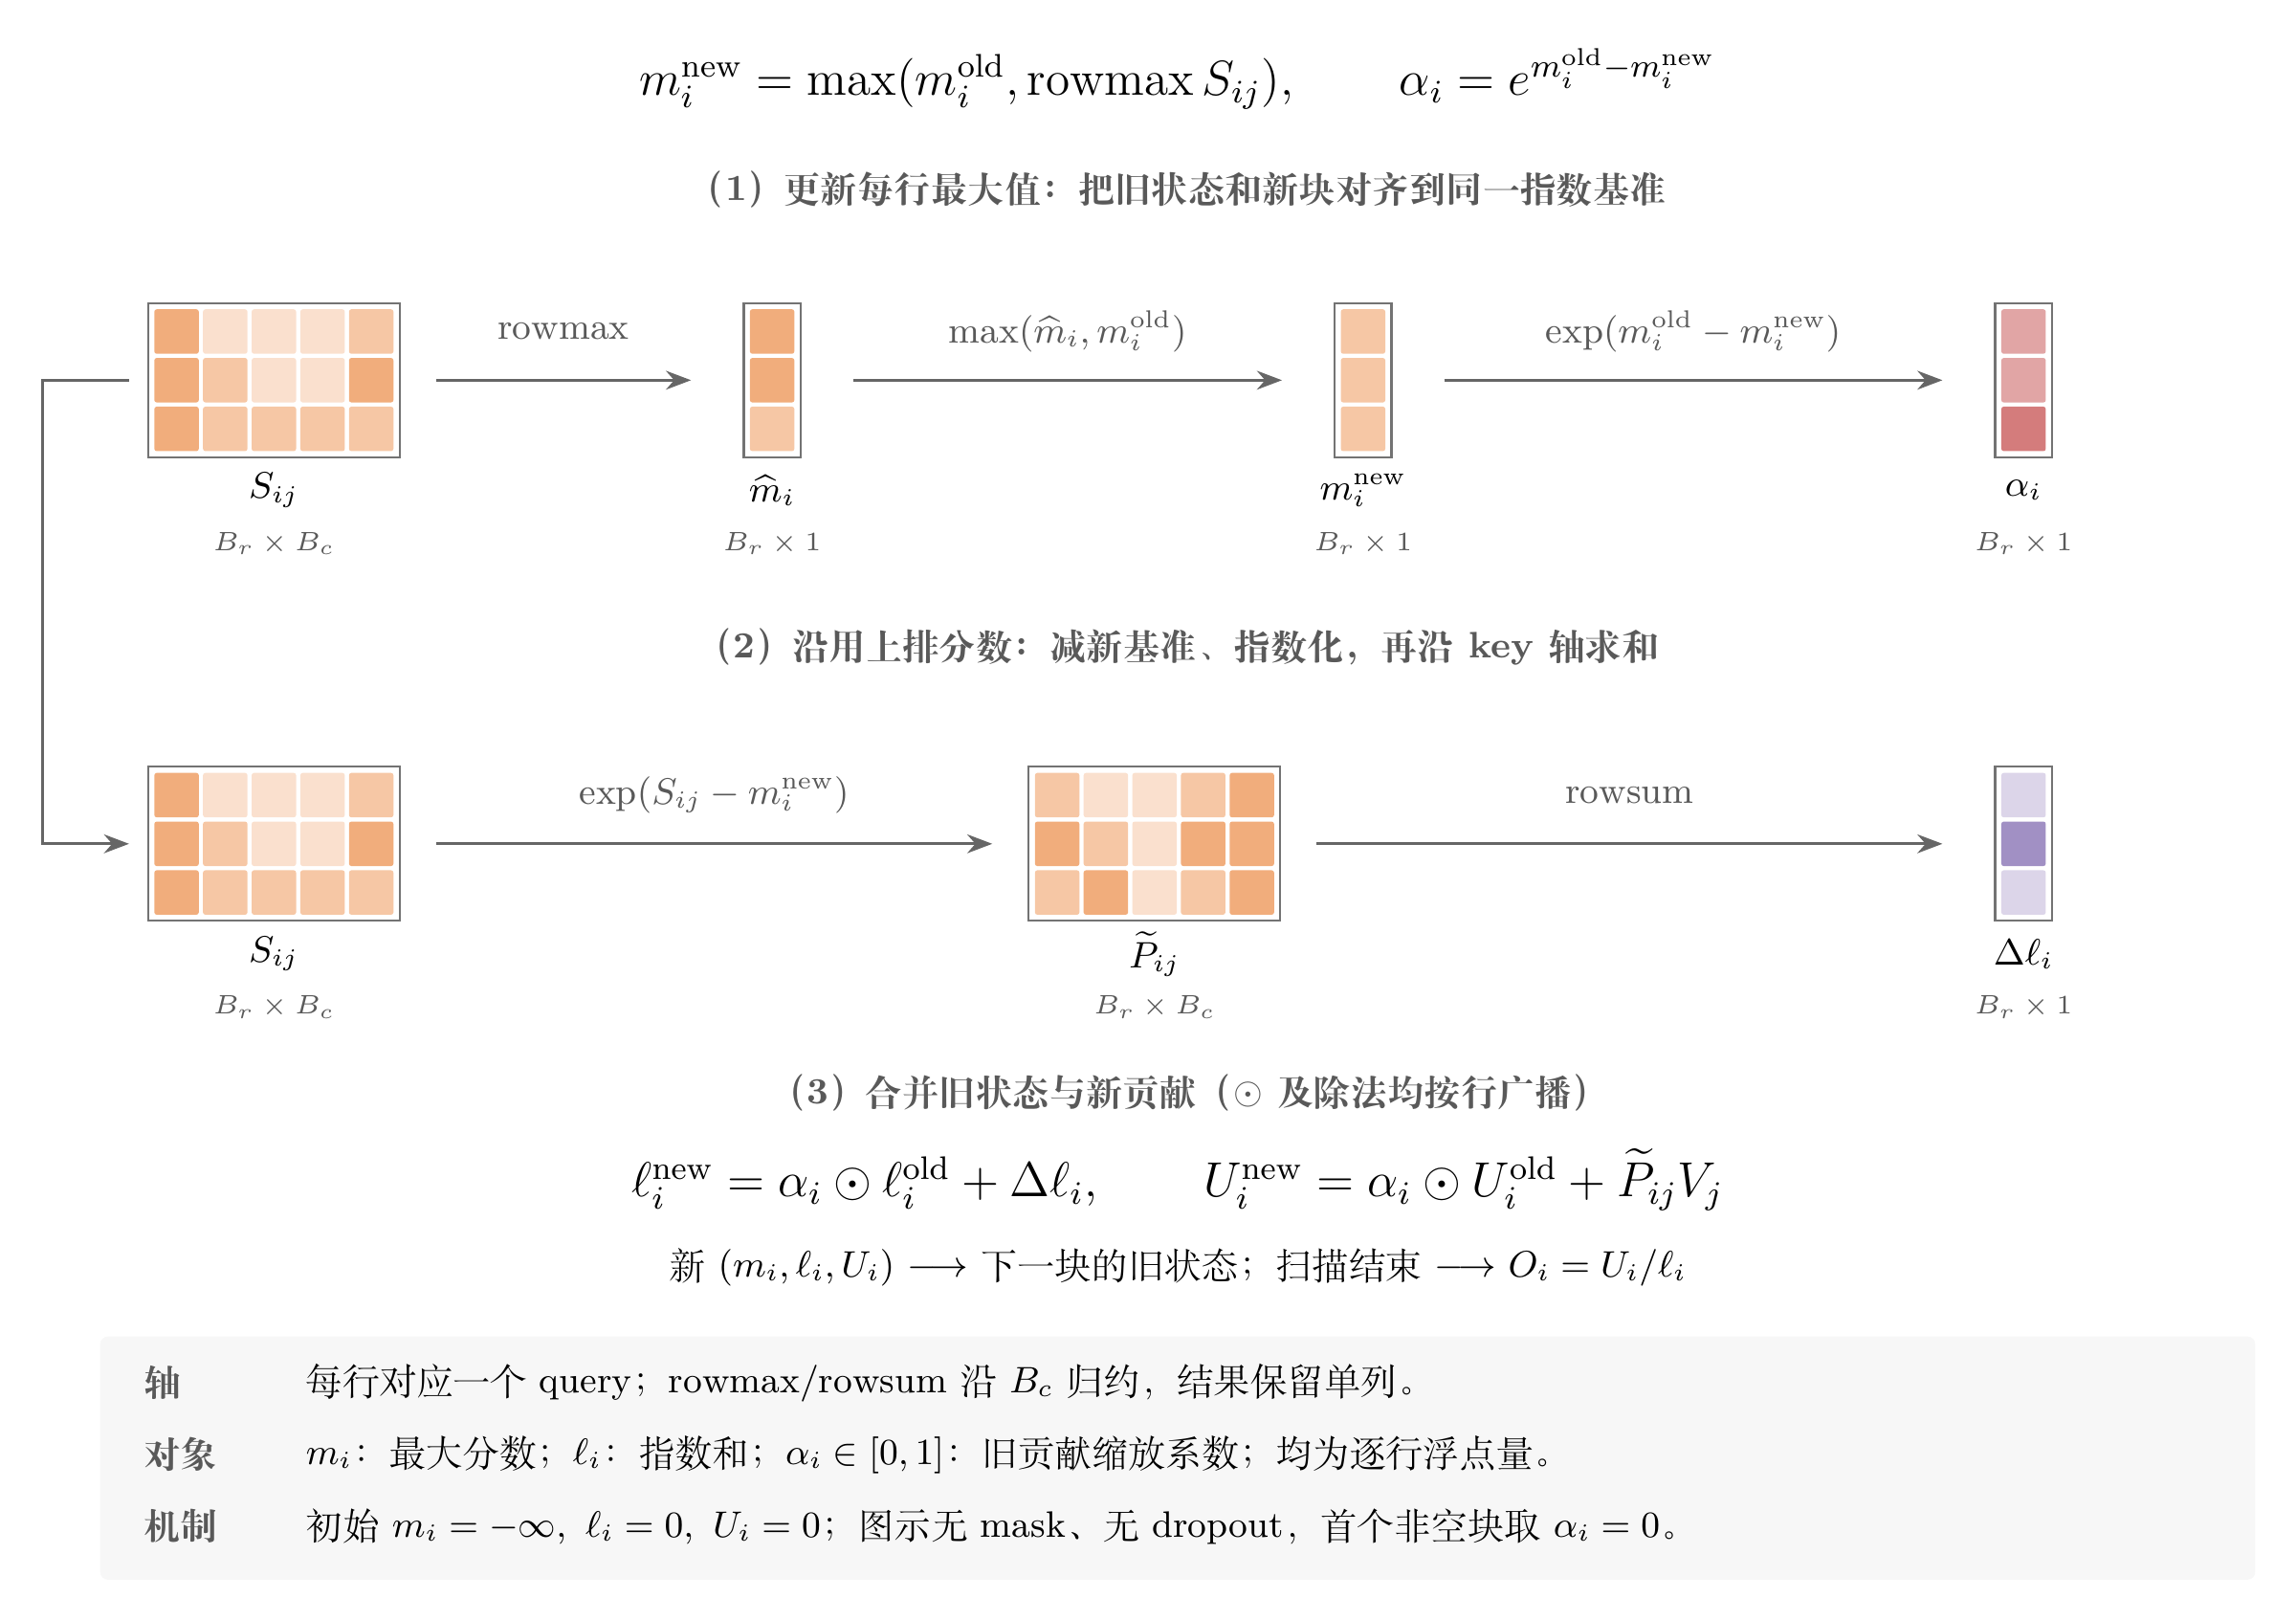
第二张图第一排,把橙色分数块沿 key 维做 rowmax,宽矩阵就变成了单列:每个 query 得到一个当前块的最大分数 $\widehat m_i$。再与旧最大值比较,得到看过的全部 key 的最大值 $m_i^{\mathrm{new}}$。这里 $i,j$ 是块编号,所以 $m_i$ 是 $B_r\times1$ 的向量,每一行独立更新:
第一排右侧的红色向量 $\alpha_i$,就是第一张图里缩放旧贡献的系数。对某一行,如果最大值从 $2$ 变为 $3$,原来按 $e^{s-2}$ 累加的每一项都应乘 $e^{-1}$,变为 $e^{s-3}$;如果最大值没有变,系数就是 $1$。只需缩放已经累加好的结果,无需取回所有旧分数。
第二排沿用同一个 $S_{ij}$,减去新的逐行最大值,再做指数化,得到 $\widetilde P_{ij}$。这里每行都减一个标量,因此橙色矩阵仍是 $B_r\times B_c$。继续沿 key 维做 rowsum,才缩成右侧的单列 $\Delta\ell_i$:它是新块给分母带来的贡献。
分母如此,输出分子也一样。新块的贡献就是第一张图第二排算出的 $\widetilde P_{ij}V_j$,与缩放后的旧分子相加:
\[U_i^{\mathrm{new}}=\alpha_i\odot U_i^{\mathrm{old}}+\widetilde P_{ij}V_j, \qquad O_i=U_i/\ell_i\quad\text{(扫描结束后)}\]这里减法、$\odot$ 和最后的除法都按行广播。每次循环结束,$(m_i,\ell_i,U_i)$ 已经概括了看过的全部 key:最大分数是多少、以它为基准的指数和是多少、同一基准下的加权输出是多少。下一块只需要接着更新这三份状态。
初始状态为 $m_i=-\infty,\ell_i=0,U_i=0$,首个非空块的旧贡献系数取 $0$。两图省略了 mask 和 dropout;使用 causal mask 时,被屏蔽分数置为 $-\infty$,全被屏蔽的行需要跳过无效的指数差值计算。
3. 内存和速度收益来自哪里
回看第一张图,两个矩阵乘仍然都在,每个有效的 query-key 配对也仍然要计算。因此 dense Attention 的计算量仍是 $O(N^2d)$。变化在于:橙色中间块的生命周期被限制在片上,而最终留下的输出及逐行统计量只随序列长度线性增长。
反向传播延续了这个思路。以 FA-2 为例,前向额外保存逐行的 log-sum-exp,即 $m_i+\log\ell_i$;反向再分块重建分数和概率,参与梯度计算。多做一些计算,换掉保存、读取完整中间矩阵的成本。[2]
| 比较项(单个 head) | 朴素实现 | FlashAttention |
|---|---|---|
| 前向计算量 | $O(N^2d)$ | $O(N^2d)$ |
| 显存中物化完整 $S/P$ | 需要,大小为 $N\times N$ | 不需要,只计算局部块 |
| Attention 存储规模 | $O(Nd+N^2)$ | $O(Nd)$ |
显存占用和 HBM 访问量是两个指标。前者回答“同时要放多少数据”,后者回答“整个计算过程搬了多少数据”。原论文在 SRAM 容量 $M$ 以元素数计、$d\le M\le Nd$ 的模型中,给出 FA-1 的 HBM 访问量为 $\Theta(N^2d^2/M)$,标准实现为 $\Theta(Nd+N^2)$。[1] 因而,线性的存储规模并不意味着整个计算只需线性的数据搬运。
论文报告的 FlashAttention 加速约为 2–4 倍,具体取决于形状和对照实现。[1] 这不是减少了同样倍数的乘加,而是减少中间结果搬运之后,计算单元有更多时间用于实际计算。
4. FlashAttention-2 / 3 怎样继续优化
FlashAttention-2:减少额外运算,重新分配工作
前面两张图已经包含了 FA-2 的一个改进:循环里累积未归一化的 $U_i$,最后才除以 $\ell_i$。延后的是归一化,最大值变化时的 $\alpha_i$ 缩放仍然需要逐块执行。
另一部分改进在于工作怎样交给 GPU。不同 $Q_i$ 可以独立产生各自的 $O_i$,FA-2 利用这一点,把 query 序列维也纳入 thread block 的并行分工。在一个 thread block 内,再让不同 warp 负责不同 query 行、共享所需的 K/V,从而减少 warp 之间合并部分输出的通信。[2]
论文在 A100 上报告,相比 FA-1 约有 2 倍加速,前向最高达到理论 FLOPs/s 的 73%。其中端到端 GPT 训练的 72% 指 model FLOPs utilization(MFU),与 Attention kernel 自身的利用率是不同统计口径。[2]
FlashAttention-3:让搬运、矩阵乘和 softmax 重叠
第一张图为了说明依赖关系,把各个步骤顺序展开。FA-3 在 H100 上进一步考虑:处理当前块时,能否同时搬入下一块?执行矩阵乘时,能否穿插另一阶段的 softmax 工作?
这里要区分两类硬件能力:TMA 负责异步数据搬运,WGMMA 负责异步 warpgroup 矩阵乘。FA-3 用 producer/consumer 分工组织加载和计算,并利用异步执行安排 GEMM 与 softmax 的重叠;FP8 路径还结合分块量化等方法控制数值误差。[3]
论文在 H100 的 FP16 前向测试中报告了相对 FA-2 约 1.5–2 倍的加速。[3] 从图上看,公式依赖没有消失,优化的是不同块、不同阶段在硬件上的执行时间安排。
5. 与 Sequence Parallel 的配合
两张图都固定 $Q_i$,让 K/V 分块到来。这也给分布式 Attention 提供了一个自然的连接点:这些块可以从本卡显存读取,也可以由其他设备传来。
Ulysses 先用 All-to-All 改变分工,让每张卡拿到一部分 heads 的完整序列,再在本地调用 FlashAttention。对均匀切分的 MHA,省略 batch 维,设 head 数为 $H$、并行度为 $p$,布局变化可写成:
(N/p, H, d) → All-to-All → (N, H/p, d)
           → 本地 FlashAttention → All-to-All → (N/p, H, d)
这里每卡负责 $H/p$ 个 head,每个 head 的特征维仍是 $d$。[4]
Ring Attention 则更接近第一张图的循环:query 留在本卡,远端 K/V 依次传来,每处理一块就更新在线状态。设备间传递的一个 KV 分片还可以继续切成多个片上 tile;合并结果时仍要保留正确的归一化统计量,不能直接相加各块独立 softmax 后的输出。[5] 更完整的通信与张量布局见Sequence Parallel 与 Context Parallel。
6. 使用:从统一接口进入
在 PyTorch 中,通常从 scaled_dot_product_attention 调用 Attention。下面假设 query/key/value 的形状为 [batch, heads, sequence, head_dim]:
import torch.nn.functional as F

output = F.scaled_dot_product_attention(
    query, key, value,
    attn_mask=None,
    dropout_p=0.0,
    is_causal=True,
    scale=None,  # 默认使用 1 / sqrt(head_dim)
)
这是统一接口,实际 backend 由设备、dtype、形状及其他输入条件决定,调用它并不保证一定走 FlashAttention。[6] 验证性能时,应结合 profiler 确认实际执行的 kernel,再比较相同输入下的耗时和显存占用。
理解这个 kernel 时,可以始终沿着第一张图追问:当前生成的分数块在哪里被消费,处理完以后留下了什么?再用第二张图核对:新块到来时,旧分子和旧分母是否仍处在同一个指数基准下?这两点连起来,FlashAttention 如何减少 IO、又如何保持 Attention 计算不变,就落到了具体的数据和更新操作上。
参考
[1] Dao, T., et al. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. NeurIPS 2022. arXiv:2205.14135,算法与 IO 复杂度见 Algorithm 1、Theorem 2。
[2] Dao, T. FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning. ICLR 2024. arXiv:2307.08691,更新规则与任务分工见 §3。
[3] Shah, J., et al. FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision. 2024. arXiv:2407.08608。
[4] DeepSpeed. Getting Started with DeepSpeed-Ulysses。
[5] Liu, H., et al. Ring Attention with Blockwise Transformers for Near-Infinite Context. ICLR 2024. arXiv:2310.01889。
[6] PyTorch. scaled_dot_product_attention。