昇腾 950 有一个值得琢磨的地方:950PR 的显存容量上限是 128 GB、带宽是 1.6 TB/s;950DT 则是 144 GB、4 TB/s。容量只增加了 12.5%,带宽却变成了 2.5 倍。再看华为公开的封装结构,PR 使用 8 个显存模块,DT 反而只有 4 个。华为《昇腾 950 NPU 架构白皮书》第 3 章已经给出了这些信息。
这让问题从“华为有没有自研 HBM”,走到了“同一套计算架构,为什么要搭配两种差别这么大的显存”。两种方案的名字分别是 HiBL 1.0 和 HiZQ 2.0。外部中文文章把它们叫作“白鹭”和“朱雀”,名字颇有辨识度,但我更关心这两只“鸟”背后的工程取舍。
本文按 2026 年 9 月 30 日可访问的公开材料整理。官方规格、外部报道和下面的设计取舍推测会在各自出现的地方交代来源。
白鹭与朱雀:命名线索比较强,英文全称还没有落定
华为在 2025 年全联接大会的英文演讲稿中,明确将 HiBL 1.0、HiZQ 2.0 称为 proprietary HBM,并说明它们分别与 Ascend 950 Die 合封,构成面向 Prefill/推荐的 950PR 和面向 Decode/训练的 950DT。这份材料给出了产品名和用途,没有展开 BL、ZQ 的全称。
中文命名可以找到两处直接线索。芯事情报局在 2025 年 9 月 19 日的文章中,把 HiBL、HiZQ 分别写作内部代号“白鹭”“朱雀”;少数派作者虹猫剑侠在 2025 年 10 月 21 日的文章中,也给出了 BL 对应白鹭、ZQ 对应朱雀的解释。
因此,我倾向于相信“白鹭/朱雀”这组对应关系:BL 与 Bai Lu、ZQ 与 Zhu Que 的拼音首字母吻合,两种鸟类名称也形成了一组自然的命名。不过,两位作者没有公开消息来源,无法确认他们是否获得了彼此独立的信息。更准确的说法是“有两篇署名文章支持的非官方命名”,而不是“已完成双重独立验证”。
如果只是为了帮助记忆,可以把它们展开成下面两种非官方释名:
| 产品名 | 外部中文代号 | 便于理解的英文写法 |
|---|---|---|
| HiBL 1.0 | 白鹭 | Huawei High-Bandwidth Memory — Bailu 1.0 |
| HiZQ 2.0 | 朱雀 | Huawei High-Bandwidth Memory — Zhuque 2.0 |
这里的 HBM 是产品类别,不能因为表格这样写,就认定整串英文是华为公布的全称。“Hi 代表 Huawei”也暂时属于解释性猜测。它与麒麟、鲲鹏等名称所体现的中国文化意象有相似之处,但这只是命名联想;昇腾、鲲鹏属于计算产品,也不宜都归到“终端侧”或“鸟类命名”之下。
两种结构,已经知道到哪一步
华为早期演讲稿说 PR、DT 共用 Ascend 950 Die;2026 年白皮书把整颗封装进一步拆开:两款都是 2 个 AI Die、2 个 IO Die,区别之一是 PR 配 8 个高速显存模块,DT 配 4 个。它们通过 D2D Clink 与 Memory Interface 组成统一访存的 Chiplet 整体。这里“共用 Die”应理解为复用计算设计,不能据此画成整颗产品只有一个计算晶粒。白皮书第 3 章、图 3-1
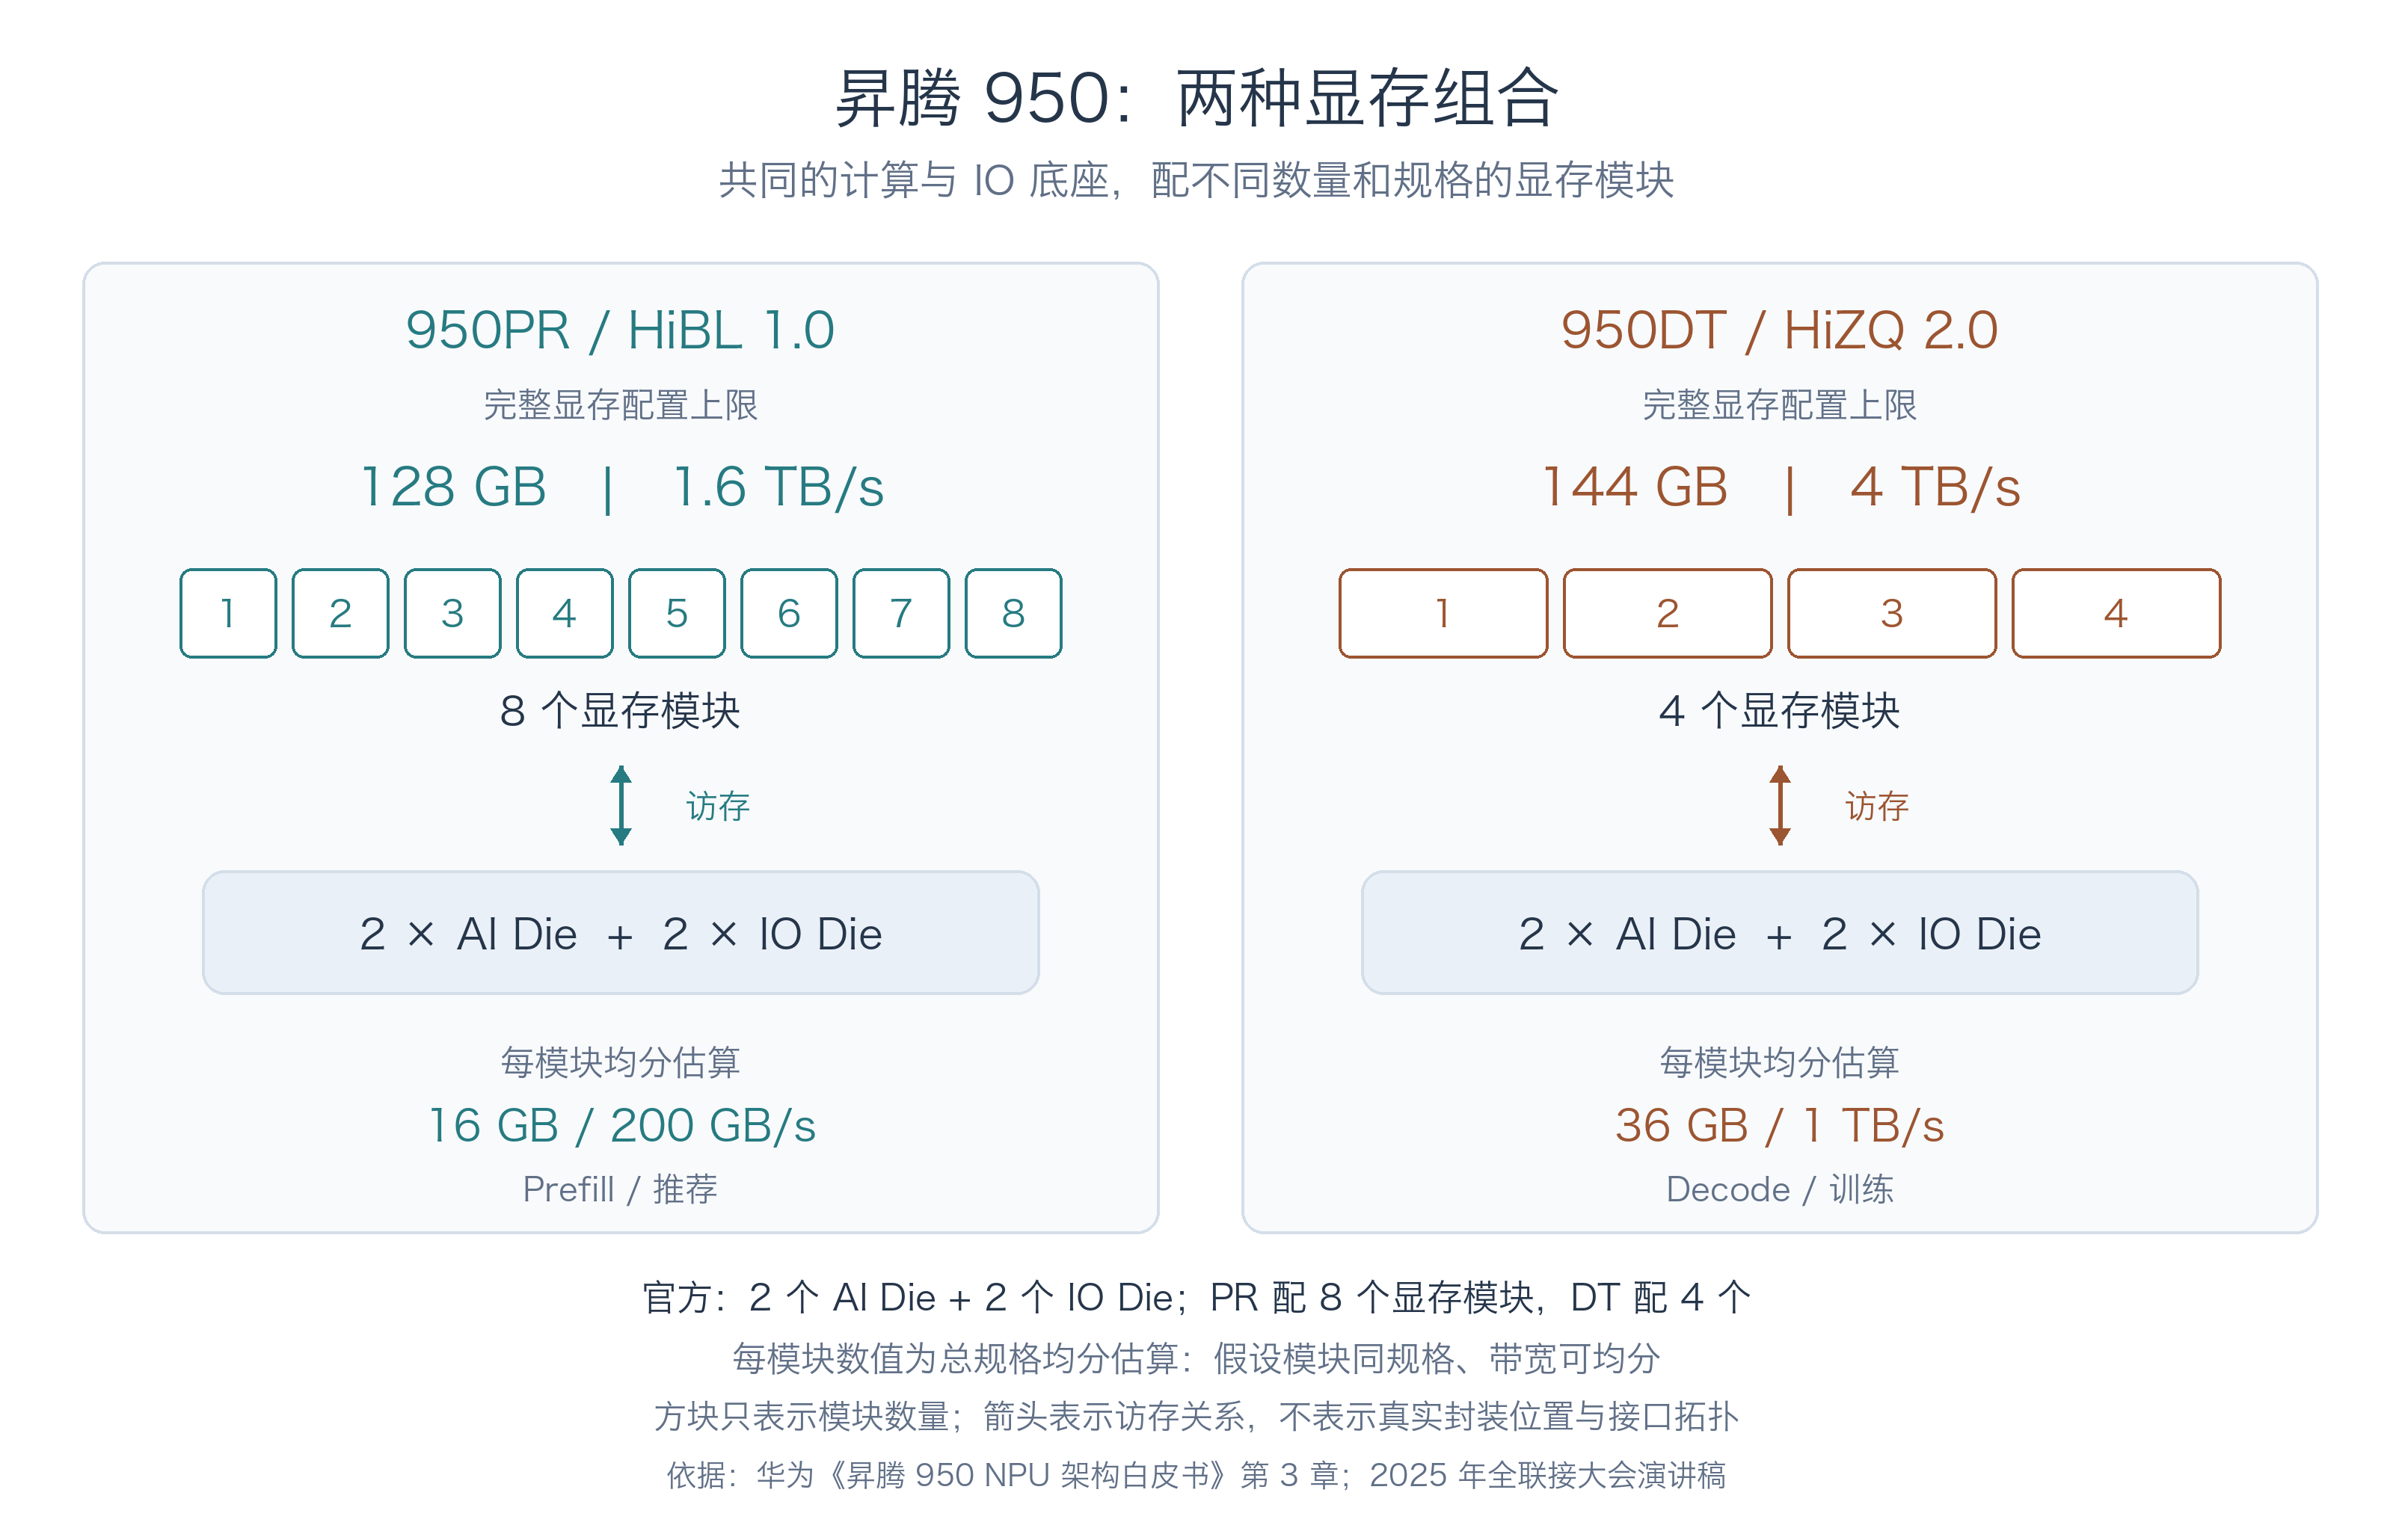
图中方块表示模块数量,双向箭头表示计算部分与显存之间的访问关系;没有复现实际封装位置、接口数量或走线。白皮书的原称是“高速片上内存”;本文按它作为 AI 加速器本地 HBM 的用途,称为显存。官方术语是在多 Die 合封的语境下使用,不能理解成计算 Die 内部集成了上百 GB 的 SRAM。
按完整配置、同规格模块均分,PR 每模块约为 16 GB、200 GB/s,DT 每模块约为 36 GB、1 TB/s。这是总规格的手算平均值。DT 用更少的模块提供更高带宽,说明两条路线的资源配比确实有明显差别。
白皮书的表 3-1 还列出了裁剪配置,因此上述上限不能直接套到每一张实际板卡上。本文讨论的是两条显存路线,不拿某个板卡型号的容量反推整条产品线。
外部消息:HBM 的性能、良率与供给约束
这次的阅读起点是 TechFlow 对 SemiAnalysis 长鑫报告的编译。SemiAnalysis 原文讨论了长鑫 HBM 在晶圆制造、堆叠与封装上的良率挑战,并提出华为与长鑫会采用偏离 JEDEC 标准及 PHY 的定制 HBM。这些是产业研究判断,可以作为理解供给约束的背景,不能直接当成 HiBL、HiZQ 的实际良率。
从这个背景看,设计者需要同时考虑两件事:单模块能够提供多少带宽,以及有限产能能交付多少可用模块。带宽目标越高,制造与封装需要满足的条件通常也越苛刻。如果每个场景都按最高规格配置,有限的高性能 HBM 就可能成为整套算力系统的供给瓶颈。
从 PD 分离倒推硬件设计
我的猜测可以更直接一些:先按 Prefill/Decode 分离的方案划分工作负载,再倒推两边需要什么显存。
Prefill 一次处理多个输入 token,更容易通过批量矩阵计算复用权重,把计算单元利用起来;Decode 逐步生成 token,在低 batch、低延迟场景下,更容易受权重与 KV cache 的读取带宽限制。PD 分离让两边各自配置资源:Prefill 侧优先保证算力与够用的显存带宽,Decode 侧优先保证显存带宽和 KV cache 容量。NVIDIA Dynamo 的 PD 分离说明也沿着这组需求差异组织部署。
这样看,950PR 搭配低成本的 HiBL,950DT 搭配高带宽的 HiZQ,就很顺了。Prefill 侧用较低带宽的方案,仍然有机会把计算单元喂饱;更稀缺的高带宽显存则优先配置给 Decode,以及需要它的训练任务。华为公开的 PR/DT 定位与这条思路相符。
在 HBM 性能、良率和产能都有限的场景下,这种分工有机会同时扩大可用供给、提高带宽利用率:Prefill 侧可以选择较宽松的带宽目标,为成本和制造良率留出空间;Decode 侧承担高带宽方案的成本,把带宽花在更能转化为吞吐的地方。两条路线能带来多少供给和吞吐收益,取决于各自的实际成本与良率。
PD 分离之后,Prefill 产生的 KV cache 需要搬到 Decode 侧,互联和调度要跟得上;batch、上下文长度也会改变两边的瓶颈。因此,充分利用 HBM 要看整条推理链路:让较低带宽的显存承担它能胜任的计算,让高带宽显存承担更依赖访存的任务。白鹭、朱雀这两种组合,我更倾向于从这个角度理解。