前置阅读:训练中使用 FP8 精度 · 顺着 FlashAttention 看 SM120 的实现
本文的 Transformer Engine issue、PR 和源码状态核对于 2026-09-22;SGLang 示例核对于 2026-09-25
SM120 原生支持 MXFP8,但在本文核对的 Transformer Engine(下文简称 TE)v2.19 PyTorch 训练路径里,MXFP8BlockScaling 的可用性检查还是返回不支持,卡点主要在反向需要的 GEMM 布局上。
0. MXFP8 的格式与计算
0.1 MXFP8 是什么:FP8 元素加上块 scale
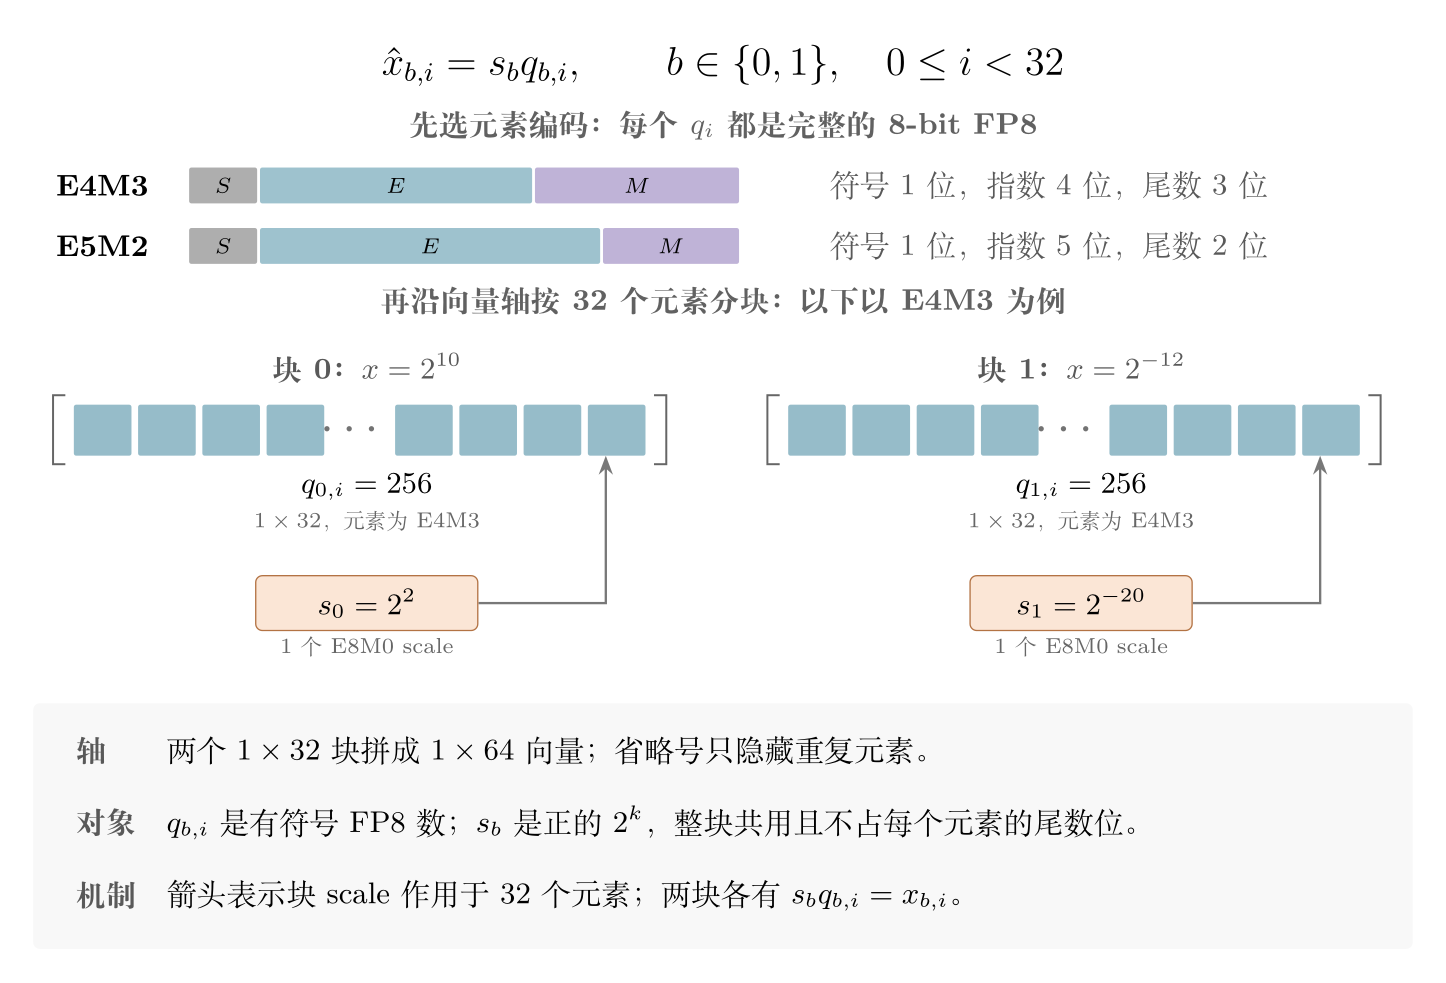
MX 是 Microscaling。按照 OCP MX 规范,MXFP8 把 32 个 FP8 元素放在一个逻辑块里,共享一个 8-bit 的 E8M0 缩放因子。对有限值,解码关系是:
\[\hat{x}_i=s_b q_i,\qquad i\in\text{block }b.\]先分清两层:E4M3、E5M2 是单个元素的 8-bit 编码;MXFP8 是 32 个这类元素加一个共享 scale 的块格式。 两种元素编码都有 1 位符号位,区别在于指数位和尾数位怎么分。下表的范围指的是 $q_i$ 本身,也就是乘块 scale 之前的值;数值来自 OCP FP8 编码规范。
| 元素编码 | 位分配 | 最大有限正数 | 最小正非正规数 | $[1,2)$ 内相邻正规数的间距 |
|---|---|---|---|---|
| E4M3 | 符号 1、指数 4、尾数 3 | $448$ | $2^{-9}$ | $2^{-3}=0.125$ |
| E5M2 | 符号 1、指数 5、尾数 2 | $57344$ | $2^{-16}$ | $2^{-2}=0.25$ |
E4M3 在同一数量级内刻度更密,E5M2 把更多位给了指数,覆盖范围更宽。MXFP8 的块内元素可以选其中任一种。多出来的 scale 让不同的块能适应各自的数值范围,但单个 FP8 元素的尾数位并没有变多。两种块格式见 OCP MX 规范的格式表。
E8M0 没有符号位和尾数位,有限 scale 只能取 $2^k$($-127\le k\le127$),另有一个 NaN 编码,详见 E8M0 编码定义。它的作用是把整块数值一起乘上 $2^k$:比如 E4M3 在 $[1,2)$ 的间距是 $0.125$,乘以 $s_b=4$ 后,解码值在 $[4,8)$ 的间距变成 $0.5$,相对间距仍是 $1/8$。不过同一块里如果有离群的大值,小值照样可能被舍入成零,块 scale 保证不了每个元素都精确。
忽略 padding 和对齐,一个块占 $32\times8+8=264$ bits,平均每个元素 8.25 bits。所谓“32 个数据加一个 scale”说的是编码组成,实现上数据和 scale 完全可以放在不同的数组里。
量化时先给每块选 $s_b$,再算 $q_i=Q_{\mathrm{FP8}}(x_i/s_b)$。MX 规范只定义了转换语义,scale 具体怎么选由实现决定。另外,普通 FP8 只是元素编码,本身没规定整张张量只能用一个 scale;MXFP8 则把块大小和 scale 编码一并标准化了。
手算一个极端例子。假设向量有 64 个数,前 32 个全是 $2^{10}$,后 32 个全是 $2^{-12}$,用 E4M3、就近舍入。如果整段共用 $s=4$,大数变成可以精确表示的 $q=256$,小数则变成 $2^{-14}$,比 E4M3 的最小正非正规数 $2^{-9}$ 还小,直接舍入到零。
如果分成两个 MXFP8 块,分别取 $s_0=2^2$ 和 $s_1=2^{-20}$(都能用 E8M0 表示),两块的 $q$ 都是 256,解码后正好还原。这个算例是人为构造的,只为说明局部 scale 的作用,实际量化器未必会选这两个值。反过来,如果大数和小数混在同一个块里,还是得共用一个 scale,小数照样可能被舍成零。
下图画的就是这个 64 元素向量:前 32 个和后 32 个沿向量轴相邻,各自组成一个 MXFP8 块、选自己的 scale。两块只是拼在一起,没有计算依赖,也不共享 scale。图中省略号只是省掉了重复元素;整张图表示的是逻辑分组和数值关系,不是数据与 scale 的物理存储布局。
0.2 推理场景:SGLang 的 MXFP8 KV cache
训练时,线性层关心的主要是权重和激活以什么格式送进 GEMM;推理还多一份会随生成长度增长的数据:KV cache。每生成一个 token,attention 算出的 K、V 都要留给后面的 token 用。把它们从 BF16 改成低精度格式存,同样的显存就能多放一些 token。KV cache 的格式可以和权重格式分开选,比如模型权重用 NVFP4,KV cache 单独用 MXFP8。
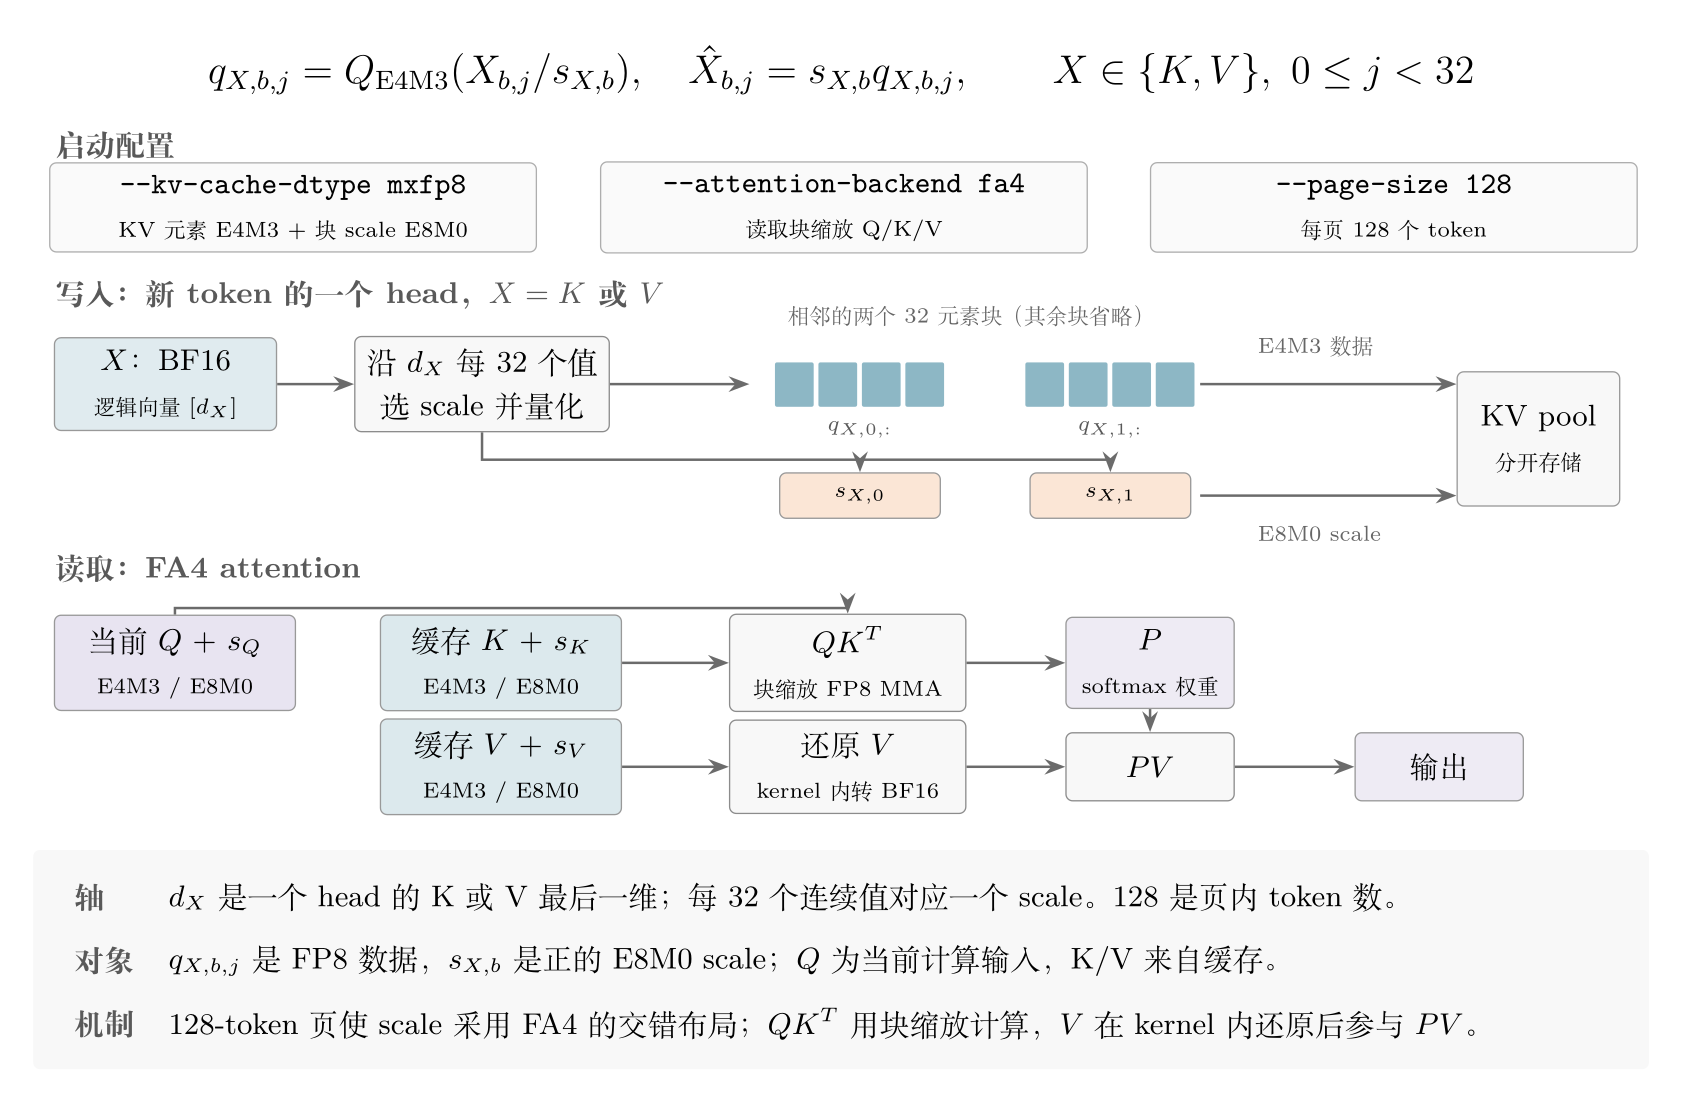
SGLang 的 Inkling 长上下文配置就是个现成的例子:权重用 modelopt_fp4,注意力选 fa4,缓存页大小设为 128,再加上 --kv-cache-dtype mxfp8。配置说明把这条路径标为在 B200、B300、GB300 上已验证。注意这里的 128 是每页容纳的 token 数,而 MXFP8 的 32 是一个 token、一个 head 内沿 head dimension 共享 scale 的元素数,两者说的不是同一种分块。SGLang Inkling 配置
顺着源码看,mxfp8 先把缓存元素类型定为 E4M3,随后专用的 KV pool 为 K、V 分别分配 FP8 数据缓冲和 E8M0 scale 缓冲,每个 head 最后一维每 32 个值对应一个 scale。page_size=128 时,scale 还要重排成 FA4 读取的布局。可见 --kv-cache-dtype mxfp8 不只是换了个 PyTorch dtype,scale 是另一份必须同步读写的数据。dtype 选择、KV pool 分配
新的 K、V 写入缓存时,量化器沿 head dimension 每 32 个数求一次最大绝对值,选一个 E8M0 能表示的 $2^k$,再把除以 scale 后的值舍入成 E4M3;实现里也有把量化和写缓存融合在一起的路径。之后 attention 读缓存时,FA4 会同时拿到 Q、K、V 的 scale:$QK^T$ 走块缩放 FP8 矩阵计算,V 则在 kernel 内还原成 BF16 再参与 $PV$。这是 FA4 这条路径的做法,别的 attention 算子未必这样用 MXFP8。量化代码、scale 传入 FA4、FA4 kernel 注释
下图把配置、写入和读取串了起来。中间只画了一个 token、一个 head 的 $X=K$ 或 $V$,两者各自沿最后一维每 32 个值分一块,FP8 数据和 scale 分开存。当前的 Q 也带着自己的 scale 进入 FA4,但不写进 KV cache。图里两个 32 元素块只是示意相邻分组,head dimension 并不固定是 64。
和普通 E4M3 KV cache 比,MXFP8 的 scale 多得多:忽略布局开销,平均每元素 8.25 bits,而普通 FP8 的张量级 scale 均摊到每个元素上,开销通常接近零。相对 BF16 的 16 bits,MXFP8 还是差不多省一半。scale 更细,有机会减少数值范围不一致带来的量化损失,但不保证每个模型的输出质量都会提高。目前 SGLang 普通的 FP8 KV cache 用的是张量级 scale,这条 MXFP8 路径则是每 32 个值选一个 scale。SGLang 普通 FP8 KV cache 说明
以上 SGLang 路径核对于 2026-09-25 的提交 515f5be,针对的是 Inkling、FA4 和已验证的 GPU 组合。它说明 MXFP8 在推理的 KV cache 上已经用起来了,但推不出后文 SM120 + TE 的训练路径也已经接通。
0.3 为什么 MXFP8 需要专门的硬件支持
如果只是存储 MXFP8,并不需要专门的矩阵指令:软件可以读出 FP8 元素和 E8M0 scale,逐个相乘还原成 BF16/FP32,再做 GEMM。硬件支持要解决的是:既保留低精度计算和数据搬运的优势,又把每块不同的 scale 正确算进矩阵乘加里。
假设点积沿归约维分成多个 32 元素块,A、B 各有自己的块 scale,计算关系是:
\[\hat{y}=\sum_b\left(s_b^A s_b^B \sum_{i=0}^{31}q_{b,i}^A q_{b,i}^B\right).\]普通的张量级缩放只有一对 scale,可以等整段点积算完再统一乘;这里每个 $b$ 的 $s_b^A s_b^B$ 都不一样,没法把系数提到最外层。没有原生的块缩放矩阵指令,软件就只能先把输入解码,或者分块求部分和、缩放后再累加。原生指令则直接读取 FP8 数据和归约维对应的 E8M0 scale,在乘加过程中按块应用,再累加到输出。至于量化时求最大值、选 scale,普通 kernel 就能做,硬件不需要专门提供量化指令。OCP MX 点积定义、CUTLASS 块缩放 MMA 说明
SM120 确实有对应的硬件指令,证据可以直接在 NVIDIA CUTLASS 的 mma_sm120.hpp 里找到。其中 E4M3 × E4M3 的块缩放操作用的是下面这条 PTX 指令(省略了操作数):
mma.sync.aligned.kind::mxf8f6f4.block_scale.scale_vec::1X.m16n8k32.row.col.f32.e4m3.e4m3.f32.ue8m0
这条指令接收 FP8 数据和 UE8M0 scale,沿 K 方向每 32 个元素共享一个 scale,执行 $16\times8\times32$ 的矩阵乘加,用 FP32 累加。CUTLASS 里对缩放粒度也有 VS == 32 的检查。
PTX 的目标架构说明把这组 block-scale 扩展明确列在 sm_120a 下,PTX 8.8 起也支持 sm_120f。所以自己编译这类 kernel 时,要打开对应的架构特性,光看设备查询返回 (12, 0) 是不够的。
到这里,SM120 的硬件能力算是确认了。但框架要用上它,还得准备正确的数据布局、组织好 scale、选对 kernel,再把结果交给下一步计算。
1. SM120 的软件接入
1.1 先把 TN 和 non-TN 读明白
TN 是 GEMM 接口里两个转置标志的组合,依次对应输入 $A$、$B$。先只考虑实数,忽略 GEMM 的标量系数和对旧结果的累加,计算可以写成:
\[C=\operatorname{op}(A)\operatorname{op}(B).\]N 表示直接用输入,T 表示用它的转置;所以 TN 是 $A^T B$,NN 是 $AB$,NT 是 $AB^T$,TT 是 $A^T B^T$。non-TN 泛指 TN 以外的组合,这个 issue 里主要涉及 NN 和 NT。cuBLAS GEMM 定义
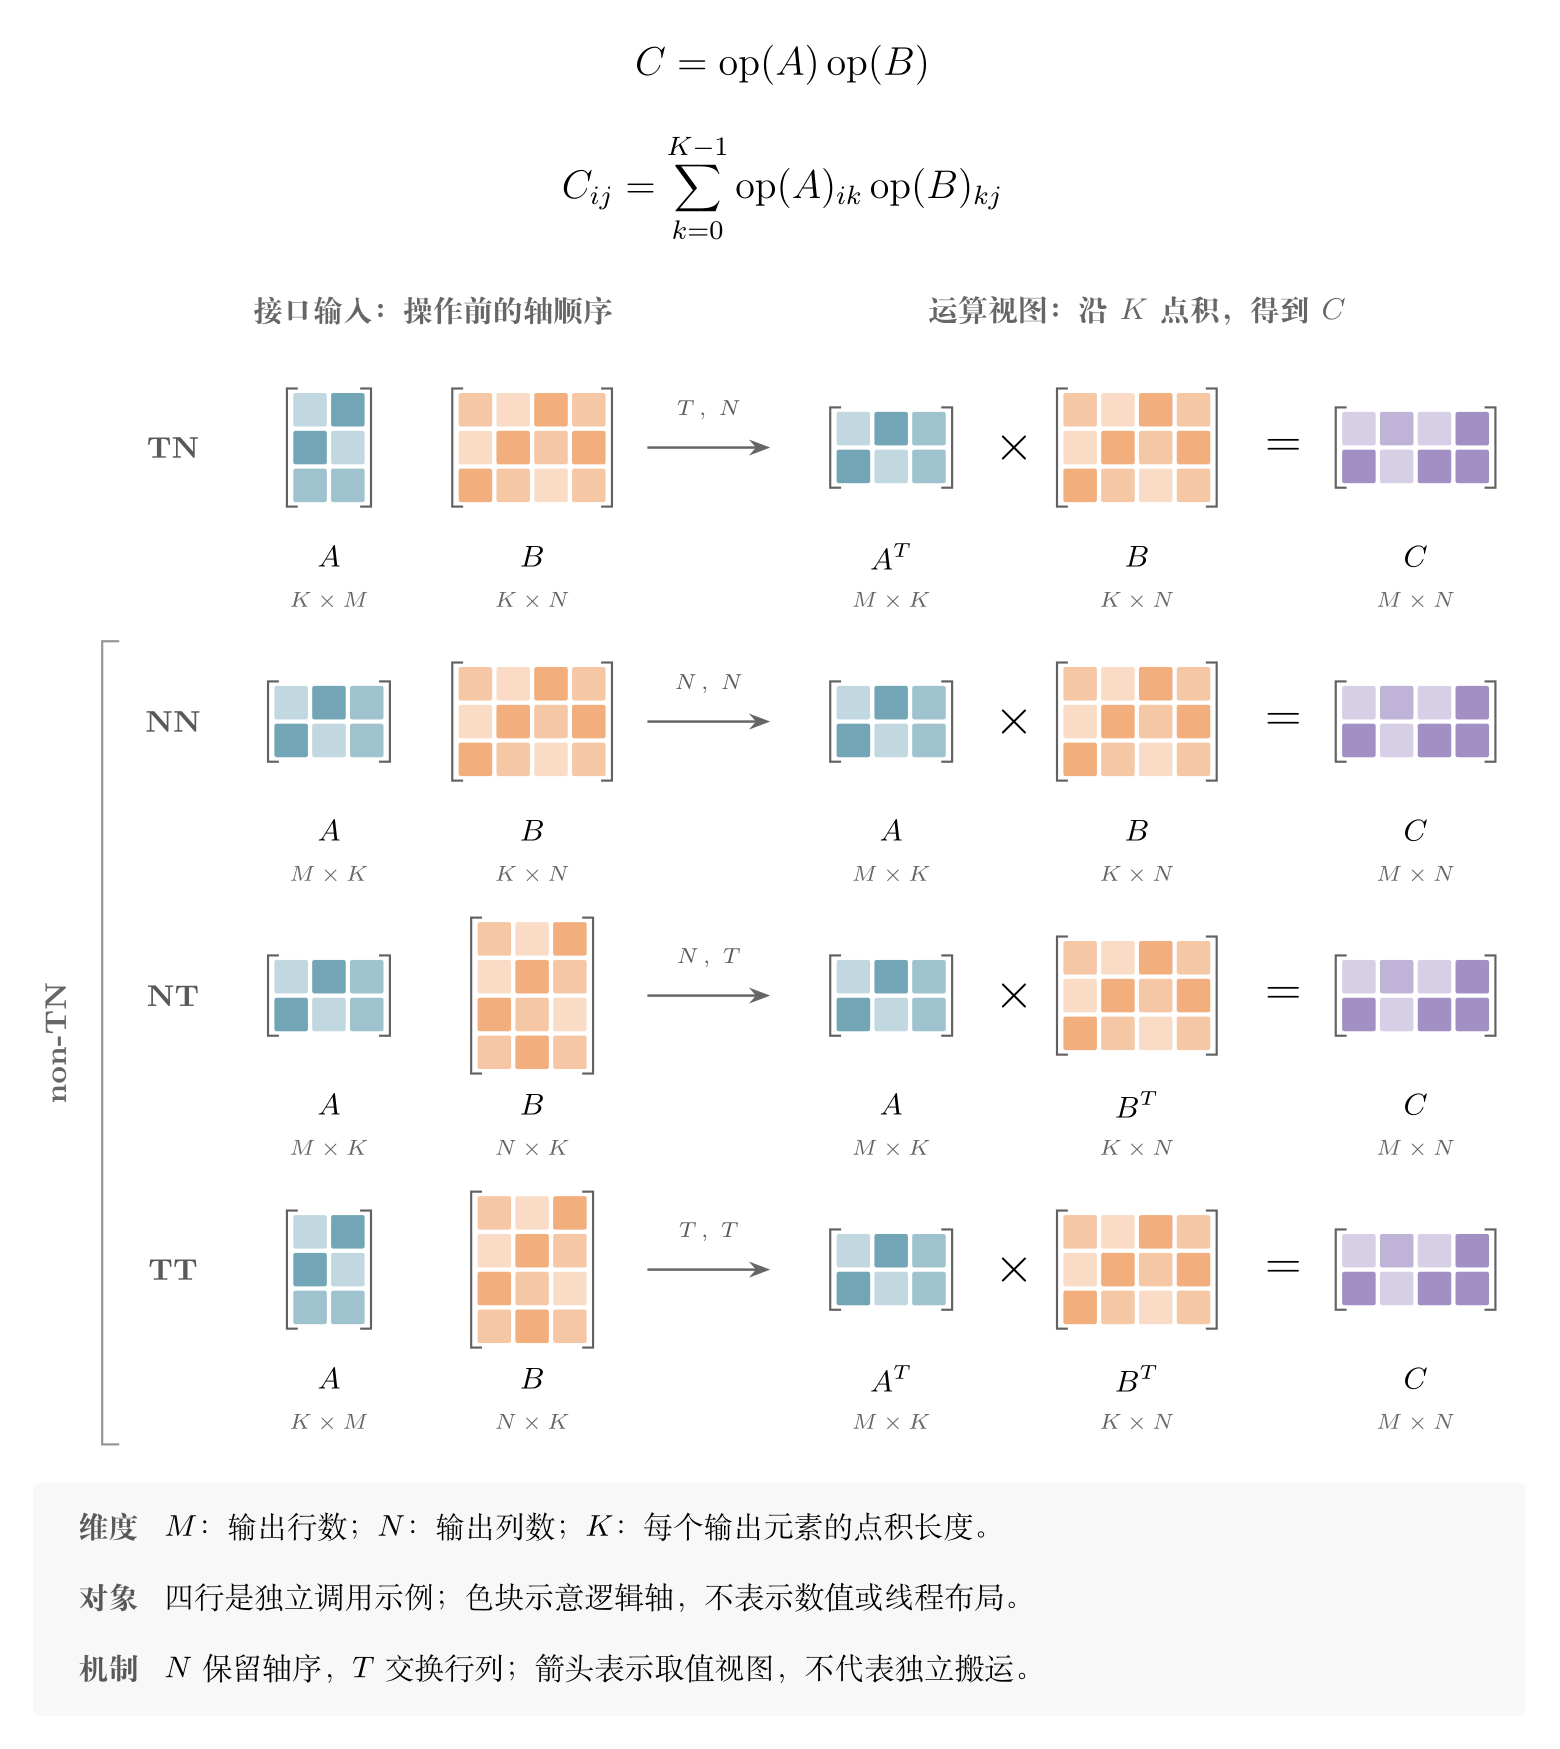
图中四行是四种输入方式的对比,不是先后阶段。每行经过 op 之后,参与相乘的形状都是 $[M,K]\times[K,N]\to[M,N]$:$M$、$N$ 是输出的行数和列数,$K$ 是求和的归约长度。比如 TN 要求输入 $A$ 为 $[K,M]$、$B$ 为 $[K,N]$,NN 的 $A$ 则是 $[M,K]$。图里的矩形和转置箭头只表示逻辑轴的交换,不代表实际的数据搬运或线程布局。
把输出元素展开会更清楚。令 $0\le i<M$、$0\le j<N$,四种组合分别是:
\[\begin{aligned} \mathrm{NN}:\quad C_{ij}&=\sum_{k=0}^{K-1}A_{ik}B_{kj},\\ \mathrm{TN}:\quad C_{ij}&=\sum_{k=0}^{K-1}A_{ki}B_{kj},\\ \mathrm{NT}:\quad C_{ij}&=\sum_{k=0}^{K-1}A_{ik}B_{jk},\\ \mathrm{TT}:\quad C_{ij}&=\sum_{k=0}^{K-1}A_{ki}B_{jk}. \end{aligned}\]比如 TN 固定 $i,j$ 后,是拿原输入 $A$ 的第 $i$ 列和 $B$ 的第 $j$ 列做点积;NN 则是 $A$ 的第 $i$ 行和 $B$ 的第 $j$ 列。两者都沿长度为 $K$ 的轴求和,只是这根轴在原输入里的位置不同。
每种组合下的 $A$、$B$ 都按各自的形状来解释。T 规定的是取哪个元素,并不要求调用前先跑一个 transpose kernel:库可以按交换后的索引直接读现有数据,也可以另外准备一份转置表示。反过来,同一对数组也不能随便换两个字母就得到同样的 $C$,每种组合都要喂给它与 op 相符的输入表示。原数组不符合时,上游还是可能要搬数据或调换操作数顺序。
访问方向为什么要单独适配?按列主序存储时,零起始索引的元素 $(r,c)$ 位于偏移 $r+c\,\mathrm{ld}$,其中 leading dimension(ld)是相邻两列起点之间的元素间距。cuBLAS 数据布局
拿 TN 来看:沿 $k$ 归约时,$A_{ki}$、$B_{kj}$ 的偏移分别是 $k+i\,\mathrm{ld}A$、$k+j\,\mathrm{ld}_B$,两边步长都是 1。换成 NN,$A{ik}$ 的步长就变成了 $\mathrm{ld}_A$;NT 两边都要跨列访问,TT 只有 $B$ 跨列。实际 kernel 还会分块、重排,所以这些地址关系只能解释布局为什么会影响实现,不能直接拿来判断性能高低。
所以“前向 TN、反向 NN/NT”这个说法,要结合下面 TE 的具体调用来理解。它里面包含了存储约定和传参顺序,TN 并不是前向计算的固有属性,也不能光看训练公式里有没有上标 $T$ 来判断。
1.2 issue #2668 卡在前向和反向之间
2026-02-11,TE 维护者在 issue 回复里说明:当时 SM120 上的 MXFP8 支持主要卡在 cuBLAS 的 non-TN GEMM,前向能跑,反向需要的路径还不行;这不是硬件上的根本限制。
训练为什么会碰到不止一种 GEMM?拿线性层说明最直观。设输入 $X\in\mathbb{R}^{M\times K}$、权重 $W\in\mathbb{R}^{N\times K}$,前向是 $Y=XW^T$。令输出梯度为 $G=\partial L/\partial Y$,反向需要:
\[\frac{\partial L}{\partial X}=GW,\qquad \frac{\partial L}{\partial W}=G^T X.\]这三次乘法访问操作数的方向各不相同。关联 PR #3050把 TE 调用的布局写得很清楚:
| 训练阶段 | 计算内容 | PR 中的 cuBLAS GEMM 布局 |
|---|---|---|
| forward | 输出 $Y$ | TN |
| dgrad | 输入梯度 $\partial L/\partial X$ | NN |
| wgrad | 权重梯度 $\partial L/\partial W$ | NT |
表里的 TN、NN、NT 就是前面说的接口组合,对应这条 TE 路径实际发出的调用。
这也是为什么“跑通一次 MXFP8 matmul”还说明不了 TE 的训练 recipe 能用。库可能只实现了 TN,而训练还要走 NN、NT;就算三种 single GEMM 都齐了,MoE 这类场景用的 grouped GEMM 又是另一个入口。
块量化还让转置更麻烦。行方向 $1\times32$ 分组和列方向 $32\times1$ 分组包含的元素不一样,各自量化出来的 scale 和 FP8 数值也可能不同。所以直接转置已经量化好的矩阵,得不到从高精度数据按另一个方向量化的结果,TE 得把这些版本和它们的 scale 布局都管起来。TE 的 MXFP8 转置说明
1.3 为什么 Float8BlockScaling 也能走 MXFP8 GEMM
这里容易把“怎么量化”和“用什么指令算”搞混。TE 的 Float8BlockScaling 用 128 元素的一维块或 $128\times128$ 的二维块,scale 存成 FP32;MXFP8BlockScaling 默认按 32 元素的一维块量化,scale 存成 E8M0。TE blockwise 格式说明
下面只讨论默认的一维量化路径。TE 2.19 另外有个 enable_2d_quantization=True 选项,让权重按 $32\times32$ 块共享 scale,再展开成 MXFP8 需要的 scale 表示,FP8 元素和 E8M0 的编码都没变。recipe 选项、二维量化参考实现
在 TE 的 Blackwell 路径里,前一种 recipe 的 scale 被限制为 2 的幂,所以能转成 E8M0,再按 MXFP8 GEMM 要求的粒度展开。比如一个 128 元素块共用 $s$,就可以拆成四个 32 元素块,四块继续用同一个 $s$,原来的 FP8 数据也不用重新按 32 元素求最大值。
所以即使两条路径最后用的是同一类 GEMM,量化误差也可能不同:Float8BlockScaling 保留的是原先大块的量化结果,原生 MXFP8BlockScaling 则能让这四个小块各选各的 scale。二维大块转换时,也要把对应的 scale 广播到需要的位置。
这是一种复用原生计算能力的软件做法。维护者在 issue 里也确认了 scale 广播这条路线,并提到转换开销跟矩阵尺寸有关,小矩阵上相对更明显;不过 issue 里没有给出能直接推广的加速百分比。维护者答复
继续往源码里看,还能找到两者在 SM120 上表现不同的直接原因。gemm.cpp 在 fp8_block_scaling && sm_arch() >= 100 分支里,把两个输入转换成 MXFP8 GEMM 用的表示,然后固定 transa = true、transb = false,也就是走 TN。GEMM 分支源码
之所以能这么做,是因为 Float8BlockQuantizer 已经准备好了物理转置的 columnwise buffer,转换函数从现有表示里挑数据、复用数据指针,再转换和重排 scale 就行。而 MXFP8Quantizer 的 rowwise、columnwise 数据逻辑 shape 相同,靠不同的量化方向和 GEMM 转置标志参与计算。两条路径对 cuBLAS 布局的要求因此不一样。两种 quantizer 的存储准备、MXFP8 buffer 分配、转换函数
所以 Float8BlockScaling 能借现成的转置表示复用 TN,MXFP8BlockScaling 的训练路径则还得补上 NN、NT。比起“两个 recipe 都调了 MXFP8 kernel”这种说法,这里多追了一层,issue 里看似矛盾的现象也就说得通了。
1.4 当前代码和关联 PR 到了哪里
截至本文核对日期,issue #2668 还是 open。把 TE main 固定到提交 969320524aa14c06477d16bf90a8872066811d70 来看,quantization.py 里的 _compute_mxfp8_support() 对计算能力 12.0 及以上仍然返回 False,理由明确写着“全部 GEMM 布局”还没支持。支持检查源码
不只是主分支,正式发布的 v2.19(2026-09-11 发布)也是同样的判断。v2.19 固定提交的门禁
这比文档里一句“Blackwell 支持 MXFP8”有用得多。当前 TE 2.19 文档的 Supported devices 也只列了 SM 10.0、SM 10.3,没有 SM 12.0。
PR #3050 正在补这块接入,核对时还是 Draft,尚未合并。这个分支打算开放 SM120/SM121 上的 MXFP8 single GEMM,覆盖 TN、NN、NT;同时把 grouped GEMM 的能力检查单独拆出来,grouped GEMM 在这些设备上仍然被拒绝。PR 说明
PR 描述和提交说明里写的依赖是 cuBLASLt 13.6.0.2;固定到 PR 提交 66df3eba33c644d97bfc17b848c479974f1bd500 看,代码实际用 tex.get_cublasLt_version() >= 130600 判断版本。这是开发分支上的条件,并不是说现在装个正式版 TE 加上对应的 CUDA 就能用。PR 分支源码
它还关联了尚未合并的 PR #2833,后者负责 SM120 上非 attention 路径的适配、资源限制和测试覆盖。#3050 的作者建议和 #2833、SM120 CI 一起推进合并,可见这次接入还牵涉测试基础设施,不是放开一个架构判断就完事。
顺带纠正一个常见的版本说法:CUDA 12.8 Update 1 确实已经加入了 Blackwell GeForce 的 block-scaled FP8/FP4 支持,但由此推不出“从这个版本起,TE 的全部 MXFP8 训练路径都能用”。它只说明底层库开始提供相关 GEMM 能力,至于覆盖了哪些布局、哪些接口,还得接着查。
1.5 Megatron-LM #4175 把同一个问题带到了训练入口
Megatron-LM issue #4175 于 2026-04-07 提出。用户在 RTX PRO 6000 上用 MXFP8 时碰到了下面这个错误:
AssertionError: MXFP8 (for all gemm layouts) is not supported on 12.0+ architectures yet.
这条消息和前面 TE 的支持检查对得上,关键还是括号里的 for all gemm layouts:训练需要的路径还没全部接通。当前 TE 的 autocast_enter() 里也保留着这项检查,遇到 MXFP8BlockScaling 时取出可用性和原因,然后据此断言。TE 检查入口
Megatron 当前的源码也能看出这层依赖。固定到提交 dae135048e9fcb9f75c8fe02ccdd54375711162a,get_fp8_recipe() 会把 mxfp8 选项构造成 TE 的 MXFP8BlockScaling;启用 FP8 的层再通过 get_fp8_context() 把这个 recipe 传给 transformer_engine.pytorch.fp8_autocast()。也就是说,Megatron 只负责选择和调用 TE 的量化策略,最终还是要过 TE 的支持检查。recipe 构造、autocast 调用
issue 负责人 sbhavani 回复说,团队还在给 Transformer Engine 加 SM120/RTX PRO 6000 支持,等有了初步 PR 再补充时间计划。后面的参与者也把剩下的依赖指向 TE,并提到 Megatron 这边还需要做验证和兼容性修复。截至 2026-09-22,这个 issue 仍然 open,线程里没有明确的完成日期。负责人回复、后续讨论
所以,光升级 Megatron 或者打开 MXFP8 参数,补不上 TE 和 cuBLASLt 还没提供的执行路径;把支持检查删掉,也只是让程序继续跑向原本被拦住的后端。等 TE 接通之后,Megatron 还得验证自己的训练配置,特别是前后向、并行组合和 grouped GEMM。三个链接各管一段:#4175 是上层训练框架里的实际报错,#2668 解释了底层的布局缺口,#3050 是正在进行的接入工作。
2. 在自己的环境里怎么判断
先记下 GPU、PyTorch、TE 以及实际用到的 cuBLASLt 版本,再问问当前装的 TE 支不支持。下面的检查要在装好 TE、CUDA 可用的 NVIDIA GPU 环境里跑,针对的是本文核对过的 API,不用先启动完整训练:
from importlib.metadata import version

import torch
import transformer_engine.pytorch as te
import transformer_engine_torch as tex

print("GPU:", torch.cuda.get_device_name())
print("Compute capability:", torch.cuda.get_device_capability())
print("PyTorch:", torch.__version__)
print("PyTorch build CUDA:", torch.version.cuda)
print("Transformer Engine:", version("transformer-engine"))
print("cuBLASLt version code:", tex.get_cublasLt_version())
print("TE MXFP8 availability:", te.is_mxfp8_available(return_reason=True))
print("TE blockwise availability:", te.is_fp8_block_scaling_available(return_reason=True))
is_mxfp8_available(return_reason=True) 返回 (bool, reason),回答的是当前安装的 TE 有没有开放这个功能。在 SM120 上返回 False,说的是软件没开放,不是硬件没有这条指令。公开检查 API 源码
torch.version.cuda 是 PyTorch 构建时用的 CUDA 版本,代替不了实际加载的 cuBLASLt 版本,所以上面额外调了 TE 的 tex.get_cublasLt_version(),方便和 PR 的版本门槛对照;不过 tex 是内部扩展接口,以后可能会变。另外,两个 recipe 的可用性检查只是框架层的功能门禁,具体的形状和配置还会影响能不能跑。
如果以后支持检查通过了,下一步先拿一个线性层验证 forward 和 backward,和 BF16 对比输出、输入梯度、权重梯度;涉及 MoE 时再单独验证 grouped GEMM。做性能分析时,要把量化、scale 转换、GEMM 和通信放进同一次 profile,别光看 GEMM 名字就推断整步训练会更快。这里给的只是验证顺序,本文没有这些测试的实测数据。
接下来最值得跟的是:#3050 会不会合并,配套改动什么时候进正式 release,以及 single/grouped GEMM 的支持范围怎么变。回到标题的问题,答案是:SM120 有 MXFP8 硬件能力,TE 仍需要软件适配,而且要适配到实际使用的前向、反向和算子入口。