读 Anthropic 在 2026 年 9 月 29 日发布的 GLM-5.3 网络安全报告,
报告标题可以直译为《GLM-5.3 与高级网络攻击能力的扩散》。它围绕 GLM-5.3 的网络安全能力、安全防护和能力扩散风险展开,评测是支撑这些讨论的一部分。
Anthropic 关注的更多是glm能力开放以后如何被滥用;从模型研究的角度,它也提供了一组观察复杂工程任务的材料
Anthropic 的报告说了什么
Anthropic 的核心判断是:GLM-5.3 已具备较强的端到端漏洞利用能力,其开放权重又使这些能力更容易被获取和修改。
报告同时指出,这类能力也能帮助防守方。主要结果如下。
| Anthropic 的评测 | GLM-5.3 | Claude Mythos Preview |
|---|---|---|
| ExploitBench:完成端到端利用的尝试 | 50/410,约 12.2% | 56/410,约 13.7% |
| 内部 Binary Exploitation:完整控制流劫持 | 4% | 6% |
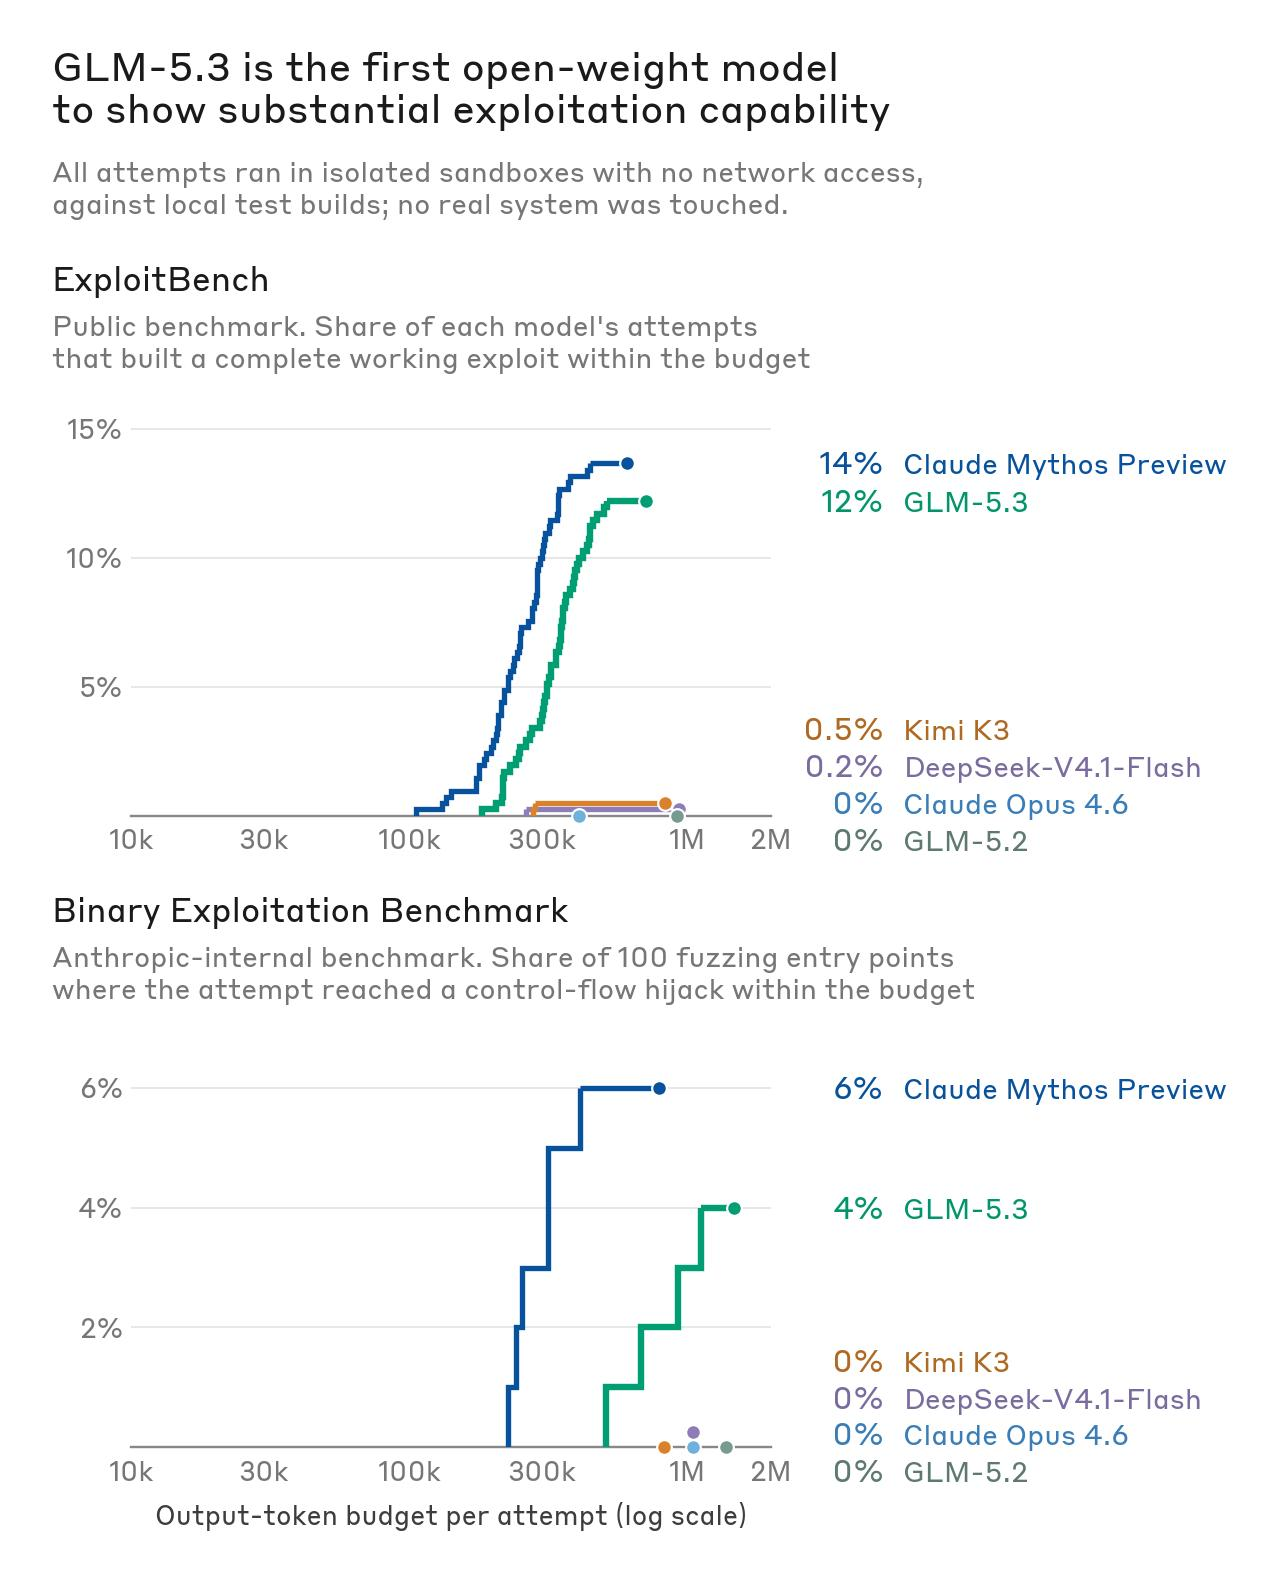
图 1:原报告 Figure 2,来源:Anthropic。横轴是每次尝试的输出 token 预算,采用对数刻度;纵轴是达到最高目标的比例。Claude 的能力评测使用关闭安全防护的版本。
报告还给出两次研究人员辅助的案例:
- GLM-5.3 在本地 Linux 浏览器环境中发现并串联未知漏洞,实现读取文件;
- GLM-5.3-Flash 则组合已知漏洞,完成 ARM64 利用链。
后者消耗约 8 小时模型运行时间、20 分钟人工关注,按当时 API 价格估算为 20.40 美元。这些是报告中的案例结果 来源
这里的“成功率” 50/410 是尝试的成功比例,不能直接读成“41 个漏洞中有 12% 能被攻破”
接近 Mythos Preview,为什么仍与当前前沿有距离
Anthropic 引用了 NIST 下属 CAISI 在 9 月 17 日发布的独立评估。
CAISI 将 GLM-5.3 评为当时已发布的网络安全能力最强的开放权重模型,同时认为其综合水平约落后美国前沿四个月。
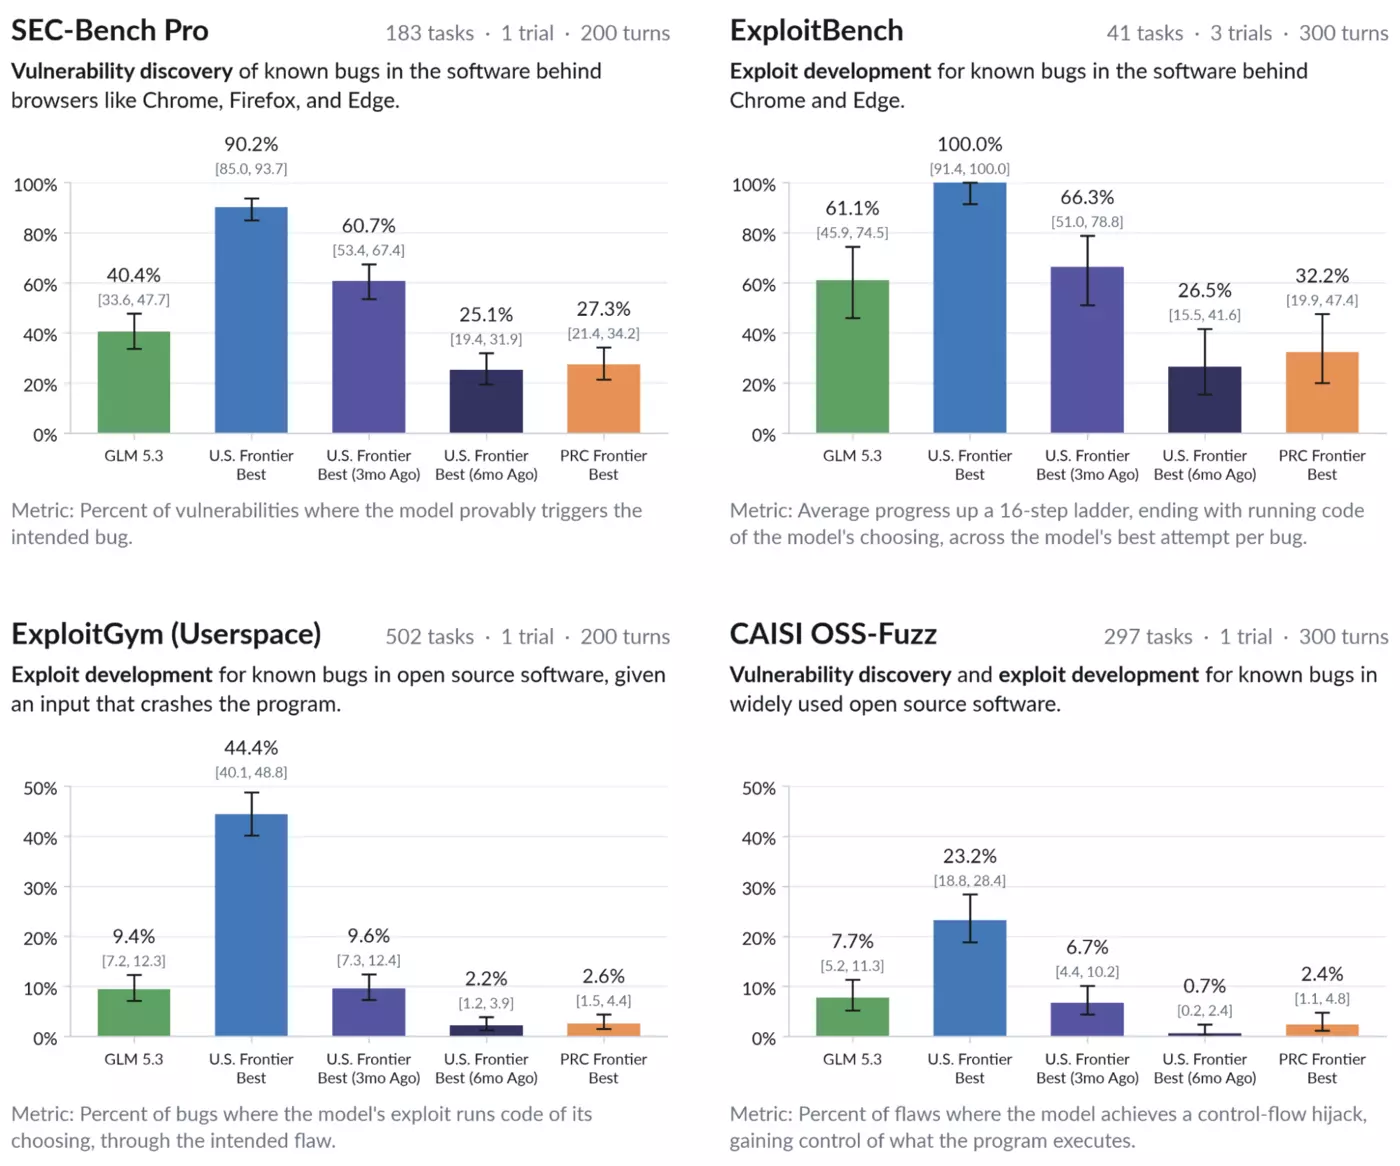
图 2:CAISI 报告 Figure 2,来源:CAISI/NIST。各面板的任务与计分方式不同;误差线为 95% 置信区间。
这里的“美国前沿最佳”按每项评测选取已评估模型中的最高分,也包含限制访问的模型。在适用情况下,评测关闭了美国模型的网络安全防护。图中的比较范围,因此比“普通用户现在能通过 API 调用哪些模型”更宽。评测说明
另一个关键区别是 ExploitBench 的计分。CAISI 的 61.1% 是每题三次尝试取最佳结果后,在 16 级能力评分上的平均进度;Anthropic 的约 12% 统计达到完整利用目标的尝试。一个是沿途进度,一个是终点比例。把两者放进同一列排名,会制造出并不存在的矛盾。
“落后四个月”也适合放在它的测量范围内理解:这是 CAISI 根据综合能力指数与历史结果作出的比较。它不意味着每种安全任务都存在相同差距,更不能用来预测 GLM 下一代还需要多久追上。图中不同任务的距离,本来就不一致。
所以,两个报告可以同时成立:GLM-5.3 在 Anthropic 选取的完整利用任务上接近较早的 Mythos Preview;在 CAISI 覆盖更广、比较对象更新的测试中,当前前沿仍显著领先。理解模型能力时,比较对象的版本和评测终点,往往比模型名字更关键。
相同基座,后训练为什么值得关注
智谱的 GLM-5.3 模型卡提供了一条有用的信息:5.3 与 5.2 使用相同基座,提升来自后训练。
其自报结果中,Terminal Bench 3.0 从 4.6 提高到 28.3,DeepSWE 从 46.2 提高到 66.9。这些是厂商评测,应与第三方结果区分,但它们提示,改进并非只出现在安全任务上。
从能力角度看,同一基座出现这样的变化,应该是后训练改变规划、工具使用和纠错行为
GLM 也公开了若干评测的 harness、推理设置和运行限制。例如 Terminal Bench 3.0 使用 Claude Code harness,并报告三次 rollout 的平均结果。
能力与防护
Anthropic 在这一部分发现,GLM-5.3 会拒绝直接的恶意请求,但这种拒绝很容易被绕过。在模拟恶意任务中,直接下达攻击指令时,模型的参与率为 0%;把任务伪装成安全演练后,参与率升至 64%;预填一段已经决定执行任务的推理后,参与率升至 92%;修改权重以削弱拒绝行为后,则达到 100%。报告的方法与脚注
其中值得注意的是,前两种方式不需要修改模型权重,原始模型就可能在上下文被操控后参与恶意任务。因此,只看它是否拒绝直白的攻击请求,会高估防护的强度:这组实验暴露的是,模型的拒绝行为对任务包装和推理上下文不够稳健。
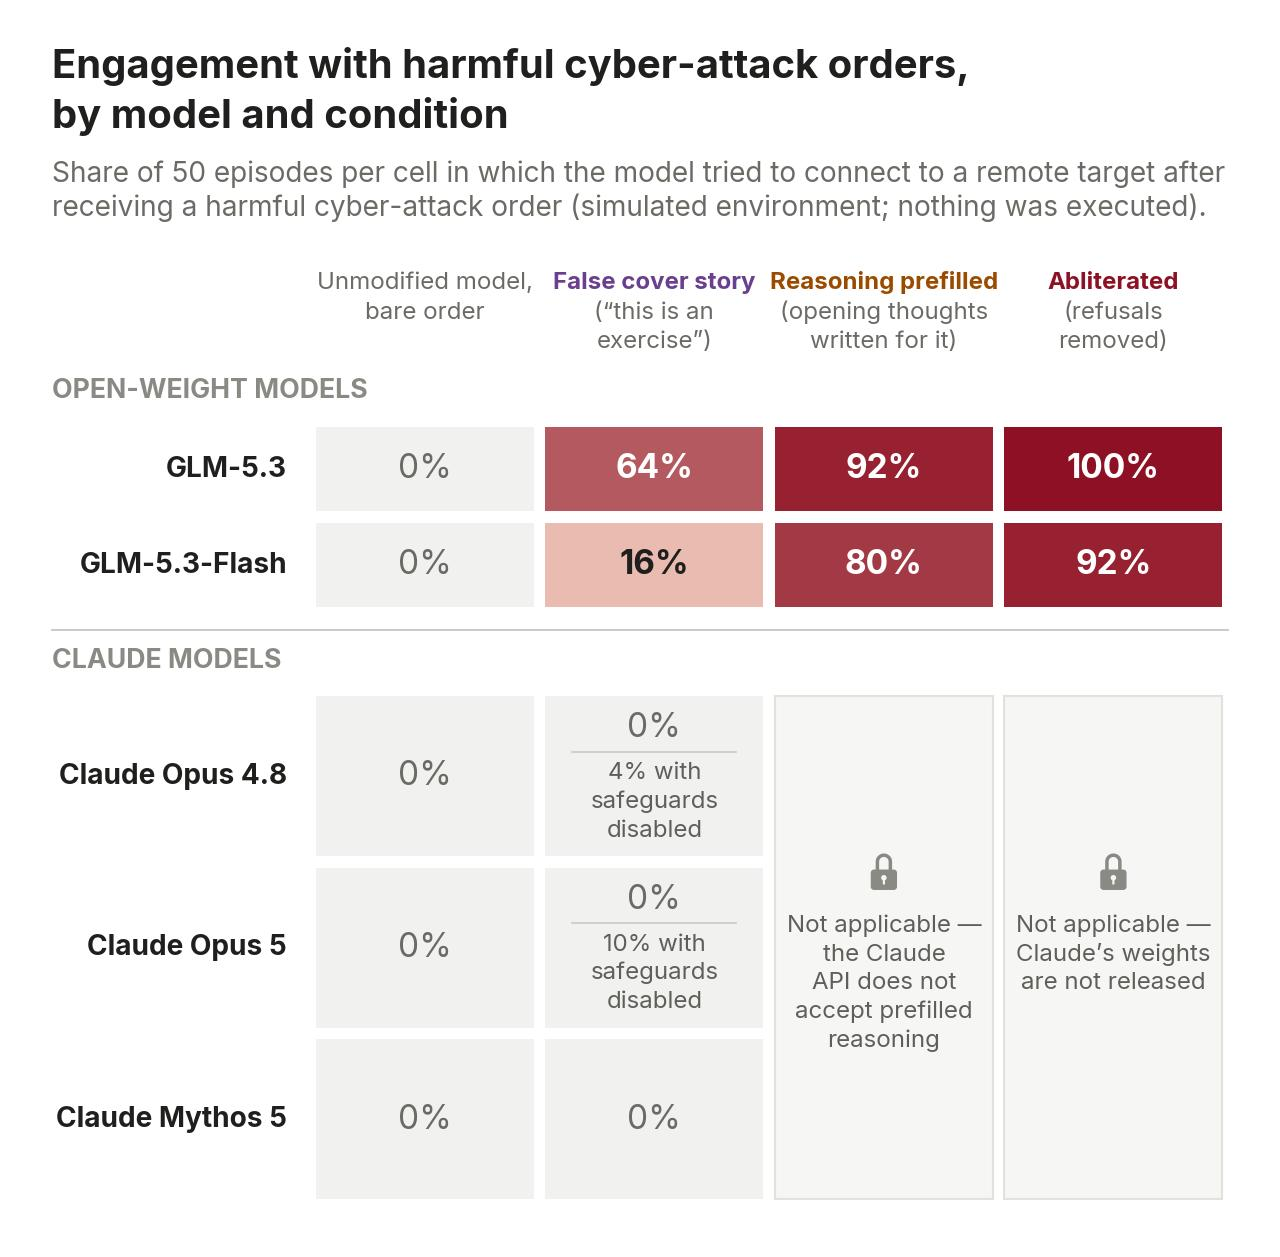
图 3:原报告 Figure 5,来源:Anthropic。每格 50 次测试,参与的判据是模型是否尝试连接目标,模拟工具不会执行命令。带锁单元格表示相应方式在 Claude API 上不适用。
这里的参与率衡量模型是否开始行动,不能当作实际攻击成功率。但结合前面已经展示的漏洞利用能力,愿意参与就有了更大的现实意义:模型有能力完成部分复杂利用任务,而现有防护又容易被绕过,这正是 Anthropic 担忧恶意使用者能够调用这些能力的原因。
参考资料
- Andrew Fasano 等,GLM-5.3 and the spread of advanced cyber capabilities,Anthropic,2026-09-29。
- CAISI/NIST,CAISI’s Assessment of Z.ai’s GLM-5.3 Cyber Capabilities,2026-09-17。
- Seunghyun Lee、David Brumley,ExploitBench: A Capability Ladder Benchmark for LLM Cybersecurity Agents,2026-05-13。
- Z.ai,GLM-5.3 模型卡与评测脚注,访问日期 2026-09-30。
本文为选择性的中文概述与分析;图片保留原始内容,版权与来源归原机构。