看到 Fast-WAM 的结构图,很容易把它理解成“Wan 负责视频,旁边接一个随机初始化的 action encoder”。但沿着官方代码往下看,事情更有意思:默认训练配置不仅加载 Wan 的 video DiT,还把 Wan 的权重缩到较小的 hidden dimension,用来初始化 action DiT 的主干。真正保留随机初始化的,是动作输入投影、动作输出投影,以及把机器人自身状态接入模型的 proprio encoder。初始化代码把这件事写得很明确。
另一个容易混淆的地方是名字里的 Fast。它主要省掉了推理阶段的未来视频生成,训练时仍然同时做视频建模和动作学习;推理时 action 也仍然需要去噪。论文所谓 single forward pass,指的是 video backbone 对当前观测只编码一次,不是整个策略一次前向就直接得到最终动作。论文 §3–4
这篇笔记就从这两处出发,拆开看预训练权重、token 拼接、动作表示、训练成本和最终 checkpoint。论文依据是 2026-03-23 的 arXiv v2,源码固定在官方仓库 commit 7faa711。后者已经包含论文之后的优化和新变体,涉及差异时会分别说明。
Wan 到底提供了什么
Fast-WAM 使用的基础模型是 Wan-AI/Wan2.2-TI2V-5B,复用三个部分:video DiT、视频 VAE、T5 文本编码器。
VAE 把相机图像或训练视频压到 latent 空间,T5 把任务指令变成文本条件,video DiT 则在这个 latent 空间里学习视觉表征和未来视频的生成目标。这里的“没有 embodied pretraining”指没有额外的大规模机器人预训练,Wan 的视频预训练已经存在,后面也还要用 benchmark 的机器人示范训练。论文 §3.2、§4.1
在这套基础组件上,作者增加一个约 1B 参数的 action expert DiT。论文把 video DiT 与 action DiT 合计描述为约 6B;这不是一个只训练小动作头的方案。公开训练器将 model.dit 指向整个 MoT,因此 video/action 两个 expert 都参与微调;VAE 和 T5 冻结,额外的 proprio encoder 参与训练。配置中 load_text_encoder: false 也不代表去掉语言输入,而是默认训练可直接读取预先计算好的 T5 embedding。模型配置 训练器
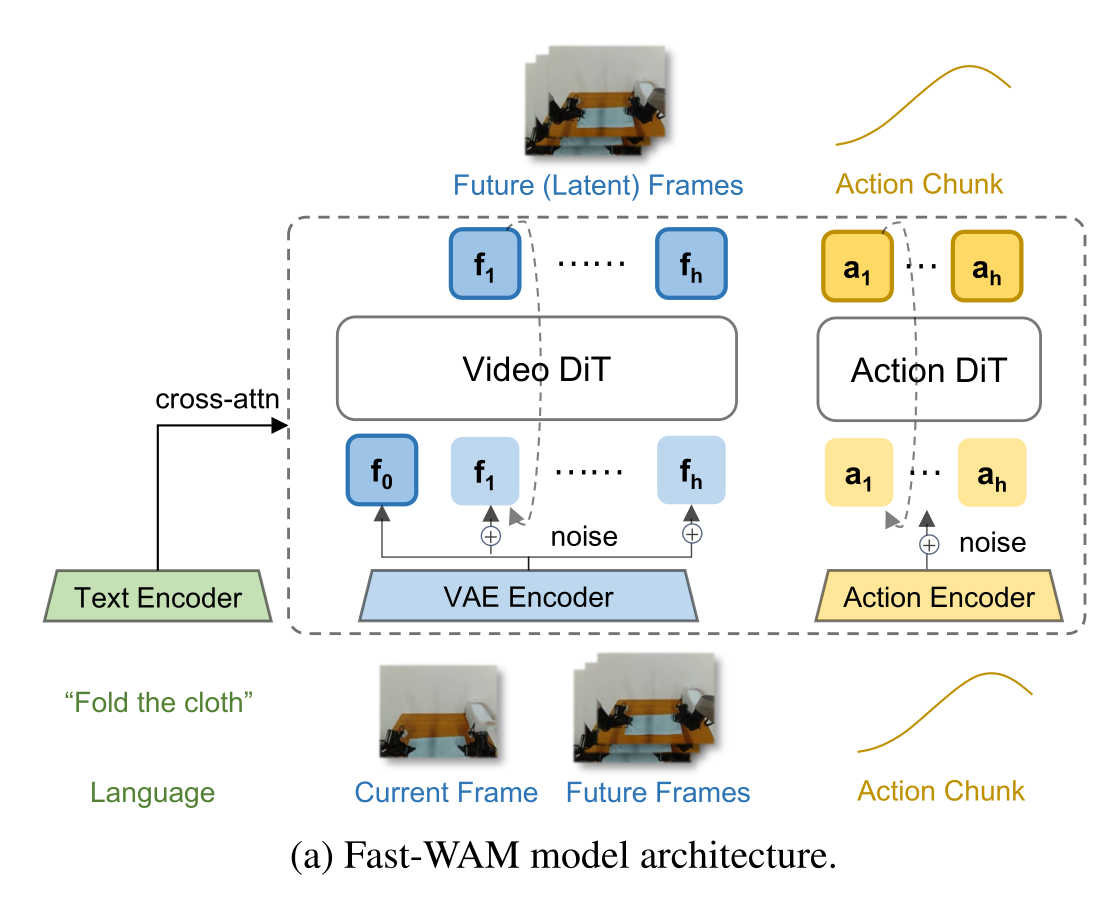
原图摘自 Tianyuan Yuan 等的 Fast-WAM 论文 Figure 2(a)(CC BY 4.0,仅裁剪)。从下往上看:左边的指令经 Text Encoder 形成 cross-attention 条件;中间当前帧和未来帧经 VAE 进入 Video DiT;右边连续动作经 Action Encoder 进入 Action DiT。当前帧 $f_0$ 保持干净,未来帧与 action 加噪后分别学习生成目标。图里的上下两条 Action Chunk 分别是训练目标输入和动作生成分支的输出示意。
这张图主要画的是训练结构:未来视频出现在输入和监督中。它没有展开两个 expert 在每一层如何共享 attention,也没有画出公开实现中的 proprio 条件路径;这两部分要结合下面的源码解释来看。
两个 expert 的 residual stream 并不一样宽。当前配置的 video hidden dimension 为 3072、FFN dimension 为 14336,action hidden dimension 为 1024、FFN dimension 为 4096。它们都有 30 层、24 个 attention heads,每个 head 为 128 维,所以 Q/K/V 投影后的总宽度都为
\[24\times128=3072.\]这正是两个不同宽度的 Transformer 能一起做 attention 的接口。action 的 hidden state 是 1024 维,但进入 attention 时会投影到共同的 3072 维,attention 结果再投影回自己的 1024 维。不能因为 action hidden dimension 小,就把它的 head dimension 也按 1024 / 24 来算。模型配置 attention 实现
那么 action expert 从哪里开始学?公开代码先构建 ActionDiT,然后对能与 Wan 对应的参数做迁移:形状一致的直接复制,形状不同的沿需要变化的维度依次做一维线性插值;如果二维及以上参数的最后一维发生变化,还默认乘上
\[\alpha=\sqrt{d_{\mathrm{src}}/d_{\mathrm{dst}}}.\]这里的两个 $d$ 是该参数最后一维的源、目标大小,不是每个参数都机械乘同一个系数。例如最后一维从 3072 缩到 1024 时,系数才是 $\sqrt{3}$。这是一种权重初始化办法,没有在这一步训练一个压缩模型,也没有通过教师输出做蒸馏。预处理脚本
加载器排除了两个参数前缀:
ACTION_BACKBONE_SKIP_PREFIXES = ("action_encoder.", "head.")
因此默认路径可以画成下面这个关系:
Wan 预训练权重 ────────────→ video DiT
       └─ 复制 / 插值 / 缩放 → action DiT 主干
随机初始化 ───────────────→ action_encoder、action head、proprio_encoder
机器人示范 + 视频目标 ─────→ 联合微调两个 DiT 和 proprio_encoder
其中 action_encoder 只是一个 Linear(action_dim, 1024),不是独立的大型动作编码网络;head 则把 1024 维 hidden state 投影回动作维度。proprio_encoder 是另一条输入路径,将机器人当前状态投影到 4096 维文本条件空间。ActionDiT FastWAM 实现
代码也支持不提供 action backbone 路径时随机初始化整个 action expert,但默认配置提供了插值后的权重文件。推理配置中的 skip_dit_load_from_pretrain: true 则用来跳过基础 DiT 权重加载,随后由训练好的 checkpoint 覆盖;这不表示最终部署的是随机权重。论文正文没有展开上述初始化算法,因此这里回答的是公开实现的默认路径。模型配置 评估配置
“拼接”要分清三条路径
第一条发生在图像空间。多个相机在同一时刻拍到的图像先拼成一张图,然后再送进 VAE。LIBERO 把主相机和腕部相机各自 resize 为 $224\times224$,水平拼成 $224\times448$。RoboTwin 则把主相机放在上面,左右腕相机并排放在下面,最终得到 $384\times320$ 的组合图像。它们没有在这里给每个相机各配一个独立的 Wan expert。LIBERO 数据配置 RoboTwin 数据配置 图像拼接实现
第二条发生在 Transformer 的 attention 里。video token 和 action token 先分别进入自己的 expert,使用各自的参数生成 Q/K/V,再沿 token 序列轴 拼接这些投影结果。以训练的一层为例,令视频序列长度为 $N_v$、动作长度为 $H$,投影后可以写成
\[Q_v,K_v,V_v\in\mathbb R^{B\times N_v\times24\times128},\qquad Q_a,K_a,V_a\in\mathbb R^{B\times H\times24\times128},\] \[Q=[Q_v;Q_a],\quad K=[K_v;K_a],\quad V=[V_v;V_a].\]这里分号表示沿序列轴 concat,因此共同序列长度为 $N_v+H$。共享 attention 算完后,按原来的 token 范围切开,各自经过所属 expert 的输出投影、语言 cross-attention 和 FFN。MoT 实现
所以,拼接确实存在,但没有把 3072 维视频 hidden state 和 1024 维动作 hidden state 原封不动塞进同一个 residual stream。两条分支保留不同的参数和宽度,共享的是 attention 运算及其信息交换空间。这个 MoT 按模态处理 token;代码中没有一个 router 为每个 token 动态选择稀疏 expert。
第三条是条件序列。T5 输出的语言 embedding 为 $B\times L\times4096$,当前 proprio state 经线性投影后形成一个 $B\times1\times4096$ 的 token,接在语言条件后面。video/action 两条分支都通过 cross-attention 读取这份条件。语言和 proprio 因此不是图里那三组 self-attention token 的一部分。FastWAM 实现
还有一个数量上的细节值得算一下。每个训练 chunk 包含 32 个动作步,视频按动作时间的四倍间隔采样,得到包括当前帧在内的 9 张图。Wan VAE 还会继续做时间压缩,这 9 张图对应 3 个 latent 时间位置;不能把“9 张采样视频帧”直接当成“9 组 DiT latent frame token”。论文 §4.1 Wan VAE
按 VAE 的空间 $16\times16$ 压缩和 DiT 的 $(1,2,2)$ patch size 手算,LIBERO 当前帧的空间 token 数是
\[N_0=\frac{224}{16\times2}\times\frac{448}{16\times2} =7\times14=98.\]三个 latent 时间位置合计 294 个视频 token,加上 32 个 action token,训练序列长度为 326;推理只保留当前帧的 98 个视频 token 和 32 个 action token,长度为 130。RoboTwin 对应的当前帧 token 数为 $12\times10=120$,训练/推理序列长度分别为 392/152。这些是公开配置下的逻辑形状手算,不是物理存储布局或性能测量。模型配置 Wan 说明
action 看不到未来视频,视频监督还有什么用
只有拼接还不够,Fast-WAM 的设计关键在 attention mask。把训练 token 分成三组:$C$ 是干净的当前帧 latent,$F$ 是加噪的未来视频 latent,$A$ 是加噪的 action chunk。mask 让 $C$ 只读取当前帧内部的 token;$F$ 读取 $C$ 和未来视频内部的 token;$A$ 读取 $C$ 和动作内部的 token。论文 Figure 2
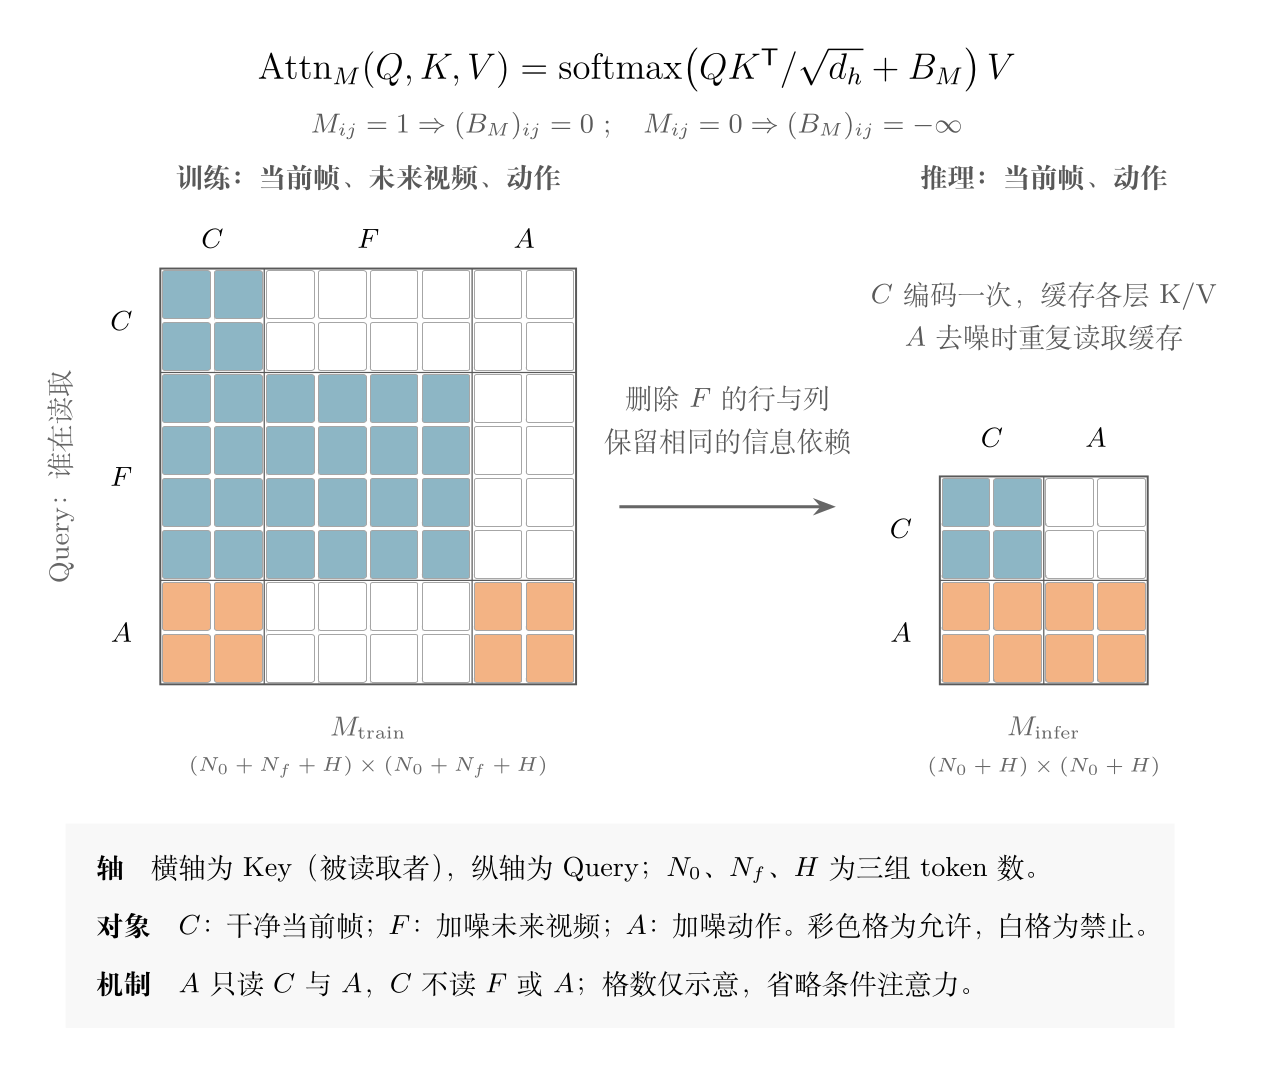
图按论文 Figure 2(b) 与源码重新绘制。每个分块代表一组 token 内部的完整可见性,格数只示意轴结构。箭头表示推理时删除未来视频组,保留当前帧与动作之间的信息依赖;不是训练结束后把一个样本搬运到推理阶段。
这就回答了一个直觉上的疑问:训练时有未来视频,action 会不会偷偷看到了答案?在默认 Fast-WAM 中,$A\rightarrow F$ 被禁止,而且 $C$ 也不能读取 $F$,所以未来信息不会绕道当前帧流入 action。与此同时,video token 也不读取 action token;当前默认配置的 action_conditioned 为 false。这一路辅助目标是在当前观测、语言和 proprio 条件下预测未来视频,不是把候选 action 喂进去、再逐个模拟其后果的规划器。FastWAM mask video mask 模型配置
未来视频依然有用,因为 $C$ 和 $F$ 由同一套 video DiT 参数处理。视频预测损失会更新这些参数,也会通过对当前帧的读取训练上下文表征;action expert 读取的正是这套主干产生的当前帧信息。于是视频监督可以通过共享参数与当前帧表征影响动作学习,不需要在推理时真的生成一段未来视频。这是结构上能成立的训练路径,是否有实际收益则要看后面的消融实验。
video 和 action 都使用 flow matching。用 $y$ 表示干净目标——未来视频 latent 或连续动作——采样高斯噪声 $\epsilon$,构造
\[y_t=(1-t)y+t\epsilon, \qquad u_\theta(y_t,t,\mathrm{context})\approx\epsilon-y.\]模型学习的是这条噪声插值路径的速度场。总损失为
\[\mathcal L=\mathcal L_{\mathrm{act}}+\lambda\mathcal L_{\mathrm{vid}}.\]当前实现对视频和动作分别采样噪声及时间,保持第一帧干净,并在视频 loss 中排除这一帧。这里的 $t$ 是噪声时间,不是机器人动作序列中的第几个时间步。论文 §3.2 训练 loss 实现
action 是连续控制量,输出是一整个 chunk
Fast-WAM 的 action token 没有经过离散词表编码。训练输入是一个 $B\times H\times D_a$ 的浮点张量,每个时间步一个连续控制向量;默认 $H=32$。加噪后,它经过线性 action_encoder 变成 $B\times32\times1024$ 的 hidden state。经过 action DiT,输出 head 再投影回 $B\times32\times D_a$,预测 flow velocity。ActionDiT
动作维度和含义随机器人接口变化,当前两个公开配置分别是:
| 配置 | 每步 action | 当前 proprio | 归一化 |
|---|---|---|---|
| LIBERO | 7 维:末端位置/旋转的 6 维增量,加 1 维夹爪控制 | 8 维 | min/max |
| RoboTwin | 14 维:双臂关节位置与夹爪控制,部署接口使用 qpos |
14 维 | z-score |
这里的 action 和 proprio 是两回事:前者是接下来要执行的控制量,后者是当前机器人状态。LIBERO 的夹爪还需要在评估包装里转换到环境使用的符号约定,因此网络输出不能不经处理就直接送给任意机器人。LIBERO 数据配置 RoboTwin 数据配置 LIBERO 部署 RoboTwin 部署
推理从形状为 $1\times32\times D_a$ 的高斯噪声开始。先把当前组合图像编码成 latent,以 video 噪声时间为 0 跑一次 video DiT,并缓存每一层的 K/V。接下来 action expert 在多个去噪步里反复读取这些缓存:
\[O_a^{(\ell)}= \operatorname{Attn}\!\left( Q_a^{(\ell)}, [K_C^{(\ell)};K_a^{(\ell)}], [V_C^{(\ell)};V_a^{(\ell)}] \right).\]每一步的动作 Q/K/V 都会变化,当前帧的缓存则保持不变。缓存是各层的视觉 K/V,不是只取最后一层一个 pooled embedding;它在同一 chunk 的去噪循环内复用,新观测到来后需要重新编码。MoT cache 动作推理实现
论文设置为 10 步去噪、CFG scale 1.0。沿 $t=1\rightarrow0$ 的调度更新动作后,infer_action 返回一个浮点 action 张量;单样本 LIBERO 的形状为 $32\times7$,RoboTwin 为 $32\times14$。标准快速控制路径没有生成未来视频,也没有解码未来 RGB 图像。论文 §4.1 动作推理实现
评估包装再反归一化这个 chunk,将其中前几步放进动作队列,执行后重新获取观测并预测下一段。当前公开配置的 LIBERO replan_steps 为 10,RoboTwin 为 24。因此“预测 32 步”不等于每次都盲目执行完 32 步,也不等于输出一条覆盖整个任务的长轨迹。LIBERO 评估配置 RoboTwin 评估配置
从这条执行路径看,Fast-WAM 用 Wan 学到的世界表征驱动一个连续动作生成器。它没有显式搜索很多候选动作轨迹,也没有在推理时输出一份自然语言计划。
推理确实快,训练成本要另算
Fast-WAM 在训练时仍然处理未来视频 token,并反向更新 video/action 两个 DiT。flow matching 训练通常对每个样本采样一个噪声时间来计算 loss,不需要在每个训练 step 展开完整的 10 步采样过程;但这也不意味着只训练一个很小的线性层。训练 loss 实现
论文给出的训练规模如下:
| 实验 | 机器人示范数据 | 论文训练步数 |
|---|---|---|
| LIBERO | 四个 suite,每个 10 个任务、500 条示范 | 20k |
| RoboTwin 2.0 | 多任务混合,2,500 条 clean 示范和 25,000 条随机化示范 | 30k |
| 真实毛巾折叠 | Galaxea R1 Lite,60 小时遥操作示范 | 30k |
这些数据说明它可以直接从 Wan 起步,在下游示范上获得较好的结果。可是 step 数和示范小时数都不是训练墙钟时间:论文没有报告完整的训练耗时、GPU-hours 或相对于其他 WAM 的训练加速比。论文 §4.2
公开 README 补充了训练资源:LIBERO 使用单机 8 张 GPU,RoboTwin 使用 64 张 GPU 来加速训练。当前 task 配置的每进程 batch size 为 16,梯度累积为 1;按这些条件手算,8 卡和 64 卡分别对应全局 batch 128 和 1024。公开 YAML 已改为 LIBERO 10 epochs、RoboTwin 5 epochs,max_steps: null,所以直接运行今天的配置不等于自动复现论文的 20k/30k steps。官方 README LIBERO task 配置 RoboTwin task 配置
仓库后续更新还报告:在 H20 上,编译 denoising core、批量 VAE 编码和 CUDA Graph 路径让训练约快 10%;在线算 T5 相比缓存文本 embedding,训练吞吐约低 10%。这是作者对后续实现的报告,不是我在本机的实测,也不能据此换算出论文训练了几小时。官方 README 的更新说明
因此,对“训得快吗”的回答是:它省去了额外的大规模机器人预训练阶段,但下游训练仍是一套约 6B DiT 的联合微调;现有材料不足以说训练很便宜。 真正有明确延迟数据的是推理。
论文 Figure 4 在同一张 RTX 5090D V2 32GB 上报告:Fast-WAM 为 190 ms,Fast-WAM-Joint 为 580 ms,Fast-WAM-IDM 为 810 ms。按图中数字计算,它相对 Joint 约快 3.1 倍,相对 IDM 约快 4.3 倍。不能把摘要里的“超过 4 倍”理解成对每个对照都超过 4 倍。论文 Figure 4
190 ms 是一次策略推理的延迟,也不能直接说机器人控制频率只有约 5 Hz:一次推理产出多个控制步,执行接口以自己的频率消费它们。反过来,只根据 chunk 长度和推理延迟,也不能推导出系统一定能满足某个控制周期。
后续 README 报告了包含文本编码和 VAE 编码的端到端优化结果:H20 从 470 ms 降到 210 ms,RTX 4090 从 190 ms 降到 110 ms。它们使用不同硬件与后续代码,应当与论文 5090D V2 的 190 ms 分开看。官方 README
不同 benchmark 使用什么权重
先区分两个层次:Wan checkpoint 是通用的预训练起点,Fast-WAM checkpoint 是经过机器人示范训练后的策略。训练完成保存的 mot 包含 video 和 action 两个 expert 的参数,另外保存 proprio encoder;冻结的 VAE/T5 则作为基础组件另行加载。因此交付物并非只有一个 action encoder 或 action head。checkpoint 实现
截至 2026-09-30,作者的 Hugging Face 模型库 公开了下面两组标准 Fast-WAM 文件:
| Benchmark | 策略权重 | 配套统计文件 |
|---|---|---|
| LIBERO | libero_uncond_2cam224.pt |
libero_uncond_2cam224_dataset_stats.json |
| RoboTwin | robotwin_uncond_3cam_384.pt |
robotwin_uncond_3cam_384_dataset_stats.json |
所以 LIBERO 和 RoboTwin 确实使用不同权重,而且要配各自的输入处理、action dimension 和归一化统计。一个输出 7 维动作,一个输出 14 维动作,无法只替换任务指令就把两套部署接口互换。发布与评估说明
但在 LIBERO 内部,当前公开训练配置同时列出 Spatial、Object、Goal、Long 四个数据目录,发布与评估入口使用同一个 LIBERO checkpoint 跑四个 suite。按这个公开流程,没有为每个 suite 或每个任务分别发布一份标准策略权重。论文 §4.2 只说在四个 suite 上训练,没有单独说明历史实验 checkpoint 的划分,不能用这句话反推所有历史实验的权重组织方式。LIBERO 数据配置 官方 README
RoboTwin 也采用多任务训练,一个 checkpoint 面向多个任务,结合不同语言指令评估 clean/randomized 场景。真实毛巾折叠则是另一个机器人与数据设置,论文单独训练 30k steps;目前上述模型库文件列表没有提供该真实任务的 checkpoint。论文 §4.2 模型文件列表
文件名里的 uncond 也容易误导。这个配置仍输入语言和 proprio,只是没有让 video branch 直接读取 action 条件;它不表示没有任务指令。模型配置 数据配置
后续代码还增加了 Optional IDM,模型库中对应 libero_optional_idm_2cam224.pt 及其 stats。它通过同一份训练好的权重支持两种推理模式:idm 先预测未来视频,再产生 action;first_frame 只用当前帧,走快速动作路径。这是“一份权重切换是否 imagination”,和“LIBERO、RoboTwin 共用一份通用策略”是两个问题;也应当与论文中的 Fast-WAM、Joint、IDM 三个对照变体分开理解。Optional IDM 发布说明
实际复现还要留意 scheduler 配置。当前 README 将 action shift 默认改为 1.0,而评估原始发布权重时要求 EVALUATION.sigma_shift=5.0。论文 §4.1 描述 logit-normal 噪声调度,当前 scheduler_continuous.py 则从均匀分布采样后做 shift 变换。论文方法与当前实现的关系可以对照,但复现具体数字应使用与权重匹配的代码和设置。更新说明 scheduler 实现
这篇论文真正比较的是哪件事
Fast-WAM 的问题不是“视频预训练有没有用”,因为几个变体都从预训练视频模型起步。它进一步问:在相同框架下,机器人训练中的视频目标和推理时的显式未来生成,究竟哪个更重要?
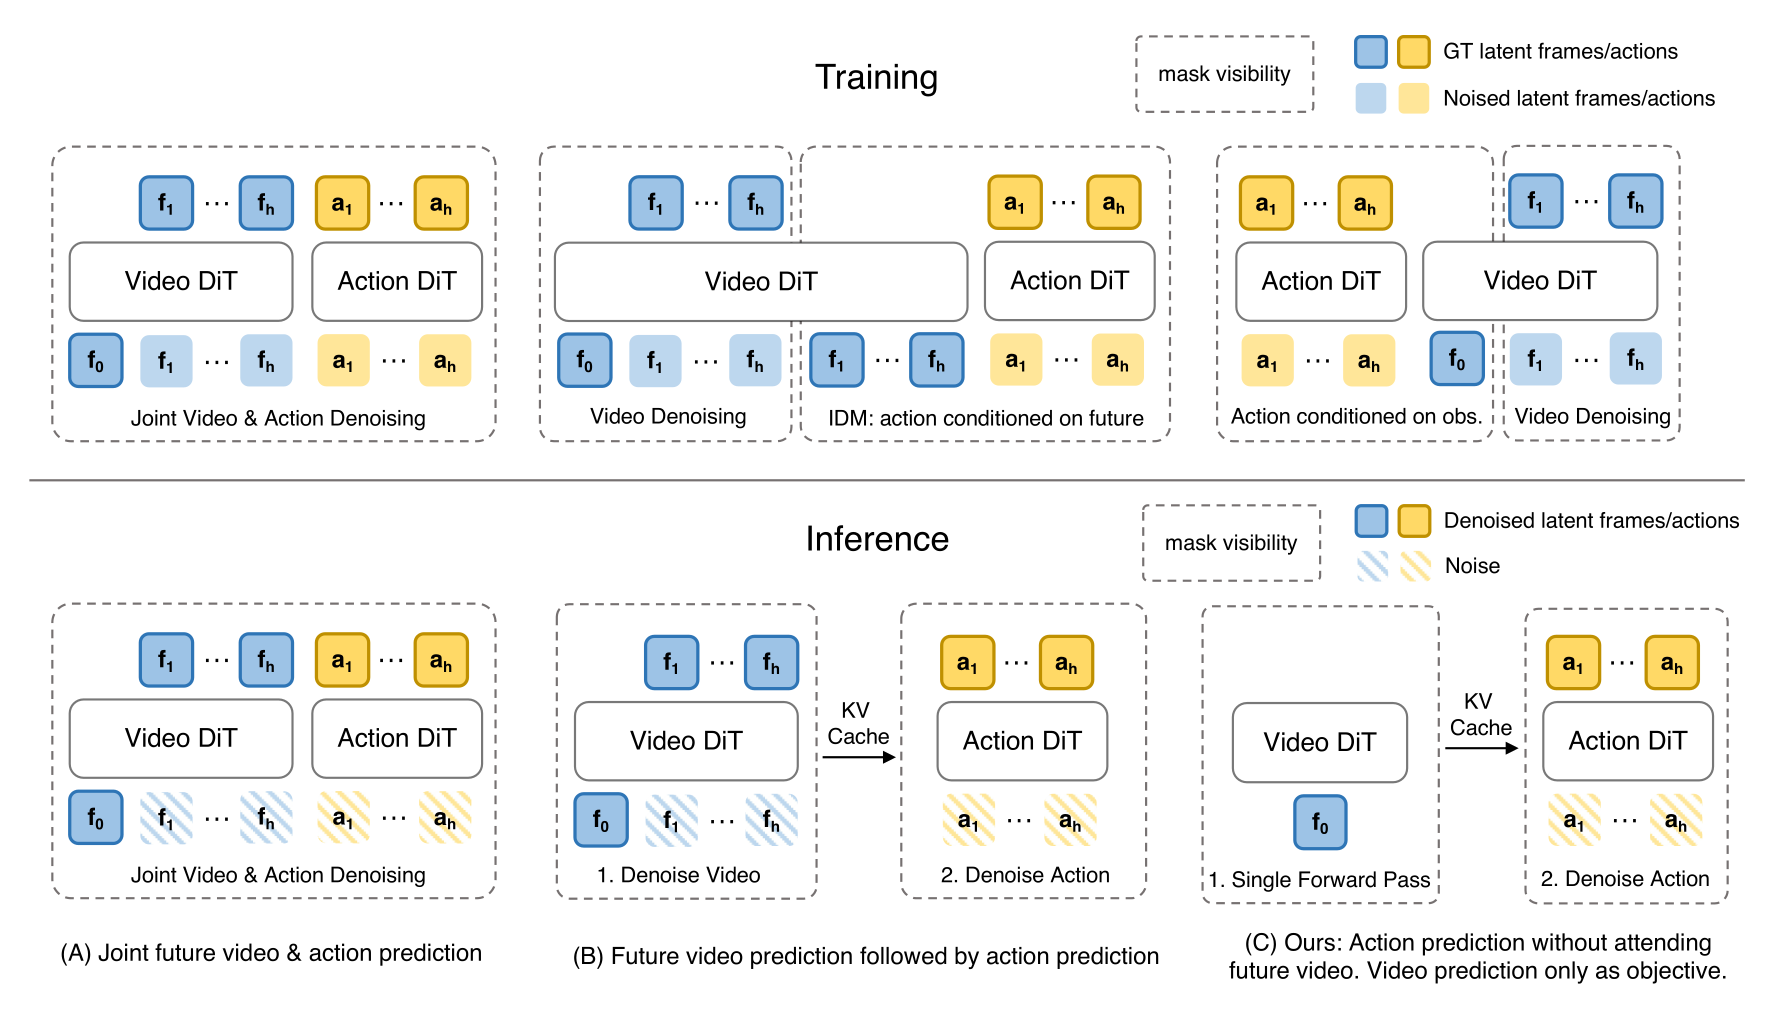
原图摘自 Tianyuan Yuan 等的 Fast-WAM 论文 Figure 1(CC BY 4.0,仅裁剪)。上排是训练,下排是各自的推理流程,不表示把上排结果接着运行到下排。虚线框标注 attention 可见范围;B、C 下排的箭头则表示将各层视频 K/V 缓存交给动作分支。A 在推理时联合去噪视频与动作;B 先把未来视频去噪,再用它生成动作;C 保留训练中的视频目标,推理只对当前帧做一次 Video DiT 前向,再进行 action 去噪。右下角的 “Single Forward Pass” 因此只对应视频分支,紧接着仍有 “Denoise Action”。
| 变体 | 下游视频联合训练 | 推理生成未来视频 | LIBERO 平均成功率 | RoboTwin 平均成功率 |
|---|---|---|---|---|
| Fast-WAM | 有 | 无 | 97.6% | 91.8% |
| Fast-WAM-Joint | 有 | 视频与 action 联合去噪 | 98.5% | 90.6% |
| Fast-WAM-IDM | 有 | 先视频,后 action | 98.0% | 91.3% |
| Fast-WAM w.o. video co-train | 无 | 无 | 93.5% | 83.8% |
数据来自论文 Tables 1–2。“无视频联合训练”的消融保留预训练起点和动作推理结构,去掉的是下游视频建模目标,并不是把 Wan 预训练也删掉。论文 §3.3、§4.3
LIBERO 上,Joint 比 Fast-WAM 高 0.9 个百分点,去掉视频训练则低 4.1 个百分点;RoboTwin 上,Fast-WAM 与两种 imagination 变体接近,去掉视频训练低 8.0 个百分点。真实毛巾折叠中,去掉视频联合训练后的成功率更降到 10%。这些结果支持保留视频训练目标,再评估是否值得在部署时付出未来视频生成的代价。
这也不是说 Fast-WAM 在所有维度都最好。论文的真实毛巾任务里,预训练的 $\pi_{0.5}$ 成功率和完成时间最好;Fast-WAM 家族中 IDM 的成功率最高,而 Fast-WAM 的完成时间更好。它提供的是一个速度与任务表现的取舍点,显式未来建模在别的任务中能否带来更大收益,还需要相应实验。论文 §4.3.3
我更关心这套设计暴露出来的接口:video DiT 在训练时保留未来预测能力,到了推理时却可以作为当前观测的分层上下文编码器;action DiT 从连续噪声生成控制序列,读取这份上下文而不必等待视频采样。Wan 预训练、机器人视频监督和 action 生成因此可以一起训练,同时保留一条较短的部署路径。这比只把它记成“Wan 后面接了一个 action encoder”更接近公开代码实际做的事情。
参考
- Tianyuan Yuan 等,Fast-WAM: Do World Action Models Need Test-time Future Imagination?,arXiv:2603.16666v2,2026-03-23。
- Fast-WAM 项目页、官方源码、发布权重,访问日期 2026-09-30。本文代码链接固定到
7faa711;模型文件列表核对 revision8eaceeb24c3cc92ff2a9c9a9d266a4941b836705。 - Wan2.2 官方说明,用于核对 TI2V-5B 与 VAE 压缩率;Fast-WAM 中的具体形状以它自己的配置和实现为准。