1 从一个问题开始:为什么同一份数据要读很多次?
计算矩阵乘法 $C=AB$ 时,C 中的每个元素都可以单独计算。于是,一个很自然的 GPU 实现是:给每个输出元素分配一个线程,让它读取需要的数据,完成乘加,再把结果写回。
问题在于,这些线程需要的数据经常是相同的。例如,计算 C 同一行的多个元素,都要用到 A 的同一行。如果每个线程都自己去读,就会重复读取相同的数据。
本文要解释的分块(Tiling),就是让一组线程分工搬数据,再共同使用。我们先看重复读取发生在哪里,再看如何用共享内存减少这些读取,最后讨论块为什么不能无限增大。
2 一个线程怎样计算一个输出元素
2.1 先看矩阵里的一个数
下面一直用 $6\times6$ 的矩阵作例子,行列下标都从 0 开始。计算 C[2,2],需要取 A 的第 2 行和 B 的第 2 列,对应相乘后相加:
这里 k 每增加 1,就从 A 的这一行向右取一个数,同时从 B 的这一列向下取一个数。一共做 6 次乘加,才得到 C[2,2]。
现在看旁边的 C[2,3]。它需要 A 的第 2 行和 B 的第 3 列。也就是说,负责 C[2,2] 和 C[2,3] 的两个线程,都会用到 A[2,0]、A[2,1],一直到 A[2,5]。换个方向看,负责 C[2,2] 和 C[3,2] 的两个线程,则都会用到 B 的第 2 列。
重复读取就出现在这里:不同的输出元素,常常需要相同的输入元素。
2.2 把这个过程写成 CUDA 代码
CUDA 中,在 GPU 上执行的函数叫作 kernel。线程会被分成若干组,每组叫作 thread block(线程块)。把矩阵边长记为 N,本例中 N=6。这份代码把线程块排成二维,每个线程负责 C 中的一个位置:
__global__ void MatMulKernel(const float *a, const float *b, float *c, int N) {
    // 线程块的位置 × 块的大小 + 线程在块内的位置
    int row = blockIdx.y * blockDim.y + threadIdx.y;
    int col = blockIdx.x * blockDim.x + threadIdx.x;
    if (row >= N || col >= N) return;

    float Pvalue = 0.0f;
    for (int k = 0; k < N; k++) {
        Pvalue += a[row * N + k] * b[k * N + col];
    }
    c[row * N + col] = Pvalue;
}
row、col 确定这个线程负责哪个输出元素,Pvalue 保存它的累加结果。A、B 虽然在数学上是二维矩阵,在这段代码中却按行连续存储:一行有 N 个数,所以 a[row * N + k] 就是 A[row,k],b[k * N + col] 就是 B[k,col]。
对于前面的 C[2,2],这个线程需要读取 A 中的 6 个数和 B 中的 6 个数,共 12 次输入读取。如果同时计算中间的 4 个输出元素 C[2,2]、C[2,3]、C[3,2]、C[3,3],四个线程就会各自读取 12 次,合计 48 次。后面我们会让这四个线程合作,把输入读取次数降到 24 次。
这里先按代码中各线程读取的元素个数计数。实际访问显存时,硬件缓存和访存合并还会减少或改变数据传输量;这一计数方式用来比较两种写法的数据复用。
3 线程多,为什么还要减少读取?
GPU 可以同时安排很多线程工作,但这些线程仍然要从内存中取得数据。线程数量增加了,并不代表内存在单位时间里能送来的数据也无限增加。
这里有两个容易混淆的概念。延迟是发出一次读取后,要等多久才能拿到结果;带宽是单位时间最多能传输多少数据。GPU 可以在一组线程等待数据时执行其他线程的工作,从而利用这段等待时间,但所有线程仍然要共享有限的内存带宽。
具体来说,GPU 由多个 SM(Streaming Multiprocessor)组成,线程块会被安排到 SM 上执行。SM 以 32 个线程组成的 warp 为一组调度指令:某个 warp 的数据还没到,就有机会执行其他就绪 warp 的指令。两次独立读取也可能重叠进行,因此不能把单次读取的等待时间简单相加,当成整个 kernel 的运行时间。CUDA 最佳实践指南 介绍了这些访存与调度机制。
回到矩阵乘法,如果相邻线程本来就需要相同的数据,那么让它们共用一份已经搬进来的数据,可以直接减少对全局内存的读取请求。下一步的问题是:这份供大家共用的数据,应该放在哪里?
4 数据放在哪里:先记住三种内存
4.1 完整矩阵、当前小块、累加结果
对于本文的矩阵乘法,最需要区分的是下面三种存储:
| 存储位置 | 本文放什么 | 谁来使用 |
|---|---|---|
| 全局内存(Global Memory) | 完整的 A、B、C 矩阵 | 各个线程都可以访问 |
| 共享内存(Shared Memory) | 当前这一轮要用的 A、B 小块 | 同一个线程块里的线程共同使用 |
| 寄存器(Registers) | 一个线程自己的累加值,如 Pvalue |
该线程自己使用 |
全局内存容量大,适合放完整矩阵。共享内存位于 SM 内部,容量小,但适合让线程块反复使用已经搬入的数据。寄存器也位于 SM 内部,用来保存线程计算时需要的局部值。
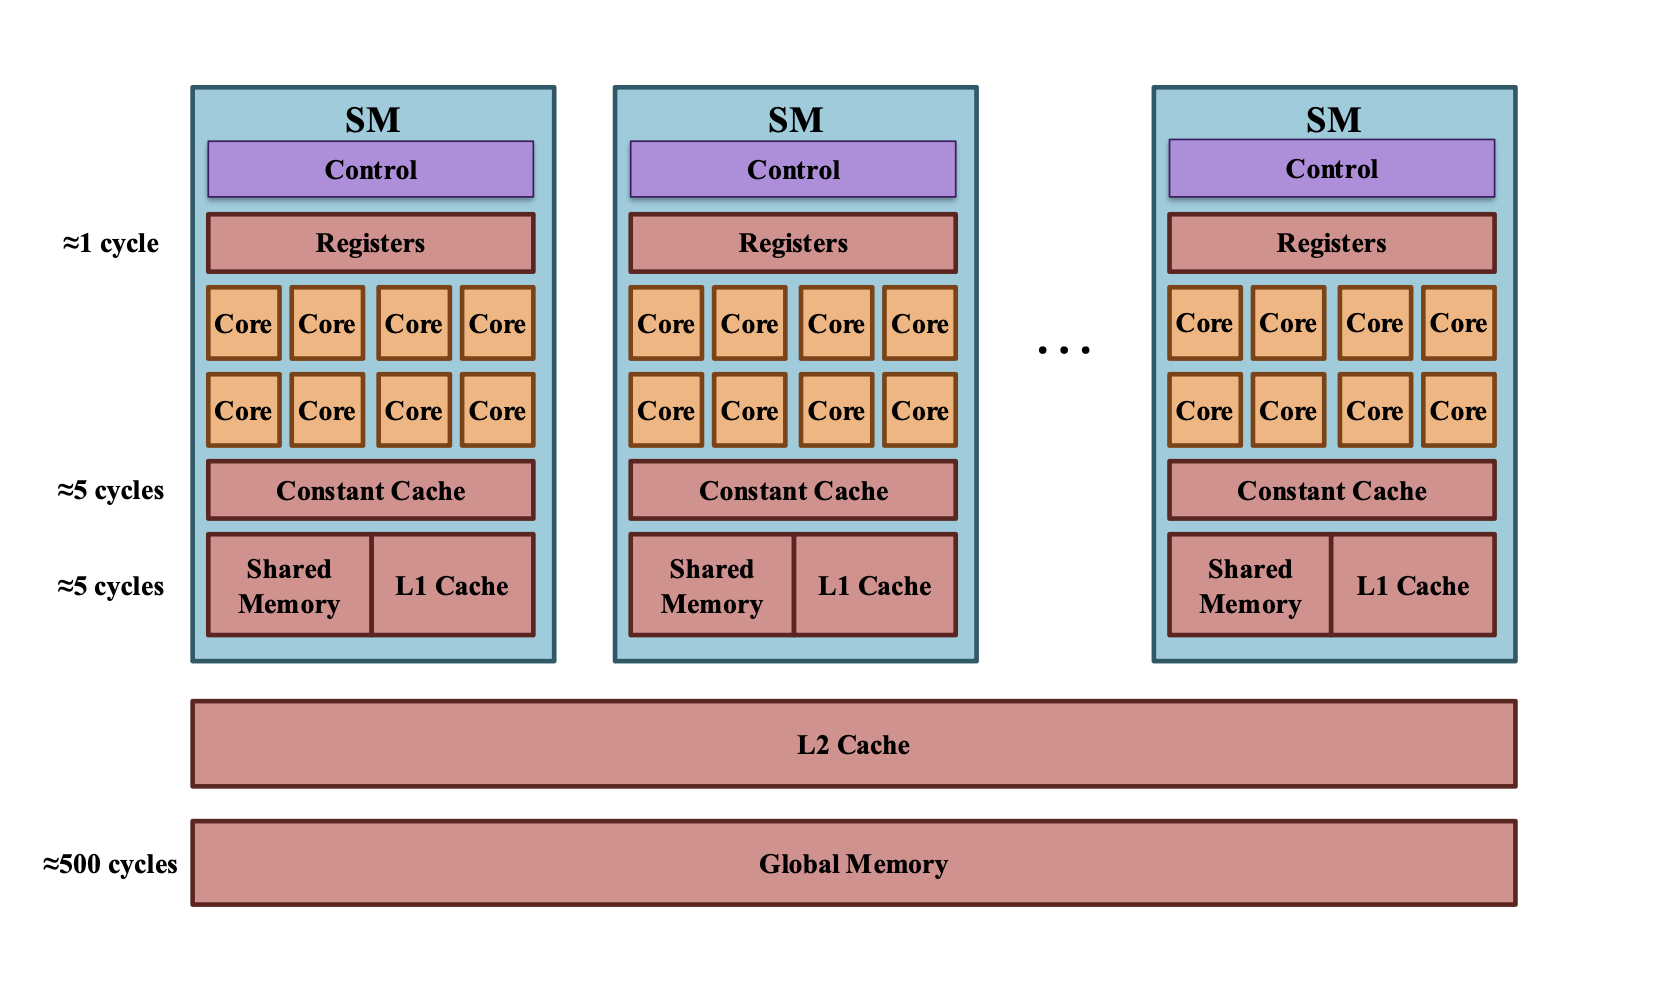
图中可以看到,每个 SM 都有自己的寄存器和共享内存,而多个 SM 访问全局内存时还可能经过缓存。图里的 cycle 是时钟周期;其中的具体数字没有对应 GPU 型号和测量条件,这里只用它说明存储结构,不据此估算耗时。
4.2 对应到代码,数据怎样走
用 TILE_WIDTH 表示小块每边有多少个元素,可以这样声明当前输入小块和线程的累加值:
__shared__ float As[TILE_WIDTH][TILE_WIDTH];
__shared__ float Bs[TILE_WIDTH][TILE_WIDTH];
float Cvalue = 0.0f;
__shared__ 表示 As、Bs 由整个线程块共同使用。比如,一个线程把某个 A 元素放入 As,同一块里的其他线程就可以在同步后读取它。Cvalue 则是每个线程自己的变量,通常保存在寄存器中;其他线程各有自己的 Cvalue。
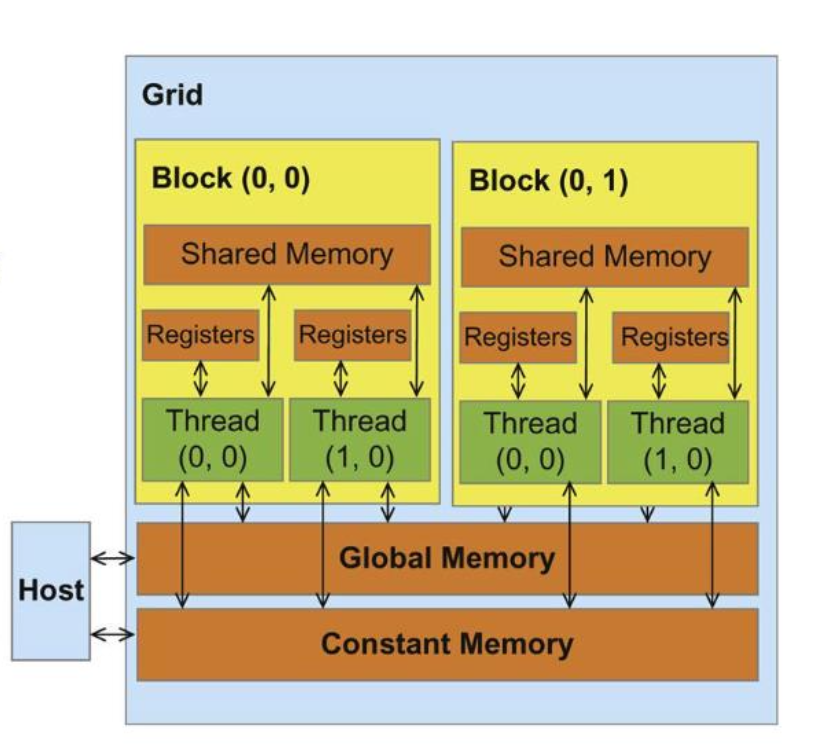
后面代码的数据流是:从 global memory 取 A、B 的一小块,放入 shared memory;线程读取这些小块,在自己的 Cvalue 上累加;所有轮次结束后,再把结果写回 global memory 中的 C。输入小块每轮都会更换,累加结果一直保留。
4.3 另外两种内存
CUDA 里还有 Local Memory 和 Constant Memory。Local 的“局部”表示线程私有,它实际使用设备内存,并不因为名字叫 local 就位于片上。当寄存器不够用,或局部数组不适合放进寄存器时,编译器可能使用 local memory。普通变量和数组最终放在哪里,需要看编译器的分配结果。
Constant memory 在 kernel 中只读,可以由 CPU 一侧的程序(Host)更新;它有专用缓存,适合同一 warp 的线程读取相同地址。本文的分块矩阵乘法主要使用前面三种存储,先沿着那条数据流理解即可。更多规则见 CUDA 设备内存访问说明。
5 Tiled GEMM:四个线程怎样共用数据
GEMM 是通用矩阵乘法的常用名称,本文计算的是其中 $C=AB$ 的情形。下面的实现参考 matmul_tile_full.cu。
5.1 先把 6 次乘加拆成 3 轮
继续看 $6\times6$ 的矩阵,把它按 $2\times2$ 划成小块,每个小块叫一个 tile。这里要分清两个词:tile 是数据块,block 是线程组。让一个含有 4 个线程的 block 负责 C 中间的 $2\times2$ 小块,每个线程仍然计算一个输出元素。
先只跟踪其中的 C[2,2]。它需要 6 次乘加,现在每轮做 2 次:
| 轮次(phase) | 这一轮处理的 k |
加到 Cvalue 上的内容 |
|---|---|---|
| 第 0 轮 | 0、1 | A[2,0] * B[0,2] + A[2,1] * B[1,2] |
| 第 1 轮 | 2、3 | A[2,2] * B[2,2] + A[2,3] * B[3,2] |
| 第 2 轮 | 4、5 | A[2,4] * B[4,2] + A[2,5] * B[5,2] |
例如,A 的这一行是 [1,2,3,4,5,6],B 的这一列都是 1,那么三轮分别贡献 3、7、11。Cvalue 从 0 变成 3,再变成 10,最后变成 21。它只在开始时清零,不能每轮重新清零。
另外三个线程也以同样方式计算各自的输出。合在一起看,四个线程每轮都需要 A 的一个 $2\times2$ 小块和 B 的一个 $2\times2$ 小块:第一轮取 A 中间块行的左块、B 中间块列的上块;第二轮都取中间块;第三轮取 A 的右块、B 的下块。
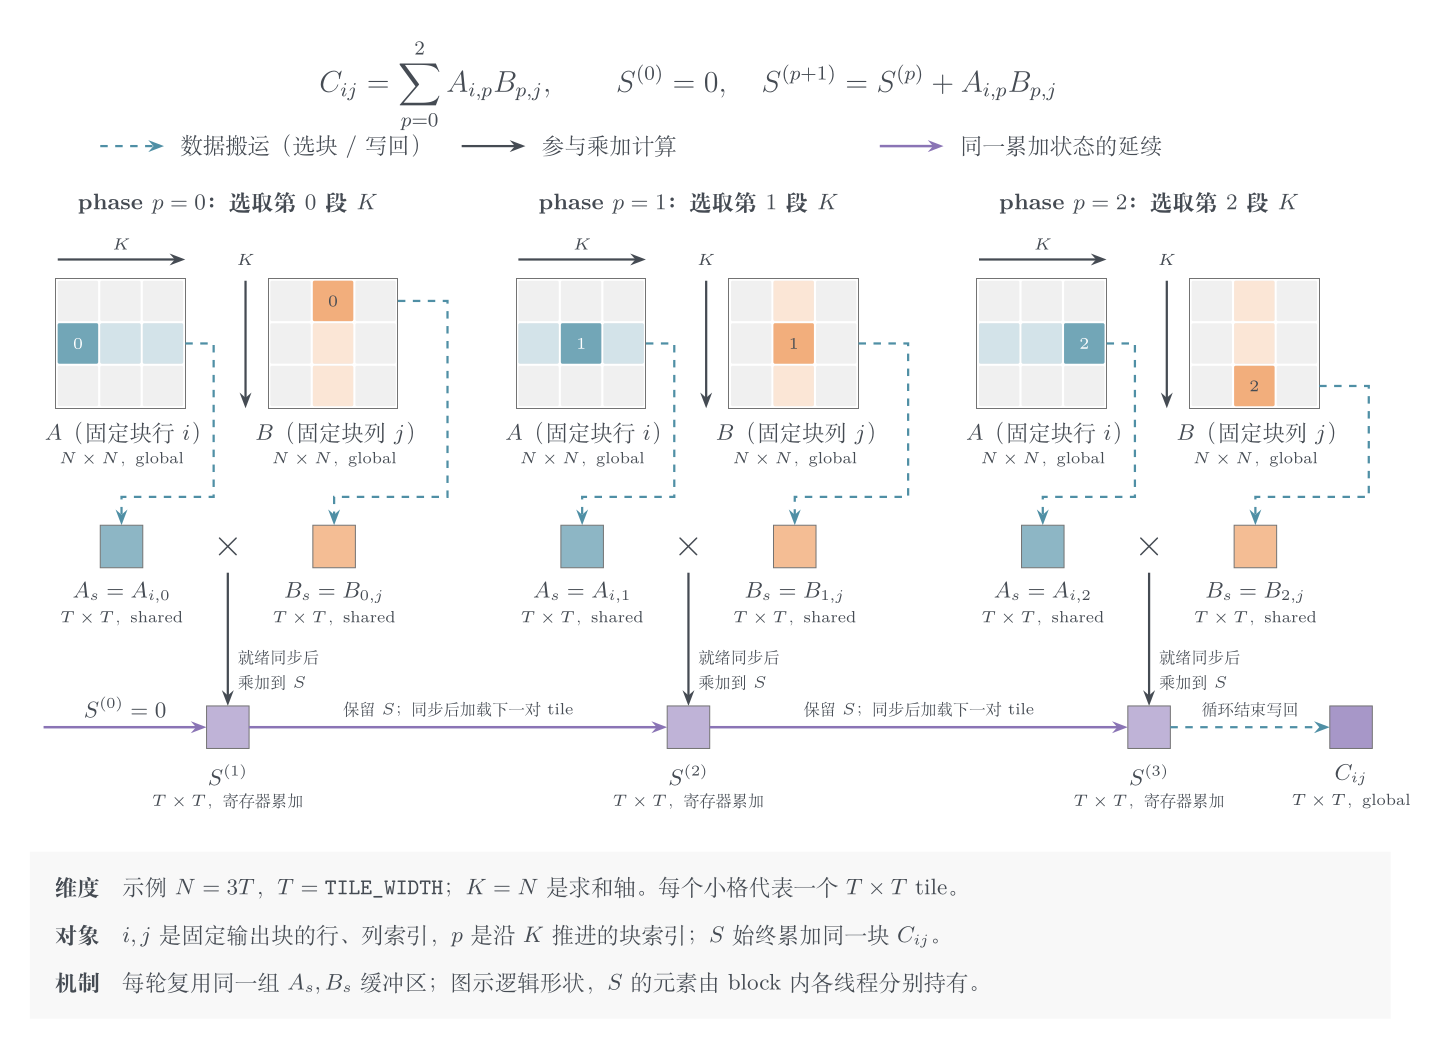
读这张图时,先从左到右看三个 phase:A 的深色块向右移动,B 的深色块向下移动。它们共同推进的求和方向称为 K 轴,在这个例子中长度是 6。
再看每个 phase 内的箭头:蓝色虚线表示把选中的 A、B 小块搬到 shared memory,以及最后把 C 写回 global memory;深灰色实线表示用这些数据做乘加。底部的紫色横线表示同一组累加值继续传给下一轮,输出位置始终不变。
图中的 $T$ 是块的边长,本例为 2;$i,j$ 是输出块的行列编号,本例固定为 $i=j=1$,所以 $C_{ij}$ 表示中间的整块输出。$p$ 是轮次编号,$S$ 表示这四个线程各自累加值组成的逻辑小块,$S^{(1)}$ 就是完成第一轮后的状态。图里的 $S$ 并不是另行分配的一块 shared memory。
5.2 搬数据时合作,计算时各算各的
第一轮需要从 A 搬 4 个数,从 B 搬 4 个数,总共 8 个数。四个线程分工,每个线程从 A、B 各搬一个数,就能把两个小块填满。
例如,负责 C[2,2] 的线程搬入 A[2,0] 和 B[0,2]。它计算时还需要 A[2,1] 和 B[1,2],这两个数由同一个 block 中的其他线程搬入。数据放进 As、Bs 后,它就可以直接读取,不必再从 global memory 取一次。
这里需要第一次同步:等大家都把数据搬齐,再开始计算。 否则,先到的线程可能读到还没填好的位置。
算完这一轮,还需要第二次同步:等大家都用完当前数据,再覆盖共享缓冲区。 否则,快的线程可能开始搬下一轮的数据,慢的线程却还在使用上一轮的数据。
三个 phase 都使用同一组 As、Bs,只替换其中的内容。线程自己的 Cvalue 则一直累加,直到循环结束才写回 C。
5.3 再看完整代码
现在换用 $1024\times1024$ 的矩阵,把块边长从 2 换成 16,合作方式保持不变:一个 block 有 $16\times16=256$ 个线程,每轮共同搬入两个 $16\times16$ 的 tile。下面假设正整数 N 能被 TILE_WIDTH 整除,以便先专注于主体流程。
#define TILE_WIDTH 16

__global__ void matMulTiled(const float *d_A, const float *d_B,
                           float *d_C, int N) {
    __shared__ float As[TILE_WIDTH][TILE_WIDTH];
    __shared__ float Bs[TILE_WIDTH][TILE_WIDTH];

    int ty = threadIdx.y;  // 当前线程在块内的行
    int tx = threadIdx.x;  // 当前线程在块内的列
    int row = blockIdx.y * TILE_WIDTH + ty;
    int col = blockIdx.x * TILE_WIDTH + tx;
    float Cvalue = 0.0f;  // 整个计算过程只初始化一次

    for (int ph = 0; ph < N / TILE_WIDTH; ++ph) {
        int k0 = ph * TILE_WIDTH;  // 本轮从 K 轴的哪个位置开始

        // 每个线程各搬一个 A 元素和一个 B 元素
        As[ty][tx] = d_A[row * N + k0 + tx];
        Bs[ty][tx] = d_B[(k0 + ty) * N + col];
        __syncthreads();  // 大家搬齐了,才能一起使用

        for (int k = 0; k < TILE_WIDTH; ++k) {
            Cvalue += As[ty][k] * Bs[k][tx];
        }
        __syncthreads();  // 大家用完了,才能覆盖下一轮的数据
    }

    d_C[row * N + col] = Cvalue;
}
k0 是当前小块在完整矩阵中的起点。回到 $N=6,T=2$ 的例子,它依次为 0、2、4。加载 A 时,row 不变,只向右移动;加载 B 时,col 不变,只向下移动,这正好对应图里的选块方向。
As[ty][k] * Bs[k][tx] 则在已经搬入的小块中完成“一行乘一列”。这里的 k 只走当前 tile 内的 TILE_WIDTH 个位置;外层 ph 循环负责换到下一对 tile。
启动时,使用 dim3 block(TILE_WIDTH, TILE_WIDTH) 和 dim3 grid(N / TILE_WIDTH, N / TILE_WIDTH),让每个 block 对应一个输出 tile。若要支持不能整除的 N,需要对越界输入补零、对输出做边界判断,并让块内线程一致地参与同步,不能直接套用简单版本的越界提前返回。
5.4 到底省了多少读取?
先用四个线程的小例子数一次。计算中间的四个输出元素,简单版本每个线程从 global memory 读取 12 个数,合计 $4\times12=48$ 次。分块版本每轮共同读取 8 个数,三轮合计 $3\times8=24$ 次。计算的结果没有变化,global 输入读取次数减半了。
为什么恰好减半?因为块边长为 2,每个搬入的 A 元素会被同一块行上的 2 个线程使用,每个 B 元素也会被同一块列上的 2 个线程使用。块边长变成 $T$ 后,每个输入元素就能在这一轮中被 $T$ 个线程使用。
因此,对整个 kernel 按源码计数,再平均到每个输出元素,输入的 global 读取次数从 $2N$ 降到 $2N/T$。例如 $N=1024,T=16$,就从 2048 次降到 128 次,也就是原来的 $1/16$。这些数统计的是线程读取的元素个数;实际加速还要考虑缓存、同步和资源占用,不能直接写成“运行快了 16 倍”。
代价是增加了 shared memory 的读写:平均每个输出元素对应 $2N/T$ 次 shared 写入和 $2N$ 次 shared 读取。Tiling 把反复从 global memory 取数据,变成了在片上复用已经加载的内容。两个版本最后都只对每个输出元素写回一次。
还可以用计算强度(Arithmetic Intensity)表达这种变化:每读取 1 字节输入,能完成多少浮点运算?一次乘法加一次加法计作 2 FLOP,一个 FP32 数占 4 字节。这里仅统计输入的 global 读取量,暂时忽略输出写回。
简单版本每次乘加读取两个数,也就是 8 字节,计算强度为:
\[I_{\text{naive}}=\frac{2}{2\times4}=0.25\ \text{FLOP/Byte}\]分块版本以 $T=16$ 为例,一轮加载两个 $16\times16$ 小块,共 512 个数、2048 字节。256 个线程各做 16 次乘加,共完成 $256\times16\times2=8192$ FLOP,所以:
\[I_{\text{tiled}}=\frac{8192}{2048}=4\ \text{FLOP/Byte}\]同样的输入读取量,现在可以支撑更多计算。推广到任意块边长 $T$,这个比值就是 $2T^3/(8T^2)=T/4$。这也是为什么增大 tile 会提高理论上的数据复用率。
6 块越大越省读取,为什么不一直增大?
6.1 先看一个 block 需要多少线程
本文始终采用“一个线程计算一个输出元素”的方式,因此 $T\times T$ 的 tile 需要 $T^2$ 个线程。同时,A、B 各需要一个 shared memory 小块,每块存 $T^2$ 个 4 字节的数:
TILE_WIDTH |
每个 block 的线程数 | As + Bs 用量 |
对本文代码的含义 |
|---|---|---|---|
| 16 | 256 | 2 KiB | 满足线程数上限,可作为起点 |
| 32 | 1024 | 8 KiB | 达到每 block 1024 线程上限,还要看其他资源 |
| 64 | 4096 | 32 KiB | 超过线程数上限,不能直接这样启动 |
这里 $1\ \text{KiB}=1024$ 字节。可以看到,TILE_WIDTH=64 虽然只需要 32 KiB shared memory,但 4096 个线程已经超过一个 block 的上限了。CUDA 线程层次说明 给出了这一限制。
要让一个 block 计算更大的输出 tile,就需要改变分工,例如让一个线程计算多个输出元素。这样线程数可以降下来,但每个线程又要同时保存更多累加值。
6.2 一个块占用越多,SM 能同时放下的块越少
共享内存既有每个 block 的申请上限,也有每个 SM 的总容量。一个 block 用得更多,同一个 SM 留给其他 block 的空间就更少。
例如,假设某个 SM 有 64 KiB 可用共享内存,只看这一项资源:每个 block 用 8 KiB,最多能容纳 8 个;每个 block 用 32 KiB,就只能容纳 2 个。这只是共享内存这一项给出的上限,线程数等限制还可能进一步减少同时运行的 block 数。
具体容量随 GPU 而变,不能把某个型号的数字套用到所有设备。可以用 cudaGetDeviceProperties 查询设备属性,其中 sharedMemPerBlock 是每 block 的默认共享内存限额,sharedMemPerMultiprocessor 是每 SM 的容量。架构差异与更大共享内存申请的条件可参考 CUDA 官方资源规格。
6.3 每个线程的累加值也要占空间
前面的代码每个线程只计算一个输出,因此只需要一个 Cvalue;如果一个线程改为计算多个输出,就需要多份累加值。这些值通常会占用更多寄存器,而一个 SM 的寄存器总量也是有限的。
再举一个简化算例:假设某个 SM 有 16384 个 32 位寄存器,希望同时放下 4 个 block,每个 block 有 256 个线程。先忽略硬件分配粒度,平均到每个线程就是:
\[\frac{16384}{4\times256}=16\ \text{个寄存器/线程}\]如果每个线程实际需要 32 个寄存器,那么一个 block 就需要 $256\times32=8192$ 个;只看寄存器预算,这个 SM 便只能同时放下 2 个这样的 block。若连一个 block 所需的资源都放不下,kernel 就可能无法启动。编译器还可能把部分局部值放到 local memory,带来额外访存。
这里“同时放下”在 CUDA 里称为驻留。常见的 occupancy(占用率),就是 SM 当前驻留的 warp 数相对于硬件最大允许值的比例。驻留的工作较多,通常能给调度器更多选择,用其他工作填补等待时间;但如果增加数据复用已经明显减少了访存,即使 occupancy 降低,程序也可能更快。相关机制见 CUDA 硬件多线程说明。
所以,对这份入门 kernel,可以从 TILE_WIDTH=16 和 32 开始比较:一方面看更大的块省了多少读取,另一方面看它占用了多少线程、共享内存和寄存器,再用目标 GPU 上的运行时间判断哪种划算。
本文为上篇,聚焦 CUDA 内存模型与 Tiled 矩阵乘法。内存访问局部性、稀疏矩阵乘法与 cuBLAS 见下篇:GPU 内存访问优化与稀疏矩阵。