1 标准前馈层回顾
Transformer 前馈层(Feed-Forward Layer, FFN)是注意力块外的主要非线性单元,通常由两层线性映射加一次激活构成
1.1 基础公式
\[FF(x) = \text{ReLU}(x W_1) W_2 = \max(0, xW_1) W_2\]1.1.1 关键组件
- $x$:来自自注意力或上一层输出的输入向量。
- $W_1$:升维线性变换,产生中间隐空间。
- $\max(0, \cdot)$:共享阈值的 ReLU 激活。
- $W_2$:把激活后的特征投影回原始维度。
ReLU 固定使用零阈值,所有神经元以同一规则开关,难以针对不同 token 动态调节信息流。
2 门控机制的引入
为提升自适应能力,Gated Linear Units(GLU) 及其变体在激活阶段增设门分支,让 FFN 学会对不同特征分配不同“通行证”。
2.1 数学化表达
门控的核心替换是:
\[\max(0, xW_1) \rightarrow \max(0, xW_1) \otimes (xV)\]2.1.1 表达含义
- $\otimes$:逐元素乘,确保每个维度都能独立调节。
- $xV$:额外线性层生成的门控信号,可视作“输入相关的滤波器”。
- 结果:输出不再只由主分支决定,而是由门分支控制通过比例。
3 ReGLU 流程
ReGLU 选择保持主分支的 ReLU 激活,同时使用线性门分支,得到:
\[FF_{\text{ReGLU}}(x) = \left(\max(0, xW_1) \otimes (xV)\right) W_2\]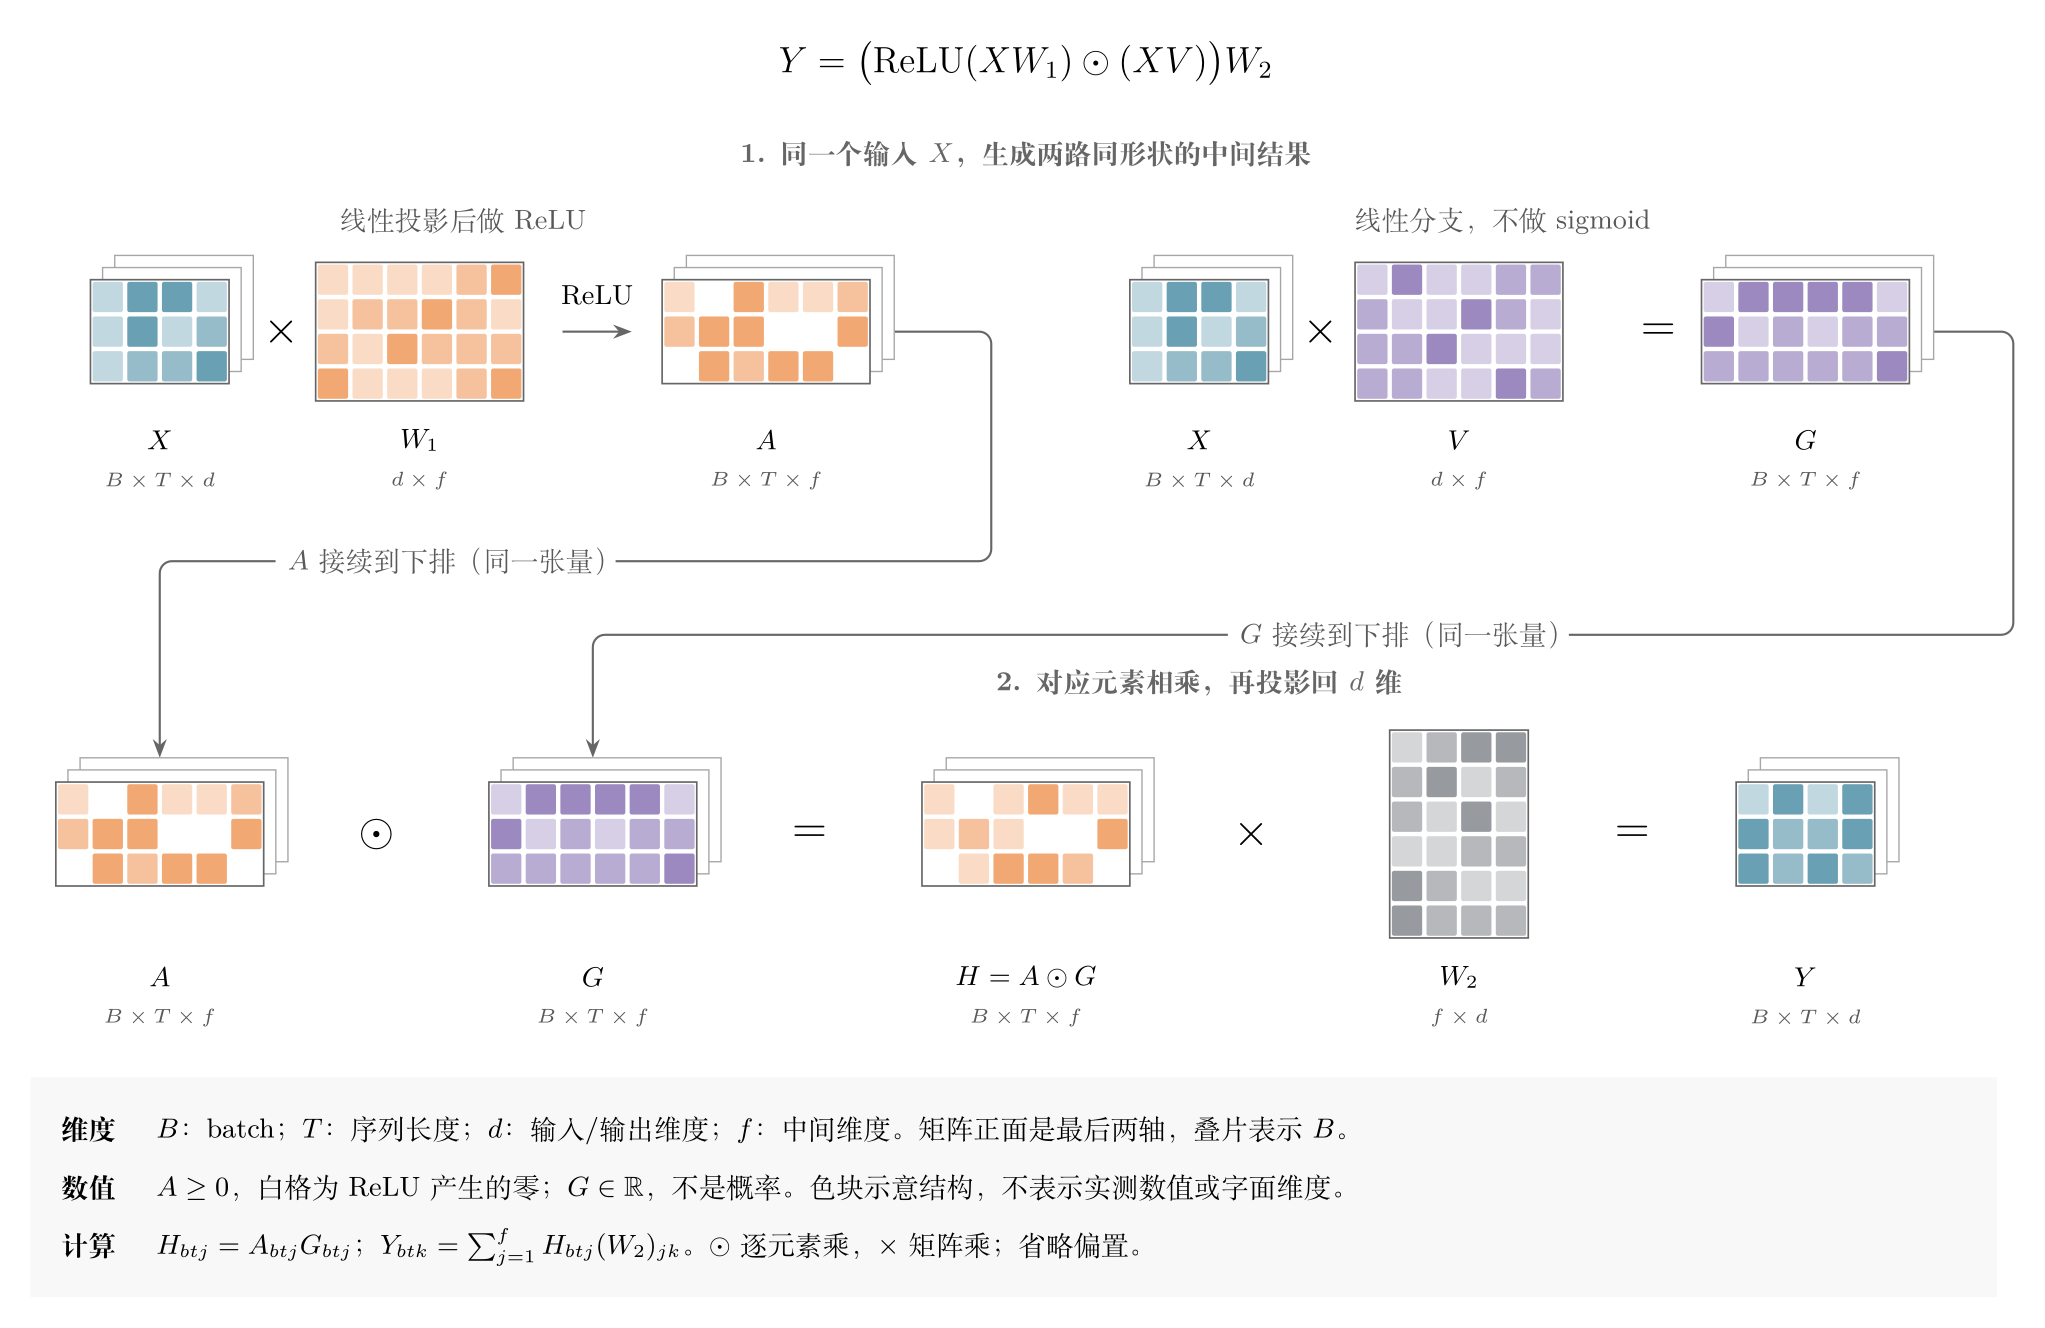
图中把单个 token 的 $x$ 扩展为整批输入 $X\in\mathbb{R}^{B\times T\times d}$,其中 $B$ 是 batch size,$T$ 是序列长度,$d$ 是输入维度,$f$ 是 FFN 中间维度。上排两处 $X$ 表示同一个输入:它分别乘以 $W_1,V\in\mathbb{R}^{d\times f}$,得到 $A=\operatorname{ReLU}(XW_1)$ 和 $G=XV$。下排沿箭头接续这两个结果,按相同的 batch、token 和通道位置相乘,再通过 $W_2\in\mathbb{R}^{f\times d}$ 投影回原维度。
图中的 $\odot$ 对应上式的 $\otimes$,都表示逐元素乘:$H_{btj}=A_{btj}G_{btj}$,没有在这一步对通道求和。$A$ 中被 ReLU 置零的位置,在 $H$ 中仍然为零;线性分支 $G$ 可以为负,也可以大于 1,所以这里的“门”不是概率或 0/1 开关。图示沿用原论文的无偏置 ReGLU 定义,色块只表示逻辑张量结构,不代表实际线程或存储布局。
| 模型 | 第一层输出 | 是否门控 | 额外参数 |
|---|---|---|---|
| 标准 FFN | $\max(0, xW_1)$ | 否 | 无 |
| ReGLU | $\max(0, xW_1) \otimes (xV)$ | 是 | $V$ |
3.1 设计直觉
- 门信号依赖输入 $x$,不同 token 激活不同通道。
- 门控发生在 FFN 内部,不改变外层残差连接的结构。
- 在相同中间维度下,额外的 $V$ 与 $W_1$ 一样大;若要保持参数预算,通常需要相应缩小中间维度。
4 GLU 家族与实践
不同激活函数对应不同 GLU 变体,常见组合如下:
| 变体 | 激活函数 | 定义 |
|---|---|---|
| GLU | sigmoid | $(xW_1) \otimes \sigma(xV)$ |
| GeGLU | GELU | $\text{GELU}(xW_1) \otimes (xV)$ |
| ReGLU | ReLU | $\max(0, xW_1) \otimes (xV)$ |
| SwiGLU | Swish | $\text{Swish}(xW_1) \otimes (xV)$ |
这里要区分 FFN 的结构与所用激活函数:ReGLU、SwiGLU、GeGLU 都是门控 FFN。原始 T5 使用普通 ReLU FFN,T5 v1.1 则改为 GeGLU,不能笼统地说“T5 使用 ReGLU”。参见 T5 配置说明与 T5 v1.1 文档。
4.1 典型应用提示
- 变体选择要在训练稳定性、硬件友好度、推理延迟之间权衡。
- 在相同输入和中间维度下,采用固定 SiLU 的 SwiGLU 与 ReGLU 都有三组投影权重,参数量相同;区别在激活计算,而不是少了一组参数。
附录:近期模型把门控 FFN 用到了哪里
更新于 2026-09-22,以下比较开放权重模型的语言主干。
看完 ReGLU,再去读近期模型代码,会发现 gate_proj、up_proj、down_proj 这三组权重仍然很常见。以 GLM-5.3 为例,它的配置写的是 hidden_act="silu",结合实现中的 act(gate) * up,对应的就是 SwiGLU:把前文图里的 ReLU 换成 $\operatorname{SiLU}(z)=z\sigma(z)$,两路投影、逐元素乘和输出投影的形状关系都保留下来。不过,SiLU 不会像 ReLU 一样把所有负输入直接置零,图中的白格不能原样套用到 SwiGLU 上。配置与实现需要一起看,单独一个 silu 字段还不足以判断是否存在门控分支。
| 模型 | FFN / 专家内部形式 | 相对前文的变化 |
|---|---|---|
| GLM-5.3 | SwiGLU,前部 Dense、后部 MoE | 激活从 ReLU 换成 SiLU,保留双分支乘积 |
| GLM-5.3-Flash | 带限幅的 SwiGLU,前部 Dense、后部 MoE | 配置限幅阈值 10,对两路投影结果分别限幅 |
| DeepSeek-V4.1-Flash | 带限幅的 SwiGLU 专家,MoE | 同样设置限幅阈值 10,路由专家与共享专家沿用门控 FFN |
| Kimi-K3 | SiTU 门控变体,Dense + MoE | 保留两路投影,引入 tanh 平滑限幅 |
这里的 MoE 与 SwiGLU 并不冲突。MoE 路由决定一个 token 交给哪些专家,各个专家内部仍然可以执行 SwiGLU。前文画的是单个 FFN 内的计算,到了 MoE,只是要在这段计算外面再接上 token 分发、专家选择与输出加权。
更值得注意的变化是限幅。GLM-5.3-Flash 的实现与 DeepSeek-V4.1-Flash 的官方推理代码都在 SiLU 之前加入了 clamp。沿用前文的行向量约定,令 $g=XW_1$、$u=XV$,其核心计算为:
\[\begin{aligned} \tilde g &= \min(g,10),\\ \tilde u &= \operatorname{clip}(u,-10,10),\\ Y &= \bigl(\operatorname{SiLU}(\tilde g)\odot\tilde u\bigr)W_2. \end{aligned}\]gate 分支只截上界,up 分支同时截上下界;限幅发生在两路相乘之前。DeepSeek 的代码注释说明,这些限幅来自训练,用于控制 FP8/FP4 激活范围。由此看,这一代改动已经把低精度计算的数值范围纳入了 FFN 设计,而不只是替换一个非线性函数。
Kimi-K3 的官方 SituAndMul 实现采用另一种做法。按其配置中的 $\beta=4$、$\beta_{\mathrm{linear}}=25$,门控乘积变成:
\[H=\bigl[4\tanh(g/4)\odot\sigma(g)\bigr] \odot\bigl[25\tanh(u/25)\bigr],\qquad Y=HW_2.\]这里用 tanh 平滑地限制两条分支的幅度,三组投影权重仍然保留。回头看 ReGLU,它适合作为理解门控 FFN 的起点:先看清两路特征怎样在同一位置相乘,再看 SiLU 如何改变非线性,以及 clamp、tanh 如何约束数值范围。沿着这条计算路径读代码,近期模型的这些变化就能接到同一张图上。