前置阅读:张量并行与通信 分布式训练并行基础
模型已经开启张量并行,为什么把上下文拉长以后,显存还是不够?
TP 把权重和部分中间计算分到了多张卡上,但没有消除所有激活副本。以常规 Megatron TP 为例,LayerNorm、Dropout 等区域仍然可能在每张卡上保存同一份完整序列激活。上下文越长,这些副本越贵。即使用了 FlashAttention,避免把完整的 $L\times L$ 注意力分数矩阵写入显存,QKV、MLP 中间结果等随序列长度增长的激活仍然存在。[1][6]
沿序列维切分看起来很自然:一张卡放不下,就让每张卡只负责一段 token。不过,LayerNorm 可以逐 token 独立计算,Attention 却需要访问其他 token 的 K、V。两类算子对通信的要求不同,也就有了不同的序列切分方案。
这篇文章先从 Megatron 的定义出发,说明 SP 如何减少 TP 中的重复激活,CP 如何把长上下文分到多组设备,再展开 CP 所需要的分布式 Attention,介绍 Ulysses 和 Ring 两条计算路线。文献中的命名并不统一,Ulysses 也称自己为 Sequence Parallelism;因此下文用“Megatron SP”指框架中的特定方案,用 Ulysses、Ring 指具体的 Attention 算法,避免把不同层级的概念混在一起。
Megatron SP 与 CP:分别解决什么问题
SP:减少 TP 中的重复激活
先看一个普通的两层 MLP。省略 batch 和 bias,输入为 $X\in\mathbb R^{L\times d}$,中间维度为 $f$,逐元素激活函数记为 $\phi$:
\[Y=\phi(XW_1)W_2.\]两卡 TP 可以把 $W_1$ 沿输出通道切成两份,把 $W_2$ 沿输入通道切成对应的两份。第 $r$ 张卡先算自己的中间通道,再算这些通道对最终输出的贡献:
\[H^{(r)}=\phi(XW_1^{(r)}),\qquad P^{(r)}=H^{(r)}W_2^{(r)},\qquad Y=P^{(0)}+P^{(1)}.\]这里最容易看错的是 $P^{(r)}$。它的形状已经是 $L\times d$,但数值还不完整:它只是本卡那一半中间通道产生的部分和。两卡求和之后,才得到正确的 $Y$。
只有 TP 时,通常用 AllReduce 完成这次求和,两张卡都得到完整的 $Y$。接下来的 Dropout、残差连接和 LayerNorm,也就在两张卡上各处理一遍完整序列。
但 LayerNorm 只需要一个 token 的完整隐藏维 $d$,不需要其他 token。既然如此,求和之后为什么还要让每张卡保留全部 token?
Megatron SP 就从这里入手:把 AllReduce 换成 ReduceScatter,每张卡只留下求和结果的一段序列。等到下一个 TP 矩阵乘法需要完整输入时,再用 AllGather 收集回来。[1]
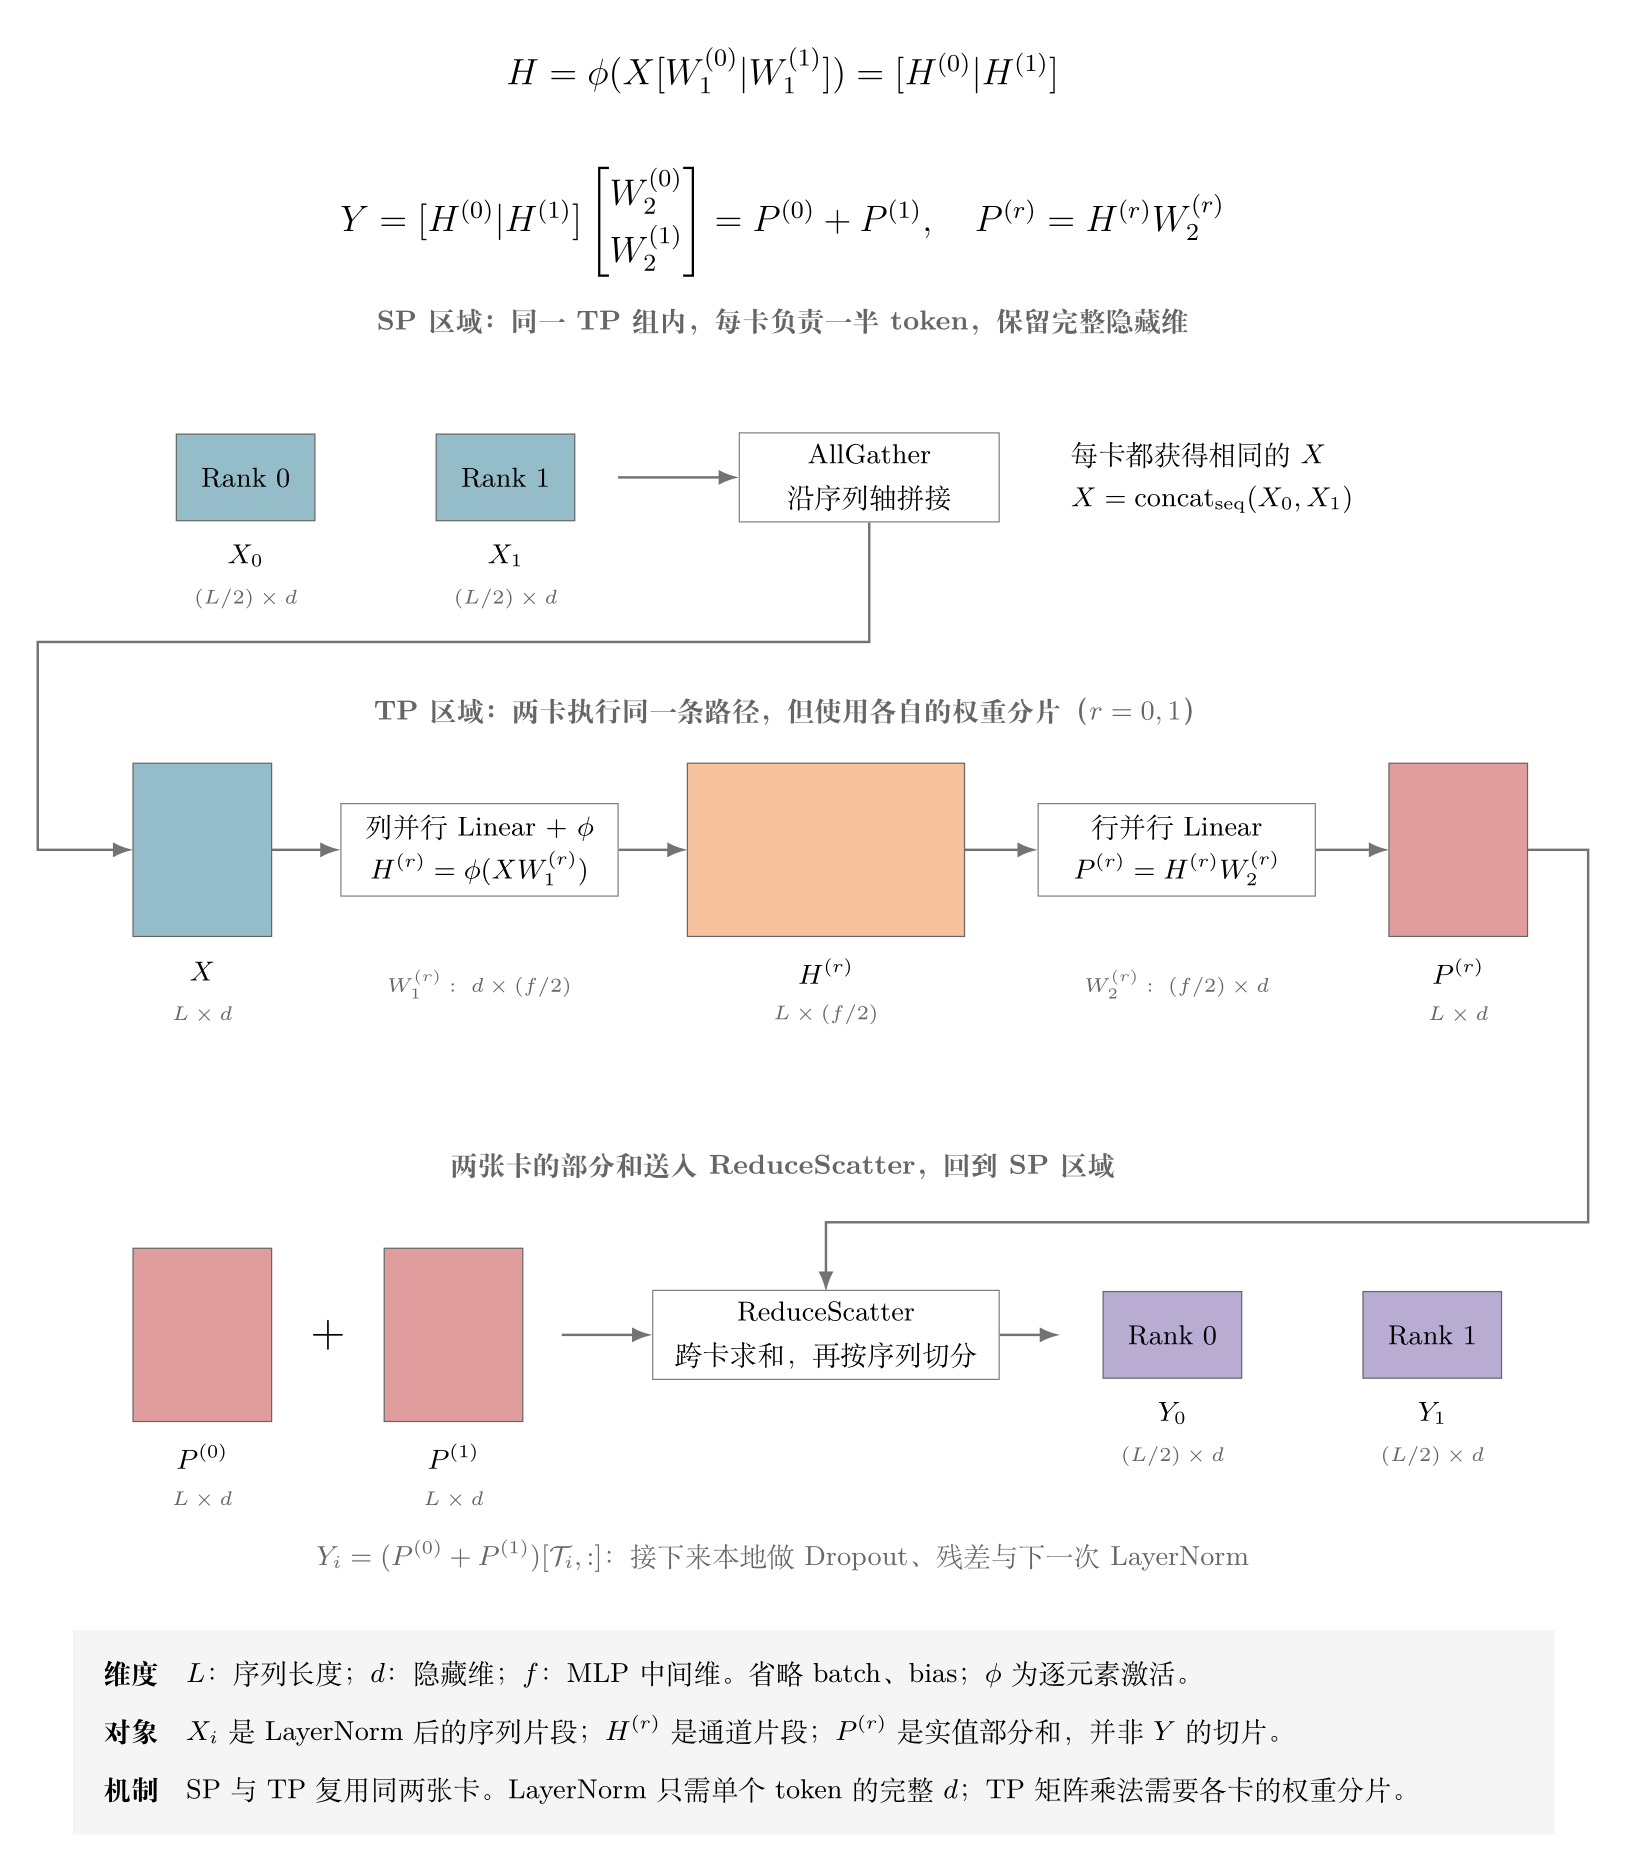
图从 LayerNorm 之后开始读。每卡先持有 $(L/2,d)$ 的 $X_i$;AllGather 沿序列轴拼出 $X$,两卡再分别使用自己的权重分片计算。MLP 结束后,ReduceScatter 对 $P^{(0)}$、$P^{(1)}$ 求和,并沿序列轴分发结果,重新回到每卡 $(L/2,d)$。
从通信语义上看,AllReduce 可以分解成 ReduceScatter 和 AllGather。SP 把这两步分开,在中间安排可以逐 token 执行的算子。于是这些区域只需要保存本地序列片段,TP 区域仍然可以按原来的方式计算。
这也解释了 SP 和 TP 的关系:它们在不同算子区域采用不同的激活布局,复用的是同一组 GPU。 TP=2 开启 Megatron SP,仍然只需要两张卡;SP 节省的是部分区域的激活,并没有把模型中所有张量都变成半份。
CP:把长上下文分到多组设备
Megatron SP 减少了 LayerNorm、Dropout 等区域的激活副本,但进入 TP 计算区域时,仍然需要收集该 TP 组负责的完整序列。上下文继续增长,Attention 和 MLP 的激活也会继续增长。
Megatron CP 把序列切分延伸到整个网络:不同 CP rank 负责同一批样本的不同 token 片段,MLP 等逐 token 算子可以处理本地片段,Attention 则通过跨卡通信访问其他片段的 KV。与 SP 复用 TP 组不同,CP 在常规 Megatron 配置中是独立的设备维度;例如 TP=2、CP=2,需要四张卡共同处理一份模型副本的计算。[4]
两者可以同时使用:CP 先划分上下文,在每个上下文分片内部,TP 分摊矩阵乘法,SP 再减少 TP 组内部分区域的激活副本。这里的“先”描述设备与数据的分组关系,不是额外的一次计算步骤。
CP 规定了上下文怎样分工,但没有把通信算法限定为 Ring。接下来真正需要回答的是:序列切开以后,Attention 怎样取得其他分片的信息?
分布式 Attention:Ulysses 与 Ring 两条路线
Attention 的跨 token 依赖,是实现 CP 时需要专门处理的部分。设序列被分到 $P$ 张卡,第 $i$ 张卡持有 $Q_i,K_i,V_i$。对于不带 mask 的 Attention,它要计算:
\[O_i=\operatorname{softmax}\!\left(\frac{Q_iK^\mathsf T}{\sqrt{d_h}}\right)V.\]输出只属于本地 query,但这里的 $K,V$ 来自完整序列。MLP 和 LayerNorm 可以就地处理本地 token,Attention 则必须通过通信取得完整上下文的信息。
Ulysses 和 Ring Attention 对这个问题给出了两种处理方式:Ulysses 在 Attention 前重新分工,让每张卡负责一部分 heads 的完整序列;Ring 保留 query 的序列分工,让不同位置的 KV 依次到达本卡。[2][3]
以下先用标准 MHA 说明,设 head 数为 $h$,每个 head 的维度为 $d_h$,所以 $d=hd_h$。图和公式省略 batch 维,矩阵面只表达逻辑形状。
Ulysses:用 All-to-All 把序列分片换成 head 分片
Ulysses 利用的是不同 attention heads 可以独立计算这一点。
进入 Attention 前,每张卡有一段序列的全部 heads,Q、K、V 的本地形状都是 $(L/P,h,d_h)$。通过 All-to-All,把每段序列中属于同一组 heads 的数据送到同一张卡,布局就变成了 $(L,h/P,d_h)$。[2]
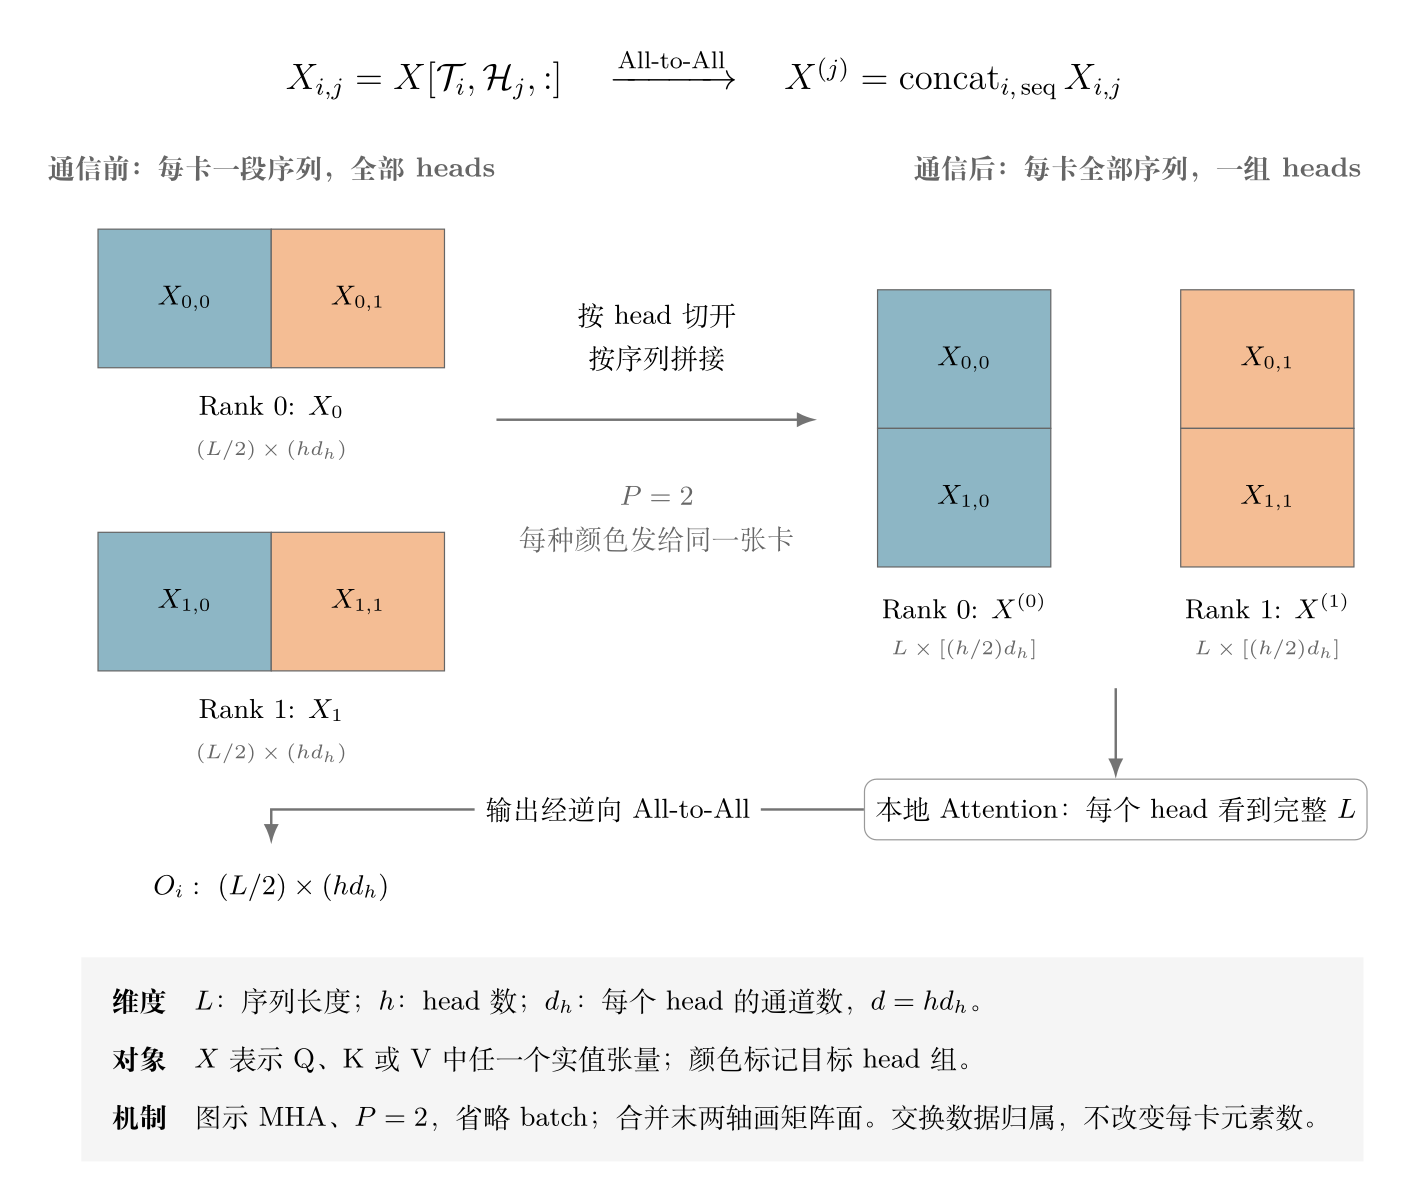
图中 $\mathcal T_i$ 表示第 $i$ 段 token,$\mathcal H_j$ 表示第 $j$ 组 heads,$X_{i,j}$ 是它们交叉的子块;$X$ 可以是 Q、K、V 中的任一个。两卡情况下,Rank 0 留下 $X_{0,0}$,发送 $X_{0,1}$,再接收 Rank 1 的 $X_{1,0}$。沿序列轴拼起来后,Rank 0 就拥有第一组 heads 的完整上下文。
接下来,每卡可以调用本地 Attention 内核,独立完成自己负责的 heads。算完之后,对输出做逆向 All-to-All,把结果还原为 $(L/P,h,d_h)$,继续处理本地 token。
用 4 张卡、16 个 token、8 个 heads 举例,单卡形状变化就是:
\[(4,8,d_h)\ \xrightarrow{\mathrm{All\text{-}to\text{-}All}} (16,2,d_h)\ \xrightarrow{\mathrm{Attention}} (16,2,d_h)\ \xrightarrow{\mathrm{All\text{-}to\text{-}All}} (4,8,d_h).\]这个例子也回答了一个直觉上的疑问:序列从 4 变成 16,显存是不是变大了?这里只看单个 Q、K 或 V,交换前后都是 $32d_h$ 个元素。序列变长的同时,head 数从 8 减到了 2。All-to-All 重新分配了数据,和把所有分片都收集到每张卡上的 AllGather 不同。
实际峰值还要算接收缓冲区、布局转换副本和反向需要保存的张量。Ulysses 配合 FlashAttention 时,也不必保存完整的注意力分数矩阵。因此,“用了 A2A”本身不能推出“比 Ring 更费显存”。[2][6]
按 head 分工也带来了限制。最直接的实现要求 $P$ 能整除 $h$;GQA 的 KV heads 更少,若 Q、K、V 都直接均分,还要求 $P$ 能整除 KV head 数。复制 KV 等扩展方案可以改变约束,但也会改变存储和通信开销。理解基础方案时,先记住它的分工单位是 head 就够了。
Ring Attention:Q 留在本地,KV 沿环传递
Megatron CP 使用环形 P2P 通信时,核心计算方式就属于 Ring Attention 这一类:Q 留在本地,KV 分块流转,通过 online softmax 合并结果。不过,CP 描述的是沿上下文维度切分计算的并行方案,Ring 只是其中一种实现方式;不能把 Megatron CP 与 Ring Attention 完全画等号。[4]
Ring Attention 保留原来的序列分工。第 $i$ 张卡始终计算自己的 $Q_i$,先用本地 KV 算一块,再接收邻卡传来的 KV,继续下一块。[3]
例如四卡环中,若 KV 从 Rank 0 向 Rank 1 的方向传递,那么 Rank 0 依次处理的是 $\mathrm{KV}_0,\mathrm{KV}_3,\mathrm{KV}_2,\mathrm{KV}_1$。计算覆盖了四块,取得其他三块只需要三次接收;完成后,输出自然仍属于本地 query。
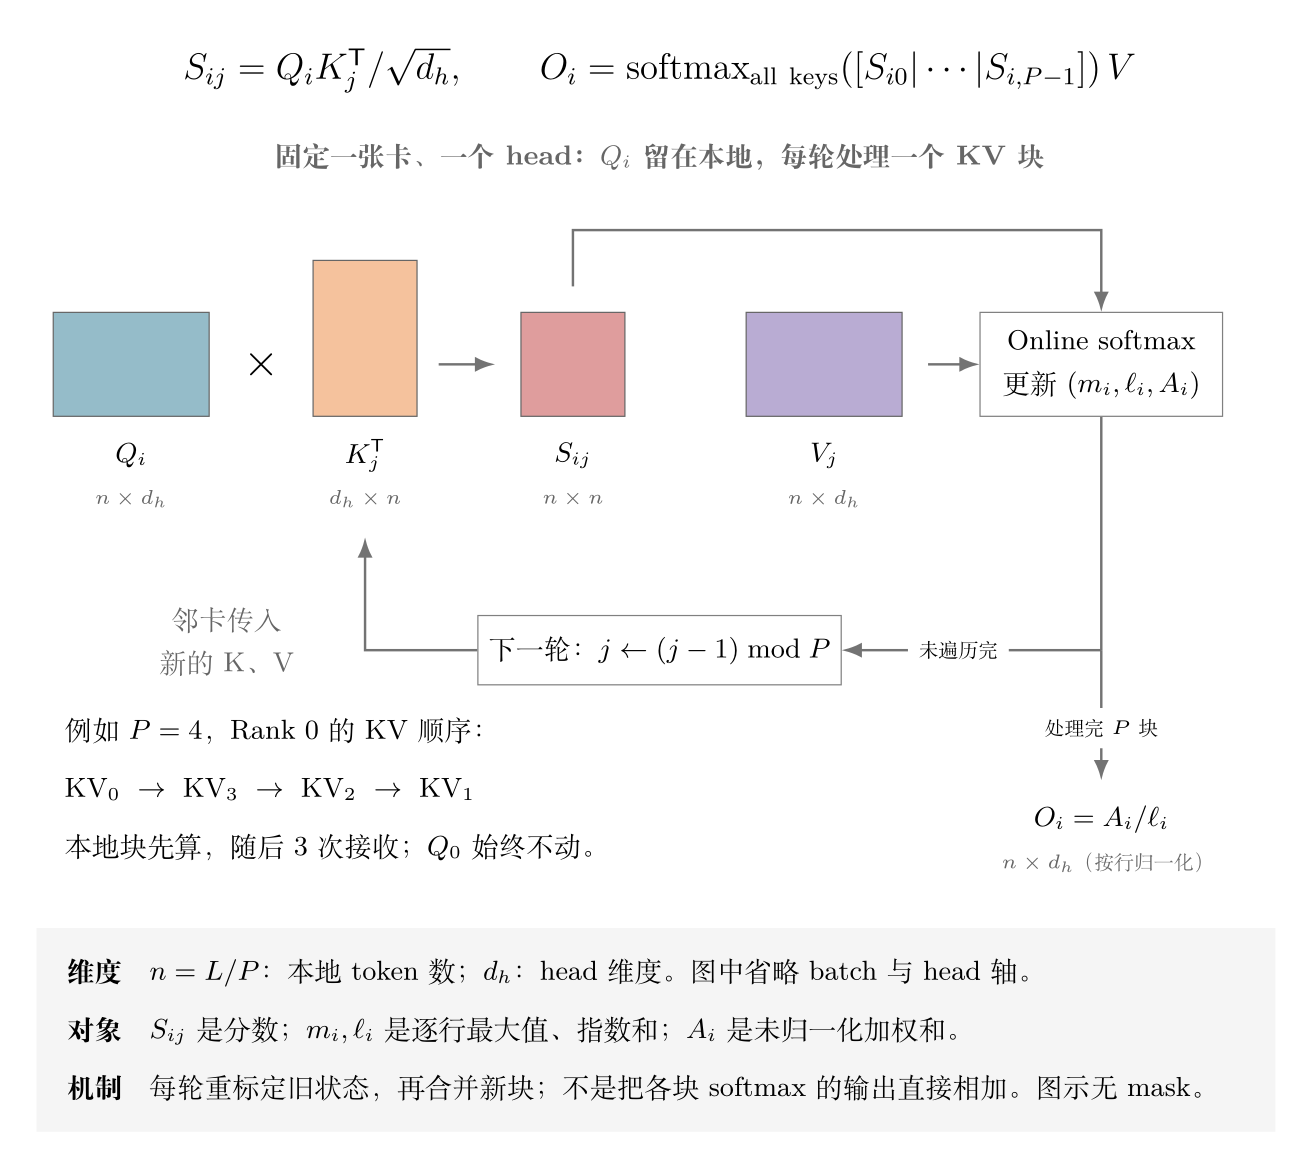
图中只看一个 head,记 $n=L/P$。本地 $Q_i$ 为 $n\times d_h$,当前 $K_j^\mathsf T$ 为 $d_h\times n$,两者相乘得到 $n\times n$ 的逻辑分数块。内核可以继续把它切成更小的 tile,不需要把这整个块写入显存。
真正需要处理的是 softmax:它的分母包含所有 key。每块各自做一次 softmax,再把输出相加,会把每块都当成一次完整的归一化,结果就错了。
Online softmax 为每个 query 行保存三个量:已见分数的最大值 $m$、在该最大值下缩放的指数和 $\ell$,以及同样缩放的未归一化加权和 $A$。新块 $S=Q_iK_j^\mathsf T/\sqrt{d_h}$ 到达时,先更新最大值,再把旧状态与新块放到同一个尺度上:
\[\begin{aligned} m'&=\max\bigl(m,\operatorname{rowmax}S\bigr),\\ \ell'&=e^{m-m'}\ell+\operatorname{rowsum}e^{S-m'},\\ A'&=e^{m-m'}A+e^{S-m'}V_j. \end{aligned}\]其中 $m,\ell$ 各有 $n$ 个元素,$A$ 的形状为 $n\times d_h$;指数和缩放按 query 行广播。从 $m=-\infty,\ell=0,A=0$ 开始,遍历完所有 KV 块,再按行计算 $O_i=A/\ell$,就得到包含完整上下文的输出。[3][6]
因此,Ring 前向的数据流更接近流式 AllGather KV:所有 KV 都经过本卡,但每次只处理一块,不要求同时保存完整 KV。这里的 Ring 描述传递路径,并不意味着执行了 ReduceScatter。
ReduceScatter 的语义出现在 KV 梯度上。同一个 $K_j,V_j$ 被多张卡的 query 使用,反向时会产生多份梯度贡献;这些贡献需要求和,再回到拥有第 $j$ 段 KV 的卡。Megatron CP 文档也据此把通信描述为前向 KV AllGather、反向 KV 梯度 ReduceScatter,并用环形 P2P 实现。[4]
对于 causal Attention,还要根据 query 和 key 的全局位置处理 mask。连续分片时,本地 Q 之前的 KV 块全部有效,之后的块可以跳过,同段块才需要下三角 mask。这样一来,序列前部的卡工作少,后部的卡工作多,实际实现还需要负载均衡。上图和更新式先展示无 mask 的路径;带 mask 的内核要单独处理整行或整块没有有效 key 的情况。
Ulysses 与 Ring 的代价:通信量和显存
先固定序列长度 $L$、模型维度和并行度 $P$,只统计一次 Attention 前向的每卡发送元素数;接收量相同,不计发给自己的部分,也不含反向传播。换成字节数时,再乘以每元素字节数。
对于 Ulysses,一个张量在每卡有 $Ld/P$ 个元素,其中 $1/P$ 留在本地。标准 MHA 的 Q、K、V 和输出共四份同尺寸张量,因此:
\[C_{\mathrm{Ulysses}} =4\frac{Ld}{P}\frac{P-1}{P}.\]对于 Ring,记全部 KV heads 的宽度为 $d_{KV}=h_{KV}d_h$。每轮发送一份 K 和一份 V,共 $2Ld_{KV}/P$ 个元素;无 mask 的完整遍历需要 $P-1$ 轮交换,因此:
\[C_{\mathrm{Ring}} =2\frac{Ld_{KV}}{P}(P-1).\]这两个式子是从张量形状直接数出的通信量。固定 $L$ 时,Ulysses 的量级为 $O(Ld/P)$,Ring 为 $O(Ld_{KV})$。如果让 $L$ 随卡数一起增长,比较的就变成了另一种扩展方式,不能再把“每卡通信量不变”和“随卡数下降”混在一起。
GQA 下也要统一口径。若 Ulysses 直接均分 heads,Q 和输出宽度为 $d$,K、V 宽度为 $d_{KV}$,上面的系数应改成:
\[C_{\mathrm{Ulysses,GQA}} =2L(d+d_{KV})\frac{P-1}{P^2}.\]KV heads 减少会降低 Ring 的传输量,同时也更容易触及 Ulysses 的 head 切分限制。只看 MHA 下的通信量,很难直接决定 GQA 模型应该选哪一种方案。
通信量之外,还要看时间能否重叠。Ring 可以在计算当前块时传递下一块,但序列分得越细,每块计算就越短,留给通信的隐藏空间也越小。是否能把通信藏住,要结合块大小、GPU 计算速度、链路带宽与延迟判断。环形的“邻居”只是逻辑关系,不保证两张卡之间有足够快的物理链路。
显存也有类似的问题。在相同 MHA 配置下,两种方案每卡持有的本地 QKV 基础规模都是 $O(Ld/P)$;Ulysses 的额外开销可能来自 A2A 缓冲和布局转换,Ring 则需要接收 KV 的缓冲以及在线归一化状态,重叠通信时还可能使用双缓冲。真实训练峰值还受张量生命周期和重计算策略影响。
如果 Ulysses 用朴素 Attention 保存完整分数矩阵,每卡需要约 $(h/P)L^2$ 个元素;Ring 单个逻辑分数块只有 $h(L/P)^2$ 个元素。但这个差别包含了整段计算与分块计算的区别。两边都使用 FlashAttention 后,就应回到实际保存的激活和工作缓冲上比较,不能把朴素 Attention 的二次方存储开销算到 A2A 头上。
组合与配置:区分算法组合和并行维度
Ulysses + Ring:组合两种 Attention 路线
Ulysses 与 Ring 可以组成二维并行。USP 就把两者结合起来,让 head 切分和序列环传共同承担长上下文计算。[7]
例如 256K token,取 Ulysses 度数为 4、Ring 度数为 2,共使用 8 张卡。每卡初始持有 32K token。在每个四卡 Ulysses 组内交换后,每卡得到 128K token 的四分之一 heads;再让两个组中负责相同 heads 的卡交换 KV,就能覆盖完整的 256K 上下文。
这种组合提供了按网络拓扑分配通信的空间:如果组内互联较快,可以把 All-to-All 安排在组内,把 Ring 放到组间。但并行度仍要结合 head 数和实际算通时间选择,而不是看到“节点内”就固定用 Ulysses,看到“节点间”就固定用 Ring。
TP + SP + CP:组织 Megatron 的设备分工
回到 Megatron,SP 与 CP 的组合需要按第一节的定义理解。一个常规 dense 模型的并行配置片段可以写成:[4]
--tensor-model-parallel-size 2 \
--sequence-parallel \
--context-parallel-size 2 \
--cp-comm-type p2p \
--pipeline-model-parallel-size 1
这里 CP 先把上下文分给两组设备,每组内部用 TP=2 完成矩阵乘法,Megatron SP 则复用这两张 TP 卡。它与前面的 Ulysses=4、Ring=2 是两种不同的设备组织方式。DeepSpeed 的 Megatron-DeepSpeed 教程使用 --ds-sequence-parallel-size 配置 Ulysses,名称中虽然同样有 sequence parallel,也不能直接把它当成 Megatron 的 --sequence-parallel。[5]
对上面的常规 Megatron 配置,总卡数满足:
\[W=P_{DP}P_{TP}P_{CP}P_{PP}.\]如果总共 8 张卡,TP=2、CP=2、PP=1,那么 DP=2。开启 Megatron SP 不会再占用一个独立的设备维度;FSDP 在数据并行组内分片模型状态,也不应在这个式子里再额外除一次。
同一个 CP 组处理的是同一批样本的不同 token 片段,因此全局 batch 仍按独立样本数计算:
\[\mathrm{GlobalBatch} =\mathrm{MicroBatch}\times P_{DP}\times\mathrm{GradAccStep}.\]这里 MicroBatch 指每个数据并行副本单次处理的序列条数。把更多卡用于 CP、使 DP 变小时,可以通过梯度累积维持全局 batch,但训练一步的耗时也会随之变化。
实际配置时,我更倾向于先跟踪一层里的张量:当前这张卡拿的是全部 token 的一部分通道,还是一部分 token 的全部通道?下一步缺少的是输入数据,还是其他卡算出的部分和?前者决定怎样收集或交换,后者决定在哪里归约。沿着这条计算路径看,SP 与 CP 的分工,以及 Ulysses、Ring 各自承担的通信和计算就容易分清了。
参考
[1] Korthikanti, V., et al. Reducing Activation Recomputation in Large Transformer Models. 2022,MLSys 2023. arXiv:2205.05198(Megatron SP)。
[2] Jacobs, S., et al. DeepSpeed Ulysses: System Optimizations for Enabling Training of Extreme Long Sequence Transformer Models. 2023. arXiv:2309.14509。
[3] Liu, H., et al. Ring Attention with Blockwise Transformers for Near-Infinite Context. 2023,ICLR 2024. arXiv:2310.01889。
[4] NVIDIA. Megatron Core: Context Parallel Package;Parallelism Strategies Guide。
[5] DeepSpeed. Getting Started with DeepSpeed-Ulysses。
[6] Dao, T., et al. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. 2022. arXiv:2205.14135。
[7] Fang, J., Zhao, S. USP: A Unified Sequence Parallelism Approach for Long Context Generative AI. 2024. arXiv:2405.07719。