前置阅读:LLM 推理(Inference)性能推导 · DualPath:用双路径 KV-Cache 加载打破 Agentic 推理的存储瓶颈 · 昇腾 950 的两种显存方案:白鹭、朱雀与 PD 分离
推理时,显存里有两类数据值得单独拿出来看:模型权重在加载后基本只读;KV cache 会随上下文增长,读多写少;它们都需要很大的存储空间,并且需要很高的读取速度
HBF(High Bandwidth Flash,高带宽闪存)用 NAND 提供大容量,再通过宽接口和内部并行提高读取带宽。这让它与推理中的两类数据产生了联系:只读权重可以尝试放到 HBF,尤其是总参数量大、每个 token 只激活部分专家的 MoE;具有复用价值的 KV,则可以探索放入 HBM 之外的二级缓存。
本文从 Asianometry 的《High Bandwidth Flash Is Coming》出发,结合 OCP 规格和两篇 HBF 推理研究,沿着这两条路径讨论可行性。[1–6] 重点是哪些数据适合放进去、需要怎样读回来,具体的性能和成本收益留给实现与实验回答。
1. 推理的时候,什么在占显存
1.1 权重:容量大,加载后基本只读
在使用固定模型进行推理时,权重会被不同请求、不同 token 反复使用,通常只在加载或切换模型时更新。这种“写入一次、长期读取”的访问方式,与闪存更擅长读取的特点比较契合。
设模型有 $P$ 个参数,每个参数用 $q$ bit 表示,参数本体的存储量为
\[M_{\mathrm{weights}}=P\frac{q}{8}.\]例如,一个万亿参数模型采用 8 bit 权重,仅参数本体就约为 1 TB,还没有计入量化元数据和运行时空间。MoE 同样需要保存全部专家的权重,即使单个 token 只调用其中一部分。因此,推理系统既要容纳完整模型,又要及时读出当前计算需要的权重。
1.2 KV cache:持续追加,历史数据反复读取
KV cache 保存的是已经处理过的 token 的 Key 和 Value。对常规自回归解码,每生成一个新 token,就追加它的 KV;之后的 token 通过读取所需的历史 KV 完成 attention。对于使用完整历史上下文的 attention,单步只新增一个 token 的 KV,却会读取此前许多 token 的 KV,所以随着上下文增长,逻辑访问通常呈现读多写少的特点。
它的容量也会随上下文长度和并发请求数增长。对于各层形状相同的常规 MHA/GQA,设层数为 $L$,KV head 数为 $h_{\mathrm{KV}}$,每个 head 的维度为 $d_h$,每个缓存元素占 $s_{\mathrm{KV}}$ byte,第 $i$ 个请求保留 $S_i$ 个 token,则逻辑 KV 总量为
\[M_{\mathrm{KV}} =2Lh_{\mathrm{KV}}d_hs_{\mathrm{KV}}\sum_i S_i.\]前面的 2 分别对应 Key 和 Value。这里应代入 KV head 数;GQA 让多组 Query head 共享较少的 KV head,不能直接用 Query head 数计算缓存。[4]
取一个具体配置:32 层、8 个 KV head、head dimension 为 128,每个元素 2 byte。一个请求保留 32768 个 token 时,KV cache 就是 4 GiB;32 个这样的并发请求需要 128 GiB。
这给 HBF 提供了另一个值得探索的方向:在 HBM 之外保留更多可复用的上下文。但 KV 的“读多写少”描述的是模型如何使用它,放入二级缓存以后,实际产生多少保存和读回流量,还取决于缓存策略。
2. HBF 提供了什么:大容量与高读取带宽
HBF 的基本结构是 NAND core die 堆叠在逻辑 base die 上,通过 TSV 连接,再由基底上的控制器和 PHY 经 UCIe 接口与计算芯片通信。它借用了 HBM 的封装思路,存储介质换成了密度更高的闪存。这里的裸片堆叠,与 3D NAND 在单颗裸片内部堆叠存储单元层,是两个层级的结构。[2]
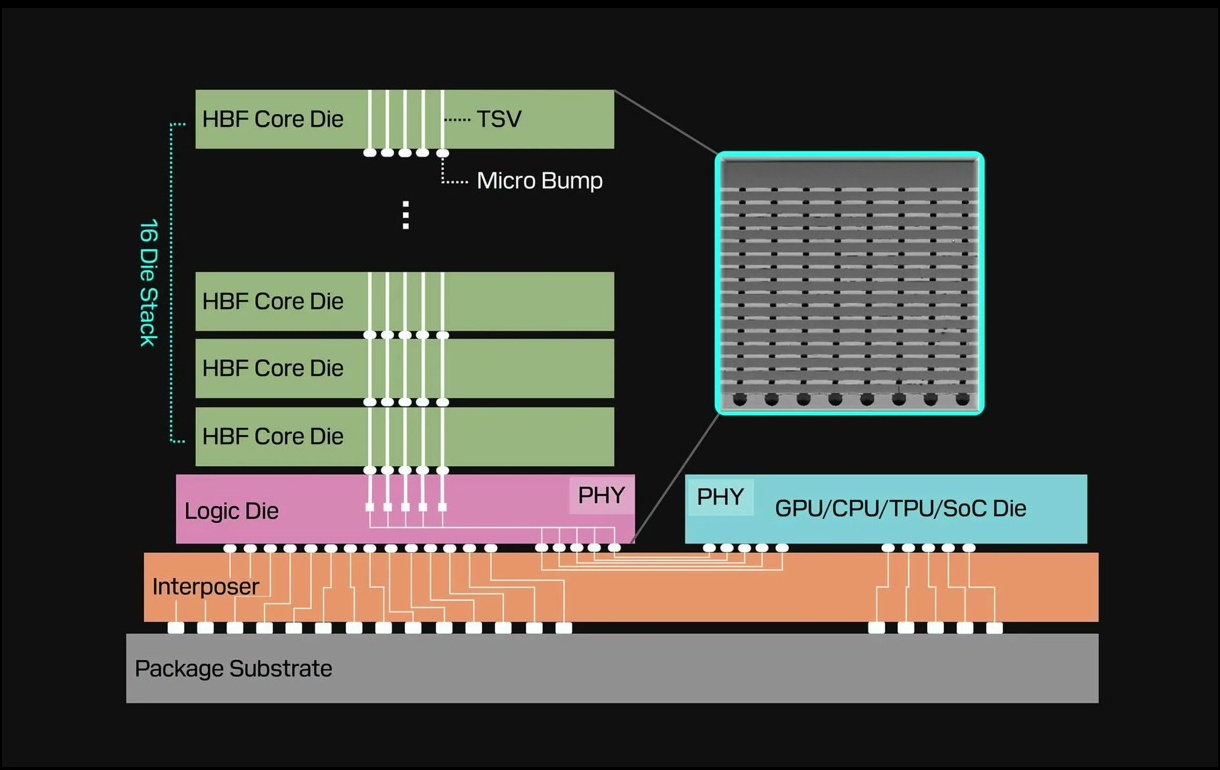
图:原视频 08:04 的结构示意,展示多颗 NAND 裸片与逻辑基底的连接。[1]
OCP 0.7.0 版规格明确了 HBF 到计算芯片的连接方式:封装内的 UCIe 互连,上面承载 AXI 协议。UCIe 用来连接同一封装里的不同芯粒;GPU/AI 处理器通过这条链路与 HBF 逻辑基底通信,基底再访问 NAND 堆叠。该规格选择先进封装,通道最大支持距离为 2 mm,按两端连接凸点之间测量。因此,这套方案中的 HBF 是放在计算芯片旁边、通过短距离宽接口连接的独立闪存堆栈,并不是普通 SSD 通过 PCIe/NVMe 接入的路线。[2]
连接方式已经有明确规格;具体哪些 GPU 支持、集成多少颗 HBF、怎样与 HBM 搭配,则要看产品实现。计算芯片一侧也需要配套的接口、控制器和数据通路,现有显卡不能仅凭这份规格就直接加装 HBF。[2][3]
OCP 0.7.0 版规格给出的最高档配置包含 16 个 host channel,每通道 64 bit、32 GT/s。按表 2 的 75% 接口效率计算,有效接口带宽为 3072 GB/s;表 3 中,16 层裸片对应 512 GiB 用户容量。[2] SK hynix 也将 HBF 定位在 HBM 与 SSD 之间。[3]
下面保留几个量级作对照。HBM、HBF 按单堆栈列出,SSD 按单块盘列出;带宽使用十进制单位。表中的产品规格、接口目标和论文假设分别标明。
| 对象 | 容量示例 | 读取/接口带宽 | 写入说明 |
|---|---|---|---|
| KIOXIA CM7-V,单块 PCIe 5.0 SSD | 3.2 TB | 顺序读最高 14 GB/s | 顺序写最高 6.75 GB/s,产品规格 [7] |
| Micron HBM3E,单堆栈 | 24/36 GB | 总接口带宽超过 1200 GB/s | 读写共享接口带宽 [8] |
| Micron HBM4,12-high 单堆栈 | 36 GB | 总接口带宽超过 2800 GB/s | 读写共享接口带宽 [9] |
| OCP HBF,最高档单堆栈 | 512 GiB | 有效接口带宽 3072 GB/s | 接口数值不代表 NAND 持续写带宽 [2] |
| 《Exploring HBF》建模的单堆栈 | 512 GB | 读 1600 GB/s | 写 16 GB/s,为论文假设 [5] |
HBF 吸引人的地方就在这里:单堆栈有数百 GB 容量,读取目标进入 TB/s 量级,让计算芯片有机会从闪存层及时取得数据。整机能获得多少带宽,还取决于堆栈数量与访问并行度。
写入则是另一回事。《Exploring HBF》采用每堆栈 1.6 TB/s 读带宽、16 GB/s 写带宽,其中 100 μs 的页编程延迟是因缺少公开写性能而设置的建模假设。[5] 这组数字用于说明读写不对称,不能直接当成产品规格。NAND 还具有有限的编程/擦除寿命,因此少写、反复读的数据更容易发挥它的长处。[5][6]
沿着这个特点,先来看最直接的一类数据:权重。
3. 权重放在 HBF,为什么 MoE 尤其值得尝试
3.1 保存完整权重,按需送到计算侧
一种可探索的组织方式,是让完整权重常驻 HBF,计算时读取当前需要的权重块;HBM 或 SRAM 承担计算侧缓冲,也可以缓存反复使用的热点权重。[5] 这样,大模型的存储容量可以由 HBF 分担,HBM 则为活跃数据和临时张量留出空间。
接下来要看的是,每一步到底需要读多少。
3.2 MoE 把总参数量与当前使用量分开
Dense 模型在一次前向中会使用各层的主要权重。MoE 的路由专家则不同:全部专家都需要保存,但一个 token 只选择其中一部分。模型需要的总容量很大,单个 token 要读取的专家权重却可能只占一小部分。 这正是 MoE 与 HBF 比较契合的地方。
例如,一层有 256 个等大小的路由专家,每个 token 选择 8 个,那么单个 token 只使用这一层 3.125% 的路由专家权重。其余专家仍然需要有地方存放,却不必都为这个 token 读到计算侧。Attention 和共享专家等公共部分需要另行计入。
当多个 token 一起执行时,所需专家的集合会扩大。为了看清这个趋势,可以沿用一个简化模型:一层有 $N$ 个等大小专家,每个 token 均匀选择 $k$ 个不同专家,token 之间独立选择。一个专家未被 $B$ 个 token 中任何一个选中的概率为 $(1-k/N)^B$,因此该步使用的专家比例期望为
\[f(B)=1-\left(1-\frac{k}{N}\right)^B.\]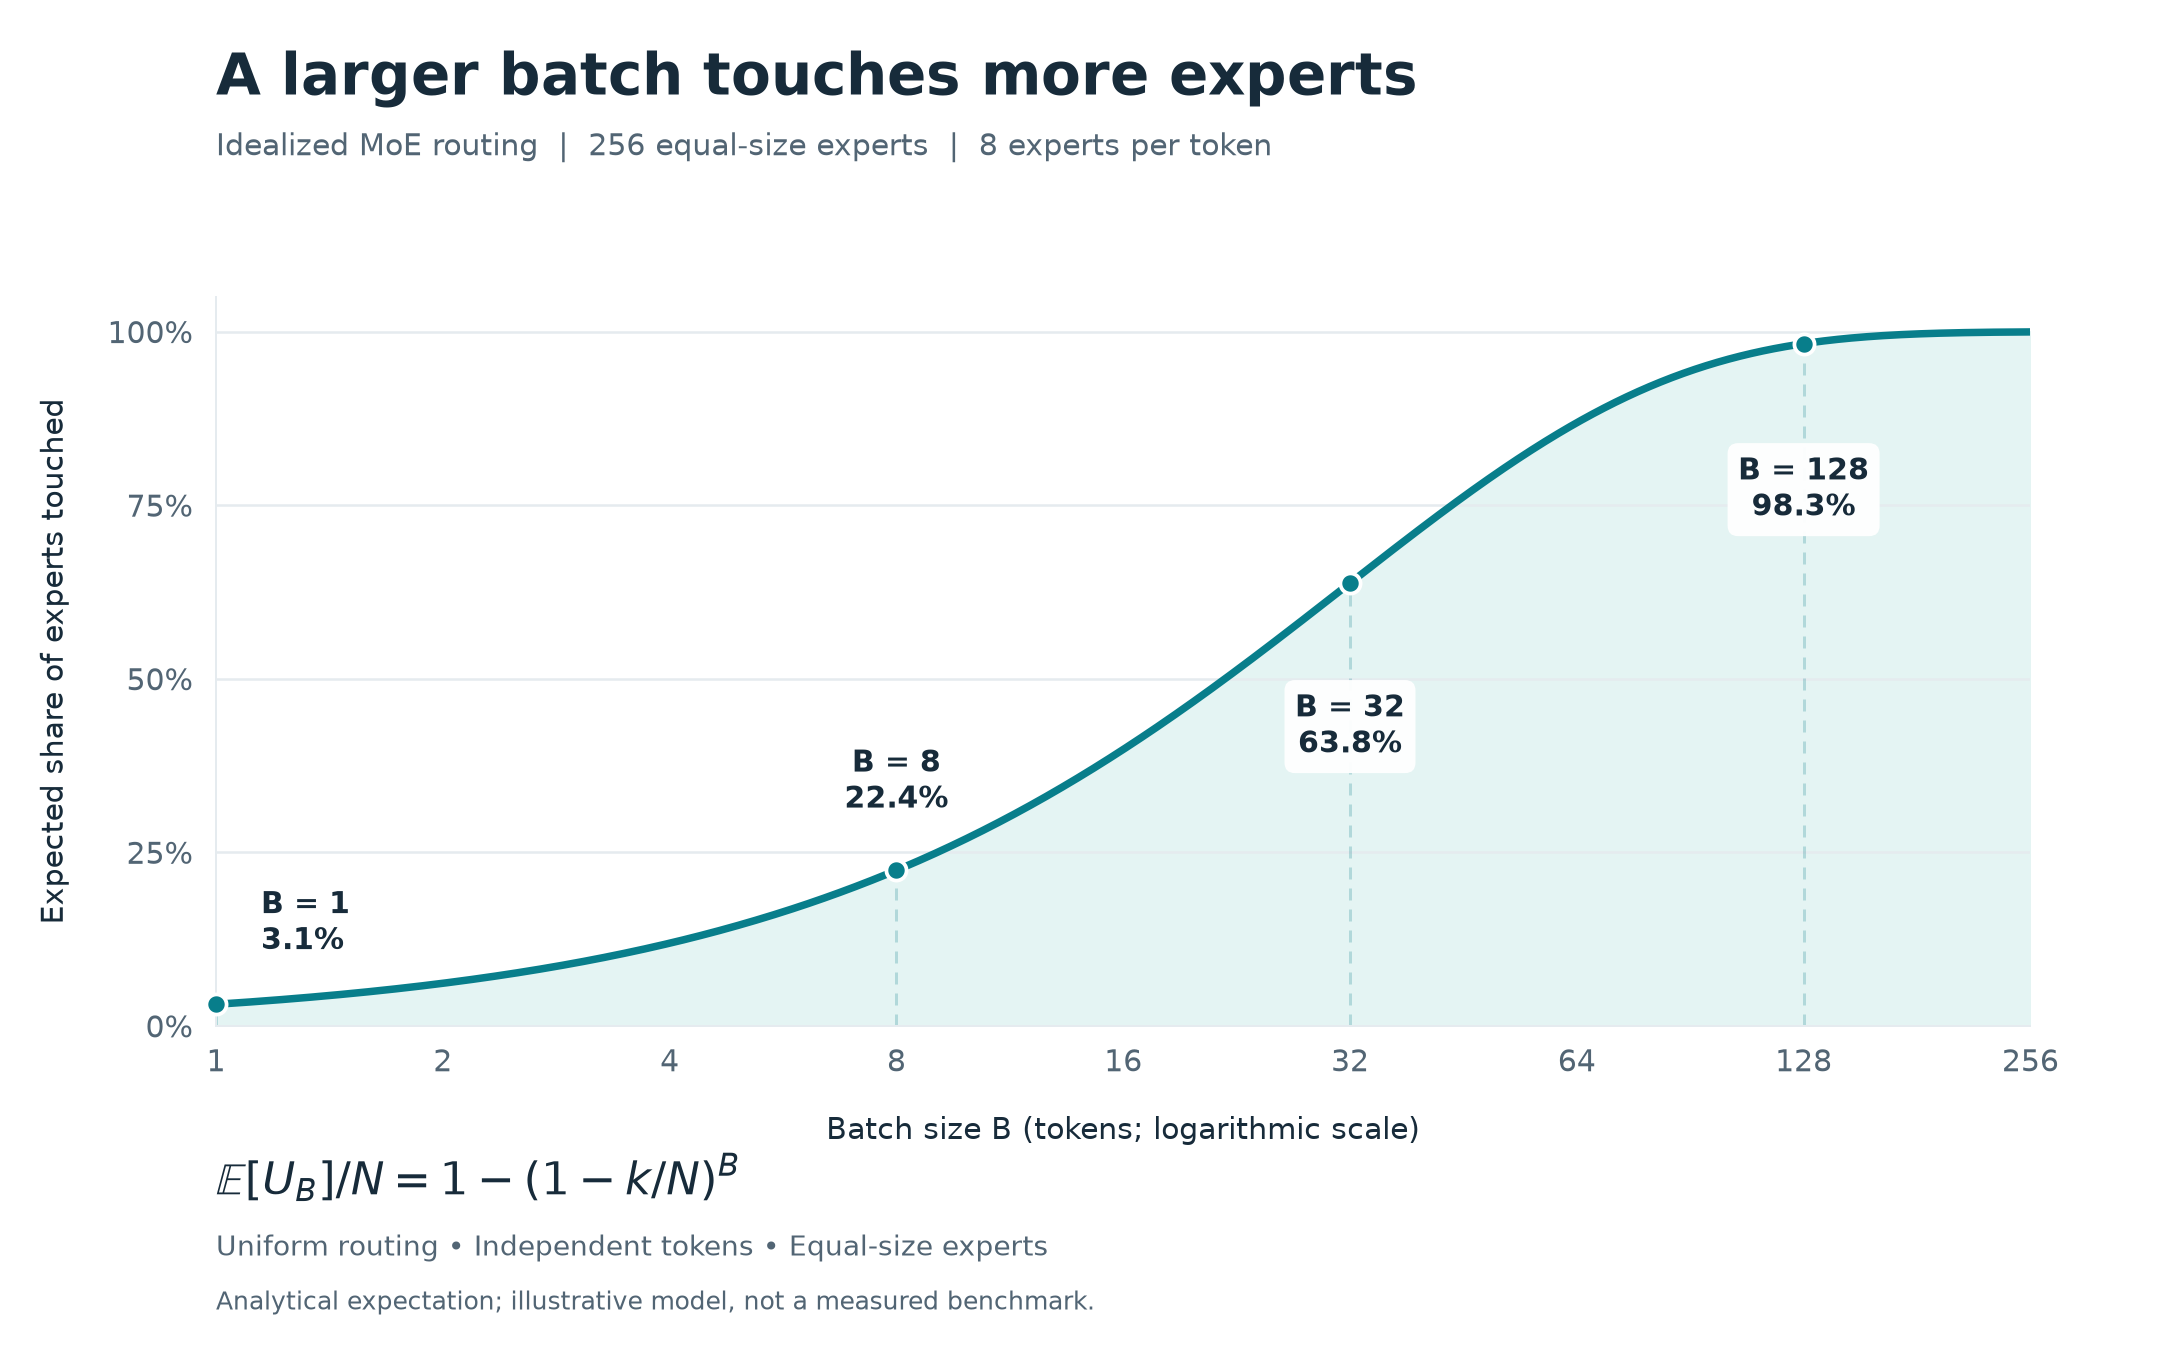
图:按上述简化模型绘制,$N=256$、$k=8$,只统计路由专家的覆盖比例。
在这组配置下,batch 为 8 时,期望覆盖约 22.4% 的专家;batch 到 128 时,覆盖率接近 98.3%。与此同时,同一专家的权重可以被该批中的多个 token 复用。因此,这张图说明的是每步工作集如何扩大,实际搬运量还要结合权重缓存和 kernel 的复用方式判断。
MoE 给 HBF 留出的机会,是用大容量保存全部专家,再按路由结果读取当前需要的部分。小批量时,少量激活专家可能使单步读取量较小;批量增大后,则需要依靠权重复用和更多并行读取满足供数需求。
3.3 可行性的关键:需要的权重能否及时送达
设一个 step 需要从 HBF 新取的权重为 $D_{\mathrm{miss}}$,HBF 到计算侧的有效读取带宽为 $\beta_{\mathrm{delivered}}$,纯搬运时间的下界为
\[t_{\mathrm{read,min}} =\frac{D_{\mathrm{miss}}}{\beta_{\mathrm{delivered}}}.\]权重缓存可以减少 $D_{\mathrm{miss}}$,预取可以把部分搬运与计算重叠。MoE 的专家选择依赖路由结果,实际能提前多久读取、哪些专家值得常驻 HBM,需要由运行时决定。即使计算侧的 HBM 很快,缓存未命中的权重仍要经过 HBF 这条供数路径。[5]
读取量较大时,也可以增加独立 HBF 堆栈和接口,并将同一步需要的数据分布到不同堆栈上。OCP 规格给出了一个 host 连接四个 HBF chipset 的示例。[2] 这里要一起满足的是模型容量、主机接收能力和当前计算的读取需求。
所以,MoE 权重是一个比较直接的可行性起点:只读属性减少了写入负担,稀疏激活又为按需读取创造了空间。能否保持目标推理速度,接下来就要看缓存、预取和供数能力的配合。
4. KV cache:作为 HBM 之外的二级缓存
4.1 把可复用的上下文留在更大的容量层
KV 与权重的区别在于,它会随请求不断产生。一次 prefill 可以生成大量 KV,decode 又会逐步追加。已有 KV 在上下文不变时通常可以继续复用,这让它也具备“保存后多次读取”的可能。
这里更值得先讨论的,是把 HBF 作为 HBM 之后、由运行时管理的二级 KV 缓存。“二级”指运行时管理的数据分层,不是 GPU 的硬件 L2 cache,也不意味着通过 PCIe 外接;HBM 和 HBF 可以同处计算芯片的封装内。
一种可探索的安排是:当前请求频繁使用的 KV 留在 HBM;暂时不活跃、但预计还会被使用的共享前缀或会话块,保留到 HBF;后续请求命中时,再把所需块读回 HBM 参与计算。
例如,一个较长的公共前缀在 HBM 中暂时被淘汰后,可以继续保留在 HBF。后续请求使用相同前缀时,运行时检查模型版本、token 前缀等缓存匹配条件,命中后恢复对应的 KV,后续新增部分仍按正常推理流程计算。这条路径提供的机会,是用更大的缓存保留范围减少重复 prefill,或者减少从更远存储层读取的次数。
对于长会话,也可以在暂时没有生成任务时,将值得保留的 KV 块放到 HBF,等会话恢复时读回。保存、恢复和淘汰都以块为单位,由运行时按复用价值安排。这是分层缓存的设计思路,具体收益需要结合请求行为验证。[6]
4.2 历史 KV 不一定是冷数据
将 KV 分层时,要按访问频率判断位置。一个 token 距离当前生成位置很远,并不意味着它已经很少被读取:如果活跃请求仍使用完整历史 attention,这块旧 KV 可能在每一步都参与计算。
因此,活跃请求正在反复使用的 KV 应优先留在 HBM。若工作集超过 HBM 容量、必须在解码期间从 HBF 分块读入,那么 HBF 的读取就进入了每步计算路径,需要另外安排读取并行和计算重叠。它与“请求恢复时读回一次”的缓存用途,对带宽和时延的要求不同。[5][6]
4.3 读多写少,要在 HBF 这一层成立
KV 在 attention 中被反复读取,是考虑 HBF 的出发点。但当热数据留在 HBM 后,这些读取大多也留在 HBM。如果 HBF 不断接收被淘汰的块,而这些块以后很少再次命中,HBF 自己承受的流量仍可能以写入为主。
因此,保存策略需要选择具有复用价值的块。对于稳定的共享前缀,一次保存可能换来后续多次恢复;对于很快过期、之后不再被使用的 KV,保存只增加了写入和容量占用。合并较小写入、按块组织数据有助于适配闪存,但首先要决定哪些内容值得保存。OCP 的 KV 指南也将布局和读写组织留给理解模型访问模式的主机软件。[2]
两篇 HBF 研究提供了不同侧面的参考:《Exploring HBF》讨论权重与 KV 驻留 HBF 的主内存方案;《HBF Sucks?》研究保留 save/restore 策略的分层 KV 池,指出热复用被近端内存吸收后,容量层可能接到大量低复用写入。[5][6] 后者同时讨论了共享前缀通过多次复用摊薄写入成本的机会。因此,KV 二级缓存的可行性,应落在具体的保存与复用策略上。
从这个角度看,HBF 为推理提供了两条值得探索的路径:让只读权重,尤其是 MoE 的完整专家集合,获得更大的存放空间;让值得复用的 KV 在离开 HBM 后继续保留。前者主要关注按需供数,后者主要关注缓存命中与保存成本。
One More thing
讨论在 HBM 与 SSD 之间增加一层,很容易想到 Intel 傲腾。它曾用 3D XPoint 提供低延迟 SSD 和 CPU 持久内存,最终退出市场。不过,傲腾当时也有明确需求:扩大内存容量、改善存储访问延迟、缩短内存数据库的恢复时间。Intel 的产品资料中就有 SAP HANA 减少数据重载时间的案例,Memory Mode 也提供了较少修改应用的扩容路径。[10]
从这些产品路线看,傲腾需要分别证明不同的价值:做 SSD,要让低延迟值得额外的容量成本;做内存扩展,要平衡容量收益与访问性能;用 App Direct 发挥持久性,则涉及数据结构、持久化顺序和恢复逻辑的适配。需求各自成立。Micron 在 2021 年停止 3D XPoint 开发时,给出的理由是市场验证不足以支撑继续为规模化商业化投入大量资金;Intel 随后也收缩了 Optane 业务。[11][12]
相比之下,HBF 面向 LLM 推理的需求更集中,尤其是只读的 MoE 权重。
需求集中还有一个可能的好处:软件适配可以围绕推理引擎展开。专家放置、预取、KV 的保存与淘汰,都有明确的管理位置。
参考
[1] Asianometry,High Bandwidth Flash Is Coming,2026-09-24。本文的阅读起点;结构插图摘自视频 08:04。
[2] Chinnakrishnan Ballapuram、Dongsop Lee,High Bandwidth Flash (HBF™) High-Level Base Die Specification, v0.7.0,OCP,2026-08-03。第 4 章的容量、带宽与系统组织,第 5.1.1、5.2.1 节的封装内 UCIe 与 AXI 协议,以及第 13.3 节的权重和 KV 使用指南。
[3] SK hynix,SK hynix Unveils First HBF Standard Specifications with Sandisk, Presenting AI Memory Solutions at ‘FMS 2026’,2026-08-04。
[4] Joshua Ainslie 等,GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints,2023,arXiv:2305.13245。
[5] Dowon Son 等,Exploring High-Bandwidth Flash for Modern LLM Inference: Opportunities and Challenges,2026,arXiv:2608.13868。本文引用的读写带宽为论文建模参数。
[6] Zhuoran Li 等,HBF Sucks? A Full-Stack Characterization of High-Bandwidth Flash for KV-Centric LLM Serving,2026,arXiv:2608.11668,v4。重点参考第 7.1 节对不同放置策略与 KV 复用的讨论。
[7] KIOXIA,CM7-V Series (2.5-inch),产品规格,访问日期 2026-10-18。采用 3.2 TB 型号的顺序读写数值。
[8] Micron,HBM3E,产品规格,访问日期 2026-10-18。
[9] Micron,HBM4,产品规格,访问日期 2026-10-18。
[10] Intel,Intel Optane DC Persistent Memory Product Brief,2019。Memory Mode、App Direct 与 SAP HANA 数据重载案例。
[11] Micron,Micron Updates Data Center Portfolio Strategy to Address Growing Opportunity for Memory and Storage Hierarchy Innovation,2021-03-16。停止 3D XPoint 开发的市场验证与投入判断。
[12] Intel,Intel Reports Second-Quarter 2022 Financial Results,2022-07-28。Optane 业务收缩。
[13] SK hynix,SK hynix Announces 2Q26 Financial Results,2026-07-29。AI 基础设施带动的内存需求与供给情况;所述供需判断针对其内存市场整体。