前置阅读:顺着 FlashAttention 看 SM120 的实现 · MXFP8 与 SM120:硬件支持之后,软件还缺什么
项目状态核对于 2026-10-27。性能数据来自论文和项目报告,本文未在硬件上复测。
NVIDIA CMP 170HX 是一张矿卡,用的是和 A100 同款的 GA100 芯片,但出厂时 FP32 只有几百 GFLOPS,显存只开放 10 GB,PCIe 锁在 Gen1。有研究者纯靠软件把它恢复到约 12.2 TFLOPS,打开了板上实际存在的 80 GB 显存,PCIe 也提到了 Gen2。[1]
有意思的是限制到底卡在哪一层。eFuse 在出厂时已经烧好,厂商固件有加密和签名,主机拿到 root 也改不了 GPU 的受保护寄存器。研究者的做法是:先用 debug 固件的已知测试密钥解密出明文来分析,再利用签名程序里的内存安全漏洞拿到权限,最后改掉这些配置。
后来针对 GeForce 的解锁项目沿用了这套思路:在正式驱动接管之前,先跑一段针对该芯片的固件利用程序,把指令速率配置改掉。RTX 20、30、40 系都已经有人实测过,范围各不相同;50 系目前还没有公开、可复现的方案。下面先把 CMP 170HX 讲清楚,再逐代看显卡。
CMP 170HX:熔丝已经烧了,限制靠什么生效
CMP 是 Cryptocurrency Mining Processor 的缩写,即 NVIDIA 的挖矿专用卡。矿卡退役后,社区开始琢磨拿它跑通用计算。早期有人通过改 CUDA 程序绕开 CMP 170HX 被限速的 FMA(Fused Multiply-Add,融合乘加)指令,找回了一部分应用性能。[2]
Jon Pry 的《A Canary in the Crypto Mine》往下挖得更深,直接从固件层面恢复被限制的计算速率,还顺带改了显存几何配置和 PCIe 速率。[1]
关键在于区分 eFuse 的物理状态和限制的执行方式。eFuse 是一次性写入的配置存储,其中一部分位由硬件直接采样,另一部分则由固件读出来,再写进真正控制行为的寄存器。后一种情况下,最终起作用的是固件和那些可以覆写的寄存器。
论文研究的链路大致如下:
eFuse / SKU 配置
    ↓ 固件读取
影子值、功能覆写与速率选择寄存器
    ↓ 硬件按配置执行
算力、显存寻址范围和 PCIe 能力
这些寄存器受 GPU 内部的访问权限保护。主机可以通过 BAR0 映射到一部分寄存器,但写目标配置时,GPU 会检查请求的权限和来源。Linux 的 root 只管得了主机这一侧,GPU 的安全处理器有自己的一套规则。
所以解锁的第一步是拿权限:只要能在 GPU 的高权限固件环境里执行代码,就能先打开访问控制,再从主机改功能配置。eFuse 一位都没动,变的是限制生效时读取的那份状态。
从编号 37 的测试密钥开始
这段历史常被说成”NVIDIA 的密码太简单”。公开材料能确认的是:部分 debug Booter 用的是公开的编号测试密钥方案,编号为 37,研究者据此解密固件,拿到了明文代码。[3][4]
Booter 是 GPU 安全启动链中的一段引导微码。在 Ampere 上,它运行在 SEC2 安全处理器里,负责验证、解密和加载后续固件。想在里面找漏洞,得先读懂它。
固件加密本来让这一步很难做,但公开的 debug 镜像改变了局面:测试密钥可以按已知方案重建,不用去穷举密钥空间。加密算法是 AES(Advanced Encryption Standard,高级加密标准),”37”是测试密钥的索引号,不是说 AES 密钥本身就是字符串 37。
CMP 社区分析 GA100 镜像时记录到,debug 和 production 镜像的明文代码相同,只是加密密钥不同;Ampere 项目则说两者”非常接近”。不管哪种说法,研究路线都一样:先读能解密的 debug 镜像,再对照实际目标核对代码和地址。[3][4]
解密之后,就可以用反汇编器理清函数、DMA 操作和栈布局,寻找能拼接的代码片段。不过这只解决了”看得懂”的问题。GPU 加载高权限固件时还要验数字签名。
这是两套不同的密码学机制:AES 加密保护固件内容不被看到,签名保证固件来源可信、没被篡改。已知测试密钥破的是前者;要真正利用,还得在签名验证通过之后,找出程序运行时的缺陷。Canary 论文明确说明,研究既没有伪造签名,也没有拿到厂商的生产签名私钥。[1]
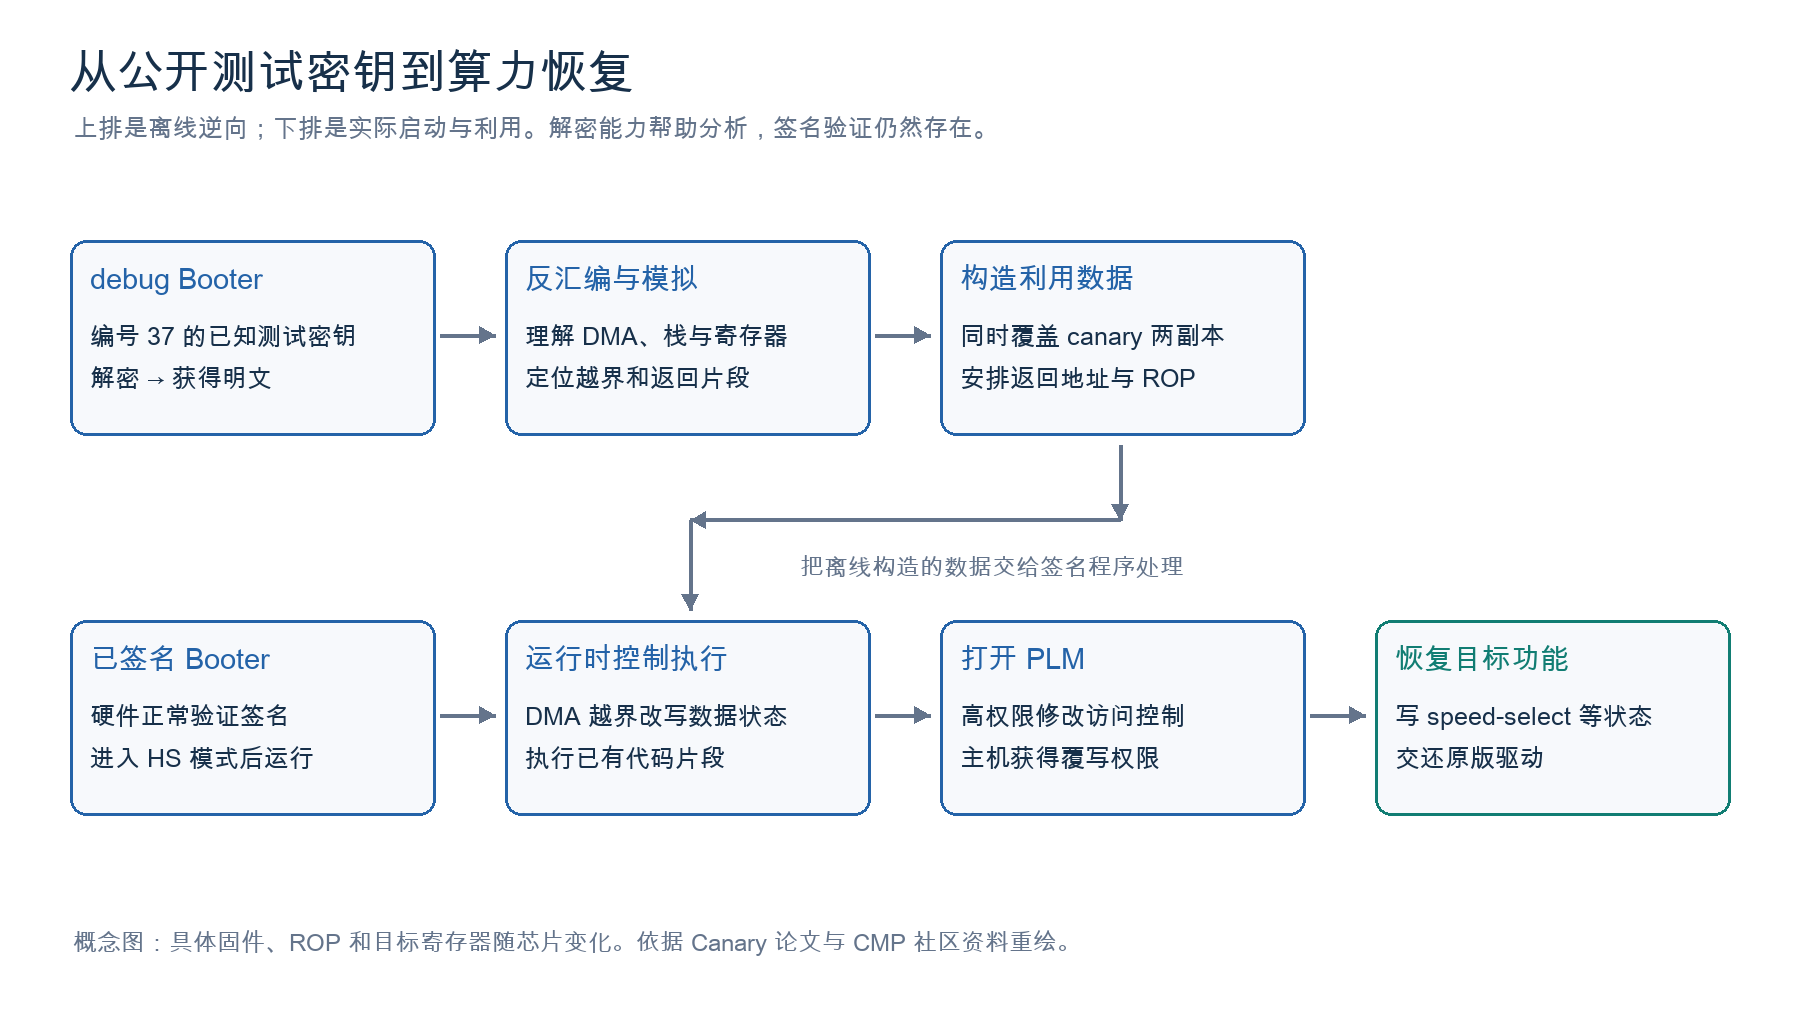
图 1:根据 Canary 论文和 CMP 社区资料重绘。上排是离线分析、准备利用数据,下排是在 GPU 上实际执行的过程。[1][3][4]
签名都通过了,canary 为什么还会失效
Booter 的漏洞出在签名数据的 DMA 拷贝上。程序把外部数据搬进一个固定大小的缓冲区,长度却取自主机可控的元数据,而且没有做边界检查。数据一长,就会越过缓冲区,覆盖后面的可写内存和栈。[1,第 5 节]
普通的栈溢出会被 canary 拦下:函数入口把一个参考值复制到栈上,返回前比较栈上的副本和参考值,溢出改了副本,比较就会失败。
问题在于这个固件的内存布局:master canary 也放在可写数据区里,而且和栈上的副本一样落在溢出范围内。一次溢出就能把两者同时改成同一个值 $V$,函数返回前的检查照样通过:
\[\text{saved\_canary}=\text{master\_canary}=V.\]检查一过,函数就跳到利用程序布置好的返回地址。攻击者根本不用猜原来的随机 canary 是多少——参考值本身都能改,随机性再强也没用。
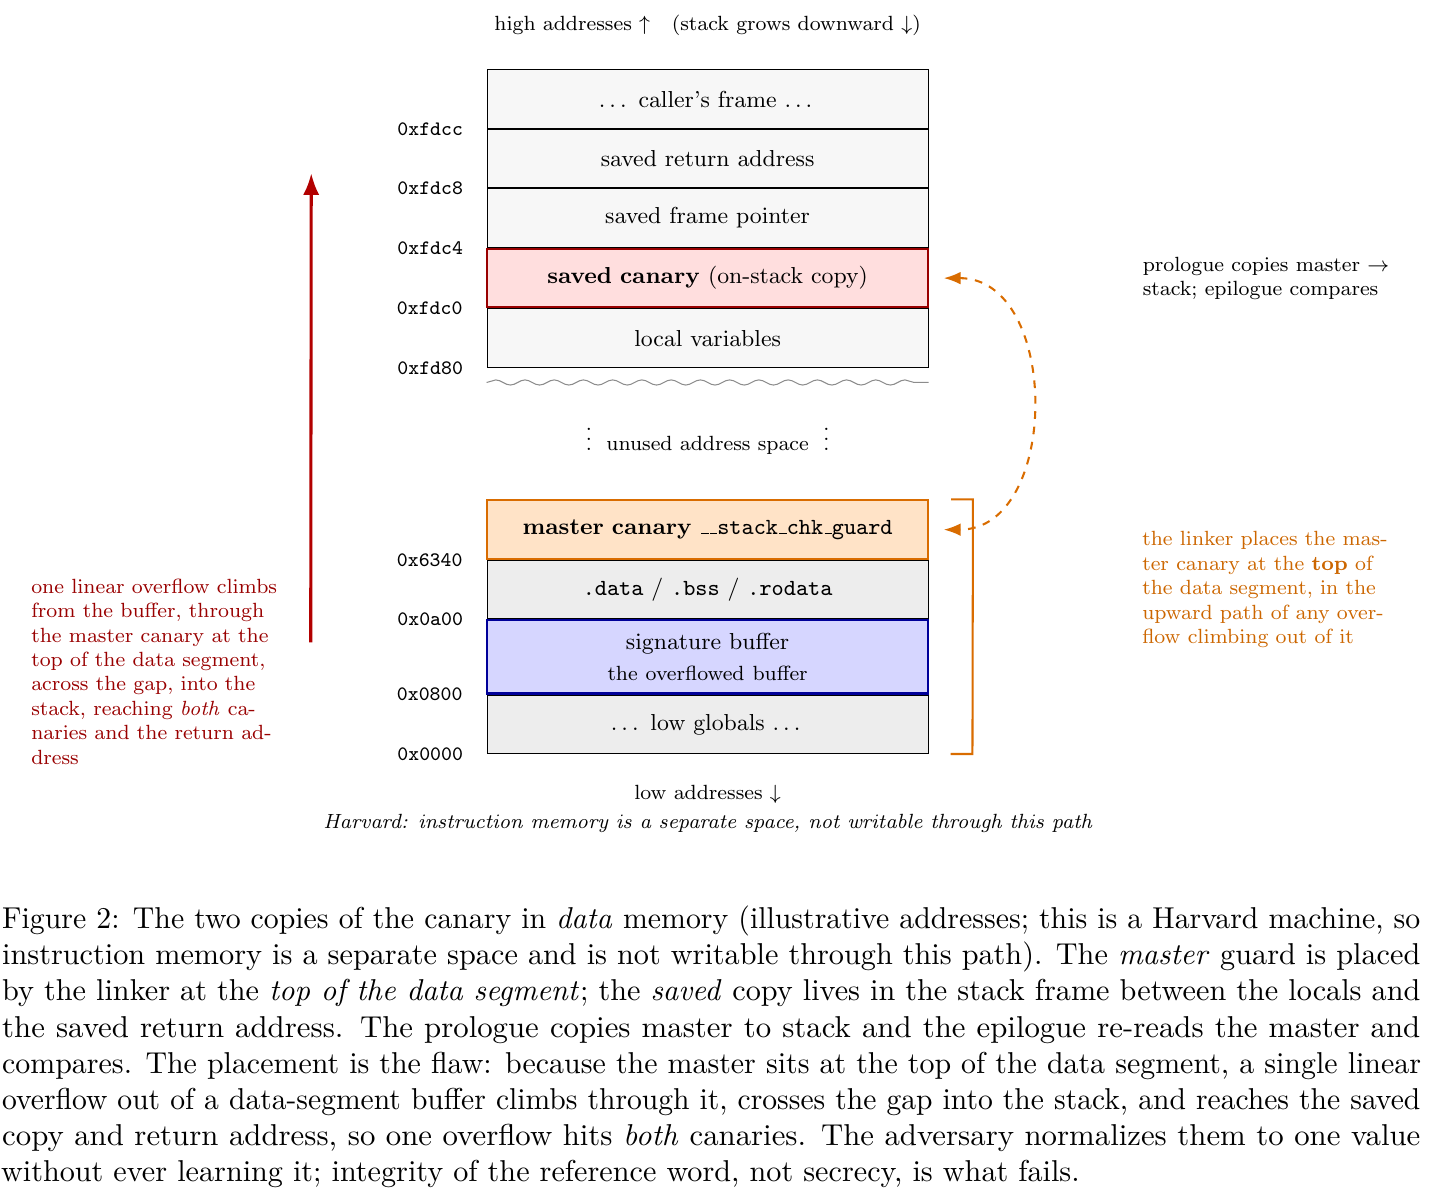
图 2:Canary 论文 Figure 2,PDF 第 6 页。参考值位于溢出可以到达的可写内存中。图片保留原图注。[1]
论文给出了一组分析用的地址:签名缓冲区起始于 0x800,参考值在 0x6340,两者相差:
有了这个偏移,输入长度和故障现象就能一一对上:覆盖范围还没到参考值时,启动可能照常进行;刚覆盖到参考值,canary 检查就会报错;如果把参考值、副本和返回地址都按需要布置好,控制流就会转进已有的代码片段。
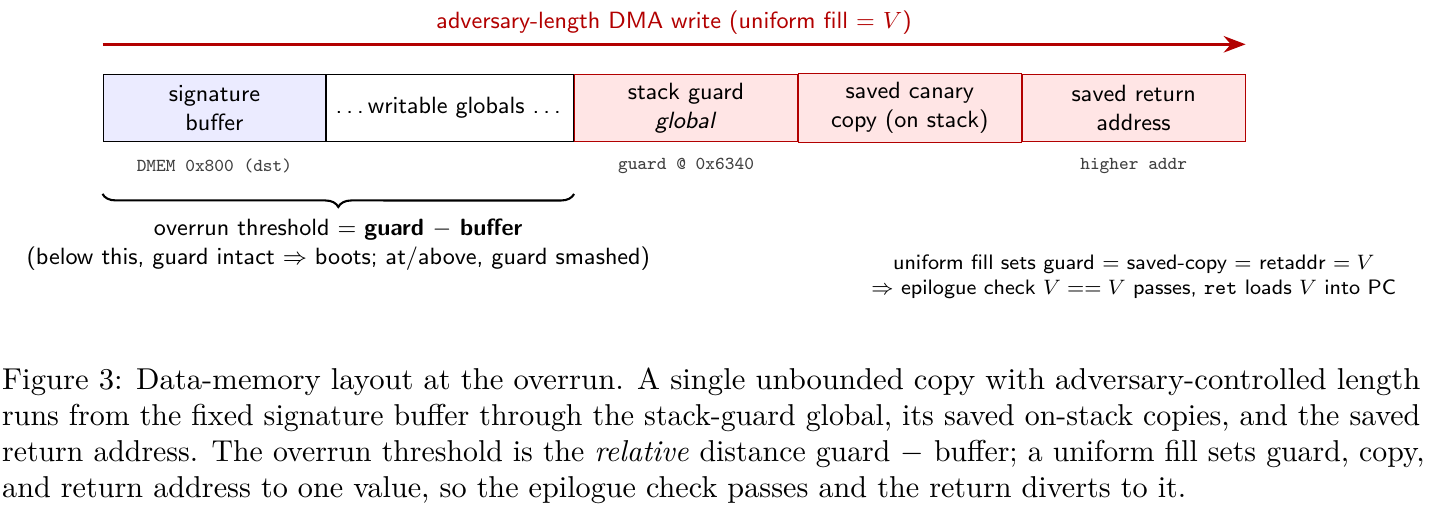
图 3:Canary 论文 Figure 3,PDF 第 7 页,展示两份值为何能被同时改写。[1]
接下来,研究者用 ROP(Return-Oriented Programming,返回导向编程)把已有的指令片段串起来。执行的始终是 NVIDIA 签过名的代码,被改变的只是运行时数据和执行顺序。
调试也是个难题:进入 HS(Heavy Secure,高安全)模式后,主机读不到处理器内部的指令和数据状态。作者为此写了一个 Falcon 模拟器,离线重放执行过程,再用硬件 mailbox 这类有限的反馈来对账。好在目标的执行是确定性的,溢出后的状态才能被精确构造出来。[1,第 3 节和第 5 节]
拿到 HS 执行权后,打开 PLM
PLM(Privilege Level Mask,特权级掩码)控制着受保护寄存器的访问权限。主机能读某个寄存器,不代表写进去会生效;但高权限固件可以改 PLM,给主机放开写权限。[1][5]
这样一来,一次能力有限的固件利用就能撬动很多东西:只要用它改一下访问控制,剩下的功能配置都交给主机去写。Ampere 的 V67 就是这么做的:用一次 4 字节的高权限写打开相关 PLM,然后由主机写入 speed-select 寄存器。
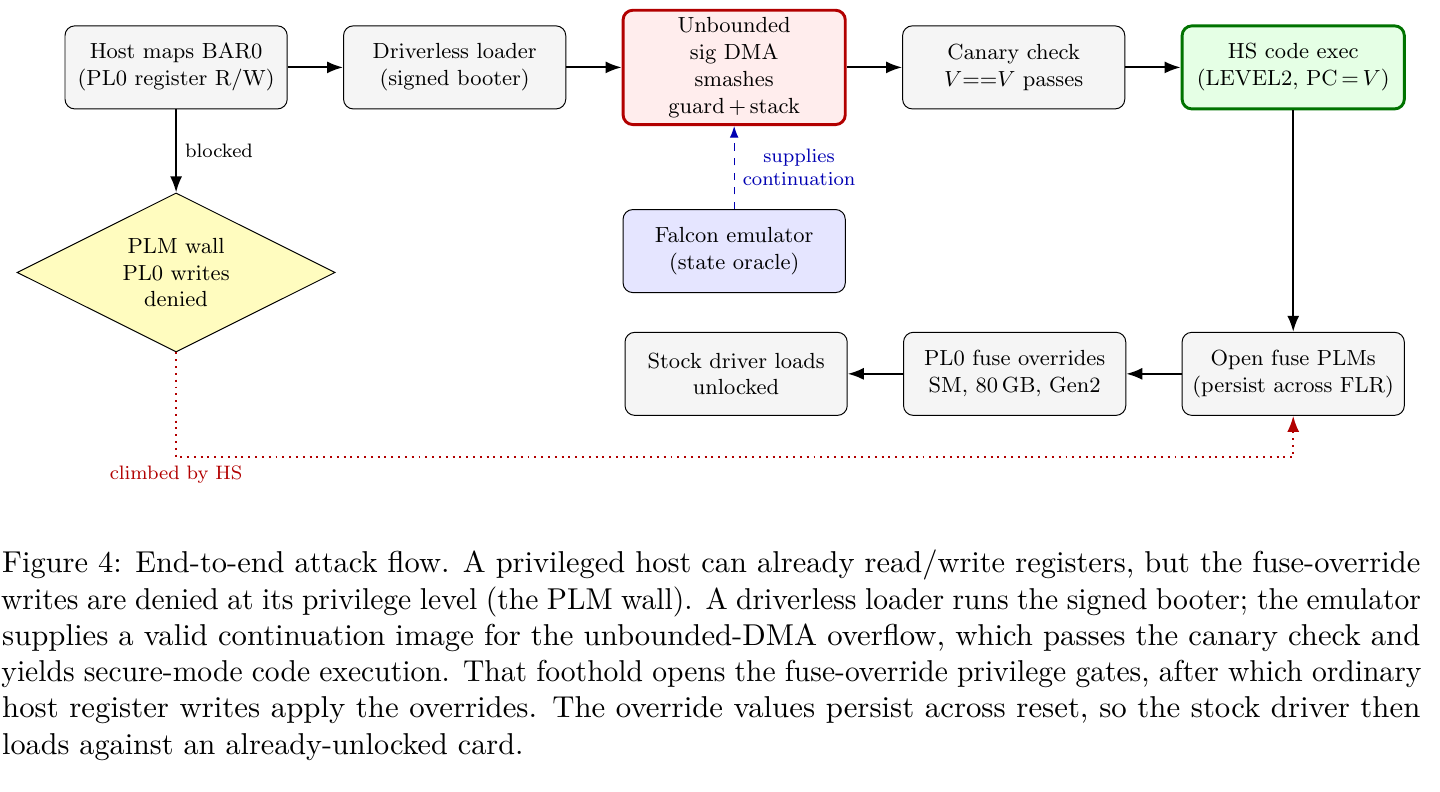
图 4:Canary 论文 Figure 4,PDF 第 9 页。从主机映射 BAR0,到 HS 执行,再到开放覆写权限。[1]
论文在测试卡上恢复了以下能力:
| 项目 | 报告结果 | 备注 |
|---|---|---|
| FP32 SGEMM | 约为原来的 31 倍,达到约 12.2 TFLOPS | 单卡测试结果 |
| FP64 计算 | 部分路径约为原来的 59~62 倍 | 不同 FP64 路径提升幅度不同 |
| TF32 Tensor | 约为原来的 15 倍,达到约 94 TFLOPS | 工具估算的吞吐 |
| 显存寻址容量 | 10 GB → 80 GB | 容量确实存在,但满容量运行需额外处理稳定性 |
| PCIe 速率 | Gen1 → Gen2 | 尚未找到通往 Gen3 的路径 |
80 GB 这一项要结合稳定性来看。作者用哈希写读确认了物理容量确实存在,但在原有刷新配置下做压力测试,出现了 2796 个错误;同一张卡只用 40 GB 时则能通过。提高刷新频率后,80 GB 的测试做到了 0 错误,代价是吞吐从约 94.6 TFLOPS 降到 64.6 TFLOPS,掉了约 32%。[1,第 6.3 节]
也就是说,软件能放开寻址范围,但改变不了显存颗粒本身的质量和时序余量。cmpunlocker 的默认配置也比论文实验保守:8 GB 的卡配到 64 GB,10 GB 的卡配到 40 GB。[6]
PCIe 位宽又是另一类限制。论文里那张卡要从 ×4 恢复到 ×16,得在板上补焊 24 个缺失的 AC 耦合电容。寄存器改得了配置,补不上板上缺的元件。
另外,部分 override 位于常供电的状态域,FLR 或重载驱动后依然保留,但彻底断电就会清掉,解锁随之失效。后来的项目改成每次开机自动重跑一遍,日常使用就方便了。[1,第 10 节]
从矿卡研究到 RTX 20、30、40 系
CMP 170HX 的研究给出了一套通用思路:解密固件读懂实现,利用签名程序的内存安全漏洞拿到权限,再改功能或速率配置。其中 CMP 90HX 的 GA102 实现,后来成了 RTX 30 系解锁的重要来源。
不过每一代显卡都有各自的上游工作:Turing 的实现和 Ampere 不同,Ada 也得有自己的 Booter、payload 和权限处理。下面按架构分代介绍,并不意味着这些项目都是从同一份代码派生出来的。
RTX 20 系:Turing 用自己的固件和板卡配置
KohakUnlock 的 2080 Ti 实现跑在 Linux initramfs 里,赶在 NVIDIA 驱动绑定之前执行。它基于 Turing-unlock、cmp50hx-unlock 和 CMP40HX 的相关研究,需要用到从原厂 ROM 中提取的 FWSEC,以及对应 TU102 的固件和配置。[7][8]
移植真正的工作量在这里:先核对芯片、ROM 和固件,再编排启动流程。只把另一张卡的 PCI ID 加进白名单,并不能保证那套固件和地址在新卡上还成立。
项目报告的同卡数据是:FP16 输入、FP32 累加的指令吞吐从 59.9 TFLOPS 提到 111.0 TFLOPS,提升约 85.3%;作为对照的 FP16 累加从 119.5 TFLOPS 变为 118.5 TFLOPS,基本没变。测试卡的 22 GB 显存是之前物理改装的结果,原卡是 11 GB。[7]
RTX 30 系:从 CMP 90HX 的 V67 到独立内核模块
CMP 90HX 用的是 GA102,和部分 RTX 30 系同源。WildFlash1st 把 V67 塞进了 NVIDIA Open 610.43.03 的初始化流程:等 GFW 启动完成,执行利用、写速率配置,然后复位,再重新走正常初始化。[9]
Zagitta 的 gpu-unlock 把这部分拆成了独立内核模块。它在 initramfs 阶段先接管显卡完成解锁,再交给原版 NVIDIA 驱动。这样驱动升级时,用户就不用再跟着维护一份驱动补丁了。[10]
根据 Ampere 的分析文档,相关寄存器配置如下:
| 寄存器 | 地址 | 目标状态 |
|---|---|---|
FEAT_OVR_PLM |
0x00823804 |
从 0xffffff8f 改为 0xffffffff |
FEAT_OVR_SM_SPD,SS0 |
0x0082381c |
0x88888888 |
FEAT_OVR_SM_SPD_1,SS1 |
0x00823820 |
0x8 |
SS0 由 8 个 4 位字段组成,SS1 的低 4 位是另一个字段。每个字段的 bit 3 是覆写使能,低 3 位选择速率,0 表示全速,所以 0x8 就是”开启覆写、选全速”。流程上,V67 先改 PLM,主机再写 SS0 和 SS1。[4]
除此之外,模块还要处理固件加载、DMA 缓冲区管理、恢复原签名引用,以及 FLR(Function Level Reset,功能级复位)等步骤,确认交接状态无误后,才把显卡交给原版驱动。注意,解锁用的固件仍然绑定特定版本,只是最终跑的正式驱动不用再打补丁。
要解锁哪张卡需要显式指定,比如通过模块参数传入 PCI 地址:
gpu_unlock.targets=0000:21:00.0
这个参数只负责选卡,固件校验、加载顺序和板卡适配都由具体实现处理。
RTX 40 系:目标相同,但需要 Ada 专用的利用程序
Ada 的项目同样是改 Tensor 速率,但必须用对应芯片的 Booter 和 payload。已有分析记录过一个失败案例:GA102 的 Booter 在 AD102 上打不开 FEAT 权限。Ada 上还要额外处理 WPR_CFG、WPR 和 FEAT 等权限状态。[11]
JustAResearcher 的 Linux 模块集成了 Ada 的 payload。KohakUnlock 另外做了 4090 的 Windows UEFI 版本,在 Windows Boot Manager 之前运行,解锁后直接交给原版 Windows 驱动。[11][12]
Windows 和 Linux 方案的区别主要在于:由谁提供 PCI 访问、内存分配、显示交接和启动控制。固件利用、速率配置和状态验证这几步,哪个平台都省不掉。
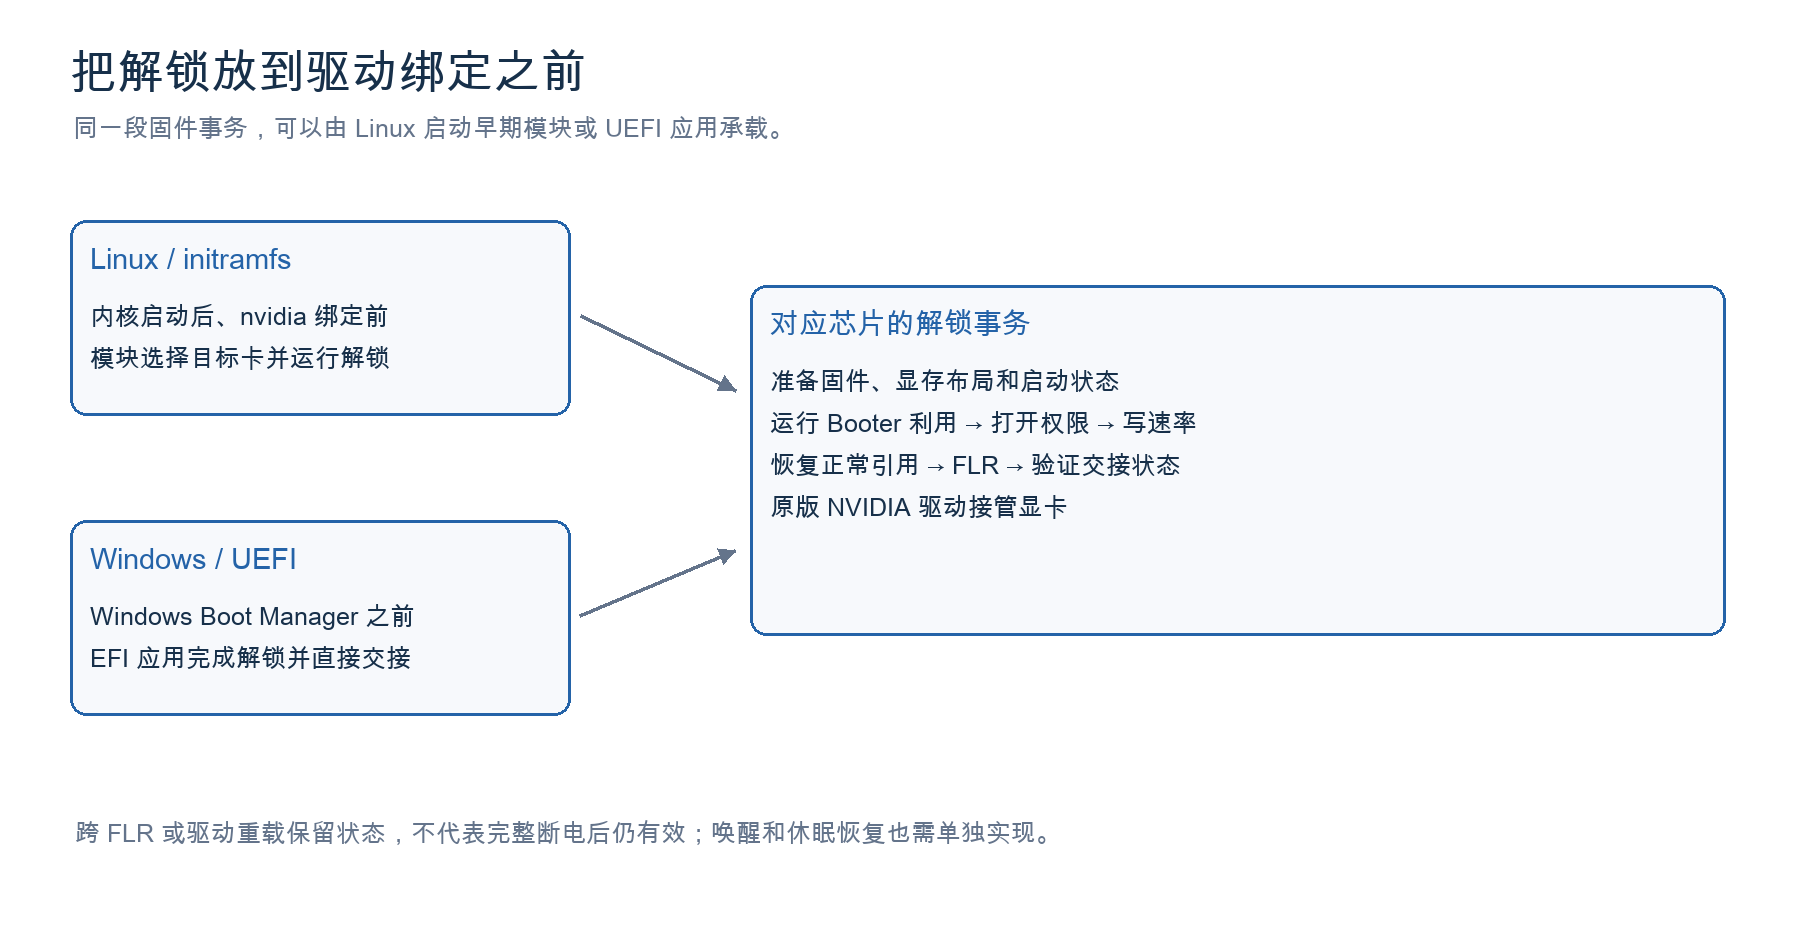
图 5:根据项目实现重绘。两种方式都提前运行解锁事务,具体固件和复位顺序取决于芯片。[8][10][12]
截至本文核对时,RTX 20、30、40 系都有实测项目,但每个项目只覆盖特定的芯片和板卡组合。Blackwell 还没有人公开走通整套利用流程。
指令快了,应用能快多少
GeForce 上的解锁,改的主要是特定 Tensor 指令的发射速率。要注意输入是 FP16 或 BF16,累加未必也是同样的精度。训练和常见矩阵算子大多是低精度输入、FP32 累加,解锁提升的正是这一类。
用矩阵乘加来表示:
\[D=AB+C.\]矩阵的存储类型、乘法输入类型和累加类型要分开看。普通 FP32 CUDA Core 运算、整数指令和其他 Tensor 格式,也都得单独测。
Zagitta 公布的 RTX 3090 Ti 实测 GEMM 数据,能很好地说明不同精度收益的差别:
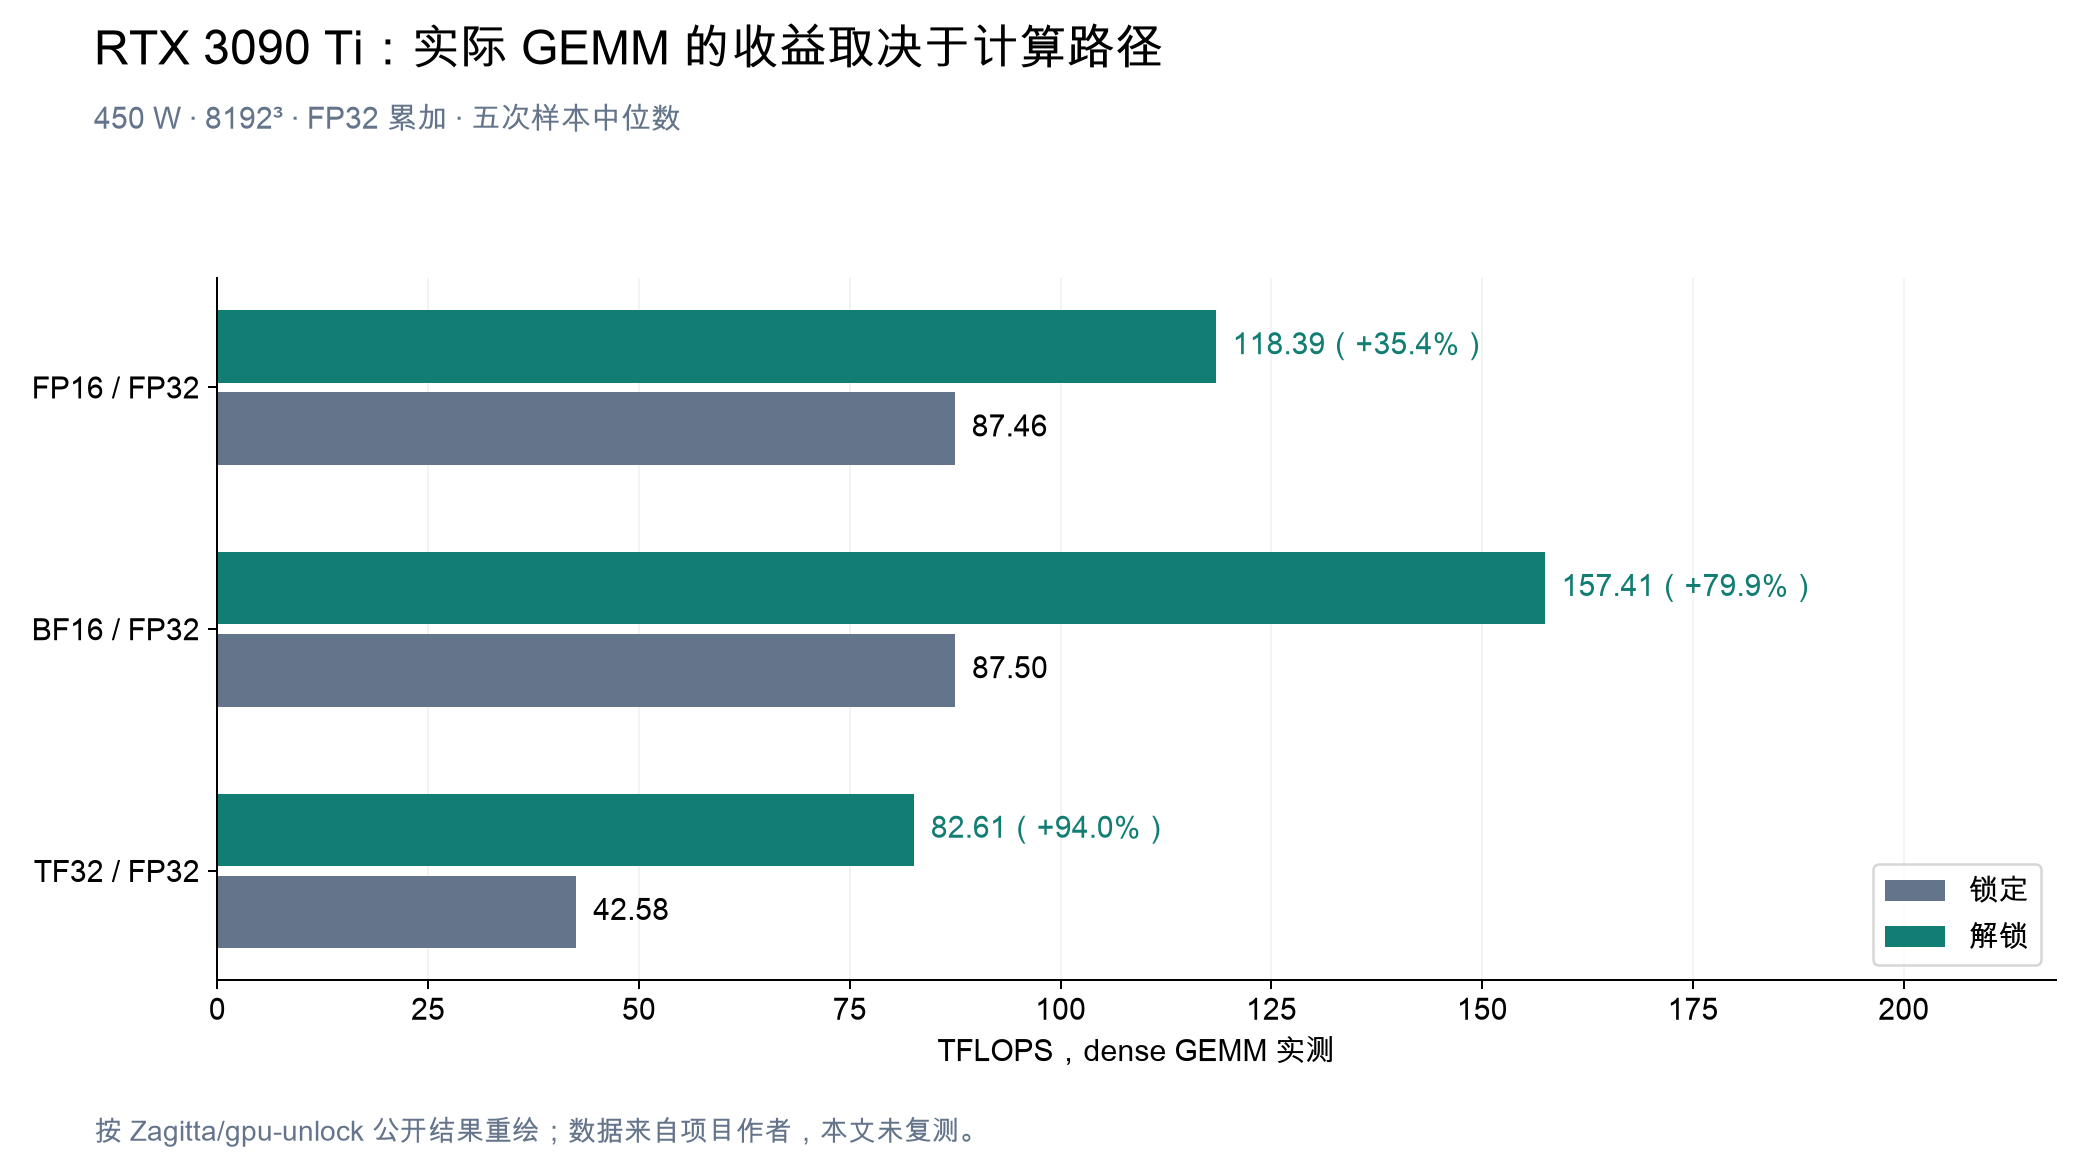
图 6:按项目公开结果重绘。450 W、8192³ 稠密 GEMM、FP32 累加,取 5 次样本的中位数。[10]
同一张卡上,FP16 提升约 35.4%,BF16 约 79.9%,TF32 约 94.0%。几种精度的指令发射上限提升幅度差不多,但实际 GEMM 还受访存、功耗和 kernel 实现的制约。
Ada 上也是类似的情况。一组 4090 同卡测试中,FP16/FP32 的指令吞吐差不多翻了一倍,实际 cuBLAS GEMM 却只快了 12%~34%;BF16 在部分形状上提升约 16%~20%,4096³ 基本没变。[11]
落到整个模型上,收益还要看这类算子占多大比重。假设原本耗时中占比为 $p$ 的部分提速到 2 倍,其余不变,理想的整体加速比为:
\[S=\frac{1}{(1-p)+p/2}.\]$p=0.5$ 时,整体只快约 1.33 倍。如果瓶颈在搬运权重和 KV cache,提高计算发射速率的收益还会更小。量化模型最终用的是哪种 kernel,也会改变受影响部分的比例。
做微基准时还要当心全零输入。KohakUnlock 的作者在检查某个构建时发现,编译器把相同 tile 的计算合并掉了,主机却仍按完整工作量统计 FLOPs,结果自然虚高。所以项目改用运行时生成的随机输入,并保证解锁前后跑的是同一份测试二进制。核对指令吞吐时,要同时检查输入分布和实际执行的指令数。[12]
RTX 50 系还差什么
截至 2026-10-27,公开的 gpu-unlock-blackwell 还停留在测量和移植研究阶段。项目说明写明,目前既没有公开的 GB20x Booter payload,也没有完成解锁移植。所以针对 RTX 5090,现在还拿不出像 Ampere、Ada 那样可复现的现成方案。[13]
回顾前面的流程,旧方案至少要具备四样东西:能分析的固件、可用的漏洞和代码片段、正确的目标寄存器,以及完整的启动交接。而 ROP 用到的地址和具体 Booter 镜像绑定,固件布局和权限状态又随芯片变化。
Blackwell 项目把缺少公开 debug Booter 列为障碍之一。驱动绑定前的那套模块框架可以复用,但最关键的利用数据得从头研究。也就是说,这一代卡在”怎样可靠地拿到执行权”这一步,还远没到把旧 payload 改改型号就能用的程度。[13]
已有测量显示,原厂状态下 5090 的 FP16/FP32 和 FP16/FP16 吞吐确实有差距。但测出速率差异,只说明这两条路径被区别对待了;要真正解锁,还得把上面的利用流程走通。将来能不能找到新的突破口,目前的材料还给不出答案。
RTX 5090 与 RTX PRO 6000 的差别
50 系虽然暂时解锁不了,但这不妨碍对比它和专业卡的规格差异。这里比较 RTX 5090 与 RTX PRO 6000 Blackwell 的 Max-Q 版和 Workstation 版,不涉及 Server Edition。
三者都是 GB202 芯片,但启用的资源、显存和功耗配置不同。官方白皮书列出的主要参数如下:[14][15]
| 项目 | RTX 5090 | PRO 6000 Max-Q | PRO 6000 Workstation |
|---|---|---|---|
| SM 数 | 170 | 188 | 188 |
| Boost 频率 | 2407 MHz | 2280 MHz | 2617 MHz |
| 显存 | 32 GB GDDR7 | 96 GB GDDR7 | 96 GB GDDR7 |
| L2 缓存 | 96 MiB | 128 MiB | 128 MiB |
| 显存位宽 | 512 bit | 512 bit | 512 bit |
| 显存带宽 | 1792 GB/s | 1792 GB/s | 1792 GB/s |
| 整卡功耗规格 | 575 W | 300 W | 600 W |
真正拉开 Tensor 性能差距的是累加精度。下面的数据都是官方 boost 频率下的理论稠密峰值,不含稀疏加速。
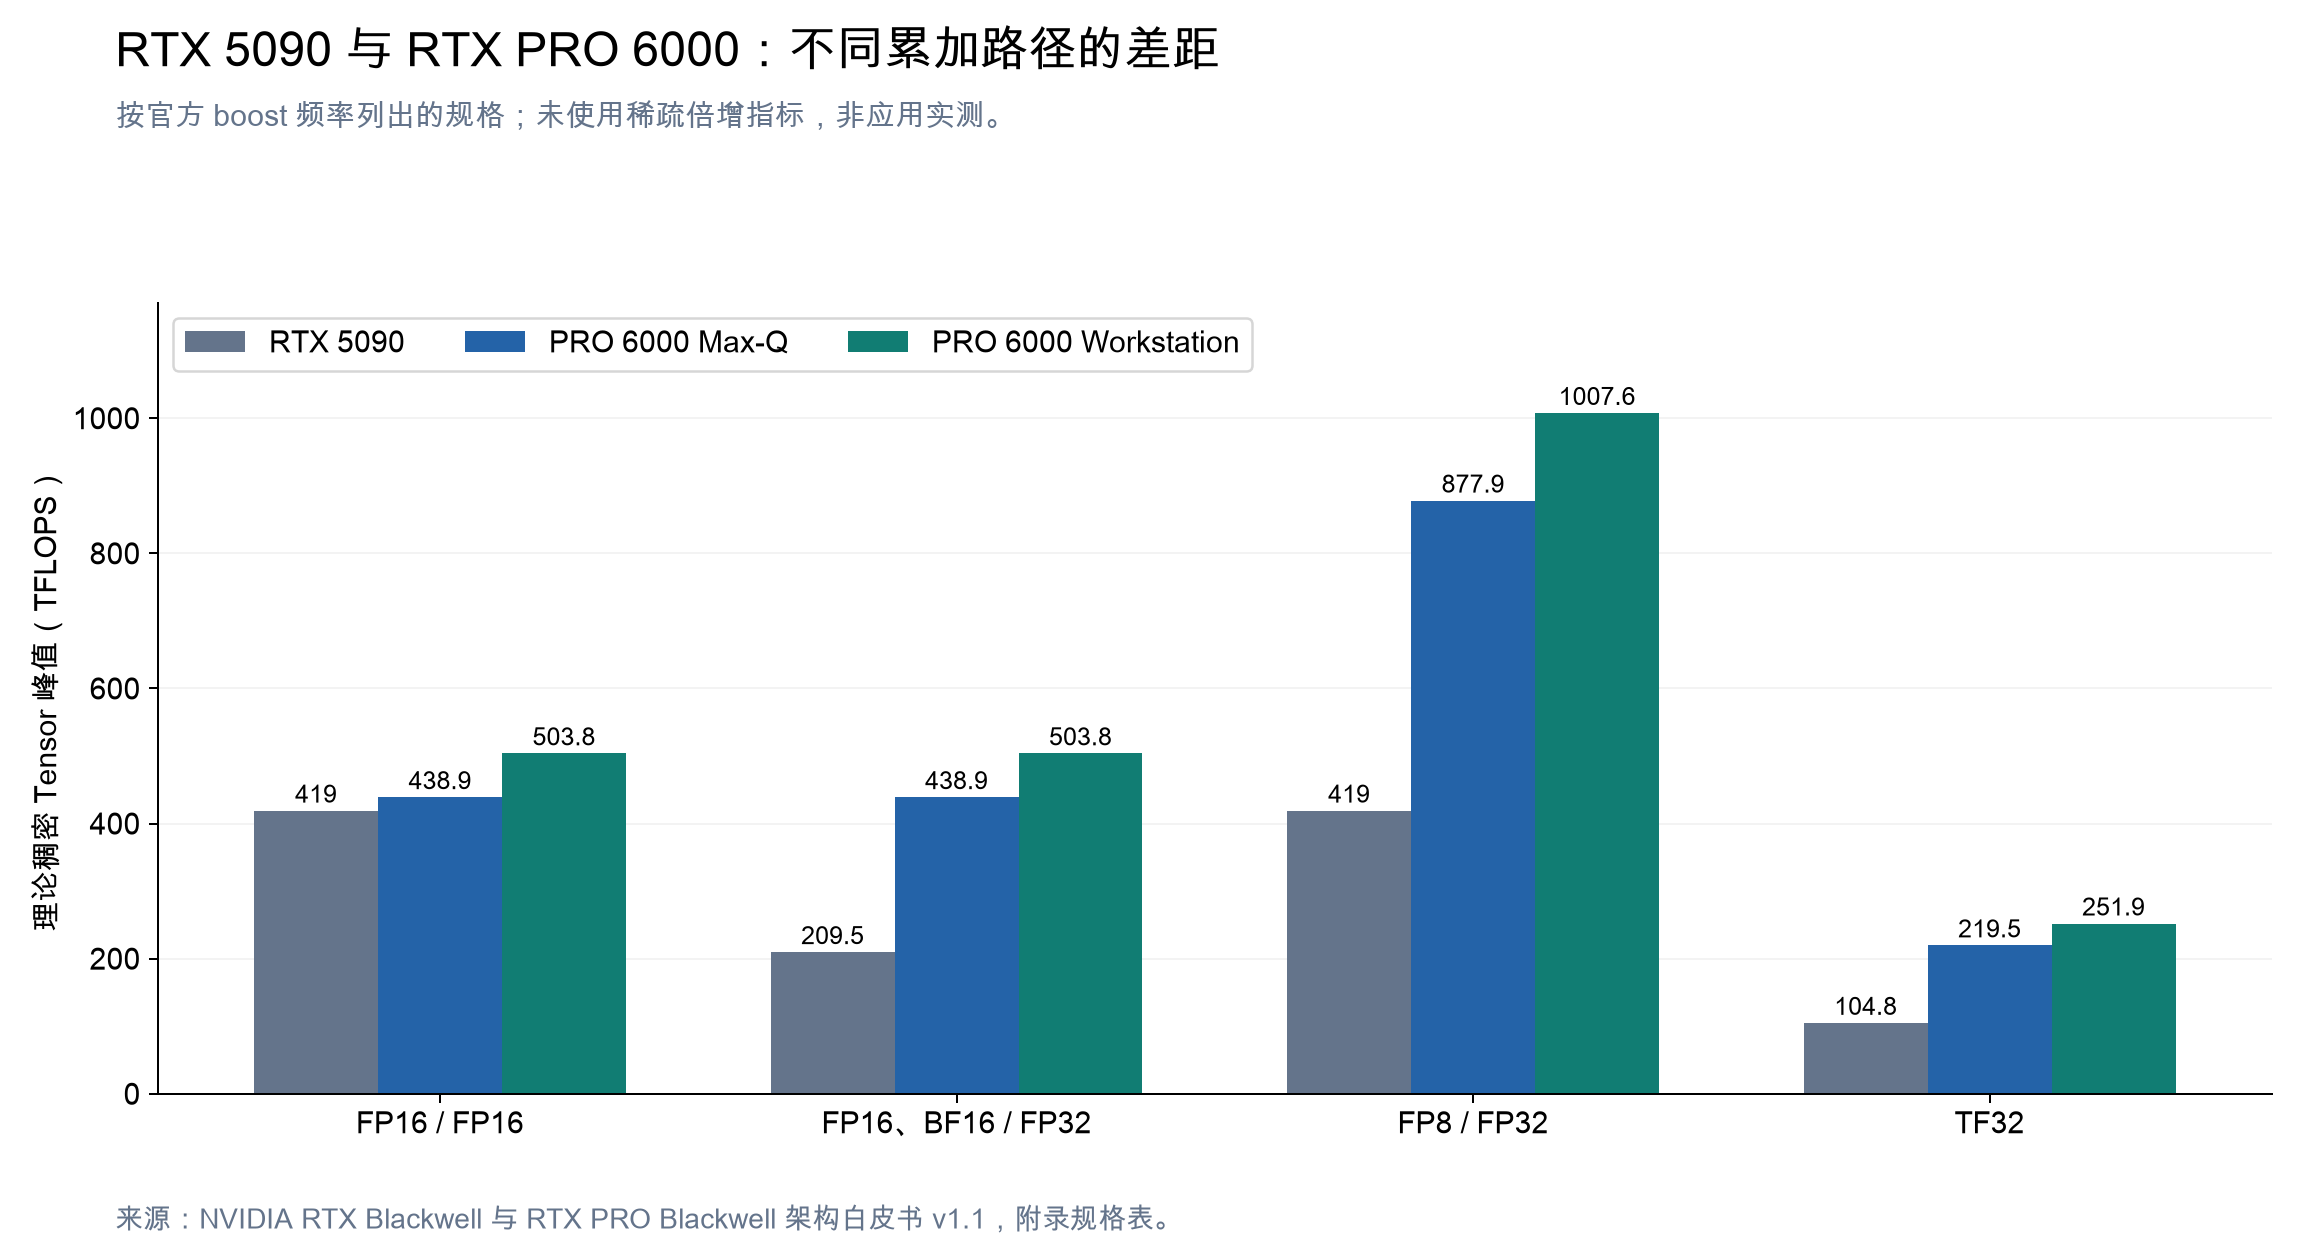
图 7:按 NVIDIA 两份 Blackwell 白皮书的附录规格重绘。每组只比较一种输入与累加组合,均为理论规格,不是应用实测。[14][15]
FP16 输入、FP16 累加时,5090 为 419 TFLOPS,PRO 6000 Workstation 为 503.8 TFLOPS,相差约 1.20 倍,正好等于 SM 数和 boost 频率的比值:
\[\frac{188\times2617}{170\times2407}\approx1.20.\]换成 FP32 累加,5090 的 FP16/BF16 峰值降到 209.5 TFLOPS,Workstation 仍是 503.8 TFLOPS,差距拉大到约 2.40 倍。FP8/FP32 和 TF32 也是同样的规律。
Max-Q 版更能说明问题。它的整卡功耗只有 300 W,FP16/BF16 输入、FP32 累加的峰值却有 438.9 TFLOPS,是 5090 的约 2.10 倍。可见这类 Tensor 路径的差距,靠 SM 数、频率或功耗都解释不了。
专业卡的优势还在于显存容量和资源隔离。96 GB 显存能装下更大的模型和缓存;白皮书还列出了 MIG(Multi-Instance GPU,多实例 GPU)配置,PRO 6000 可以切成 2 个 48 GB 或 4 个 24 GB 的实例。[15] 所以就算将来 5090 某条 Tensor 路径的速率被恢复,选卡时仍要结合它自身的显存、缓存和功耗来评估。
ECC 值得单独提一下。v1.1 白皮书明确写到,用 GDDR7 的 GeForce RTX 也带有始终开启的 DRAM 片内单比特纠错;专业卡则额外列出了面向 RAS 的增强 CRC 支持。[15] 所以”专业卡有 ECC、消费卡没有”的说法并不准确,片内纠错、传输保护和软件可见的 ECC 功能是不同层面的东西。
至于 MXFP8 和 NVFP4,得具体看指令和缩放模式,不能简单套用”FP32 累加”的结论来推断它们和普通 FP8/FP32 的速率关系。硬件路径、软件库和实际模型各自的限制,可以接着看前置阅读里关于 SM120 和 MXFP8 的两篇文章。
参考
[1] Jon Pry,A Canary in the Crypto Mine: Defeating Stack Protection in a GPU Secure Coprocessor,2026,预印本。Zenodo,DOI: 10.5281/zenodo.20916112。机制和图表核对自 Zotero 保存的 16 页 PDF;该论文未提供 arXiv 版本。
[2] Xing Kangwei,Exploration of Cryptocurrency Mining-Specific GPUs in AI Applications: A Case Study of CMP 170HX,2025。arXiv:2505.03782。讨论应用侧避开受限指令的早期方法。
[3] Consensus-Protocol,The SEC2 Falcon and the Booter Load Microcode,2026,重点见第 5.2 节的 debug 测试密钥与明文分析。
[4] Zagitta,How Nvidia Ampere Generation GPUs Got Unlocked,2026。说明编号 37 的测试密钥、V67 和速率寄存器。
[5] Consensus-Protocol,Privilege Level Masks,2026。PLM 的字段解释来自社区行为分析,具体编号应结合对应处理器理解。
[6] amoghmunikote,cmpunlocker,2026,CMP 170HX 默认容量配置。
[7] KohakuBlueleaf,KohakUnlock,2026。2080 Ti 指令测试为同卡比较;MAMF 数据另有跨卡条件。
[8] KohakuBlueleaf,Reproducing the 2080 Ti Experiment,2026。说明 TU102 原生固件、配置与 initramfs 实现。
[9] WildFlash1st,cmp90hx-unlock,2026,rejoin15 与 NVIDIA Open 610.43.03 实现。
[10] Zagitta,gpu-unlock,2026,独立模块及 RTX 3090 Ti GEMM 数据。
[11] JustAResearcher,gpu-unlock-ada,2026,Ada 移植与同卡 GEMM 对照。
[12] KohakuBlueleaf,RTX 4090 Windows / UEFI,2026,UEFI 交接、随机输入微基准与全零输入问题。
[13] phiraml,gpu-unlock-blackwell,2026,访问日期 2026-10-27。
[14] NVIDIA,NVIDIA RTX Blackwell GPU Architecture,v1.1,2025。官方白皮书,附录 A、表 3。
[15] NVIDIA,NVIDIA RTX PRO Blackwell GPU Architecture,v1.1,2025。官方白皮书,附录 A、表 4;第 12 页补充 GDDR7 片内 ECC,第 44~45 页说明 MIG 配置。表内 KB 按 1024 B 换算为 MiB。