前置阅读:高带宽闪存 HBF:会给推理带来什么样的变化 · 硅谷为何渴求算力:从 Agent 需求到 2027 年供给周期 · Intel 傲腾:从 3D XPoint 到持久内存
本文基于 Asianometry 的视频《SK hynix and the HBM Revolution》整理(2026-08-13 发布,38 分 16 秒),技术规格、交易条款和投资数字按 SK 海力士、JEDEC、AMD、NVIDIA、SEC 的一手资料核对过。文中截图均来自该视频,图注末尾标出对应画面在视频中的时间区间。
2026 年 7 月,SK 海力士在纳斯达克挂牌 ADR,发行总额约 265 亿美元,是美国资本市场史上规模最大的 ADR 上市。二十五年前,这家公司还在债权人手里,董事会刚刚否决了把存储业务整体卖给 Micron 的方案。
从那时到现在,中间隔着三次大的财务危机、一次控股权易手、一款卖不动的旗舰显卡、一代因为良率只有一半而延误一年半的 HBM2,以及一项从零开始和日本供应商一起做出来的封装工艺 MR-MUF。等到 2022 年 11 月 30 日 ChatGPT 上线,市面上能给 NVIDIA 稳定供应 HBM3 的只有它一家。
视频封面:SK hynix and the HBM Revolution。
这个故事可以拆成四层,后文也按这个顺序展开:
- 财务与组织:海力士先得扛过 DRAM 的价格周期,并找到一个愿意长期投钱的股东。SK 在 2012 年的收购解决了这件事。
- 架构:HBM 用”很宽、很短”的接口换带宽和能效,这是它对 GPU 有价值的根本原因。
- 制造:HBM2 的失败和 MR-MUF 的成功说明,HBM 的胜负手在封装:能不能把八层、十二层薄裸片稳定地叠起来、连通、填满、通过客户认证。
- 系统与市场:HBM 是和 GPU 一起设计、一起验证的定制件。客户换供应商的成本很高,AI 需求爆发时,提前准备好的那一家吃下了几乎全部红利。
债务与 DRAM 周期        客户共同设计          封装与认证            AI 需求与扩产
需要稳定的长期投入  ──▶  形成 HBM 架构   ──▶  形成量产能力   ──▶  兑现长期投入
 (1999–2012)          (2006–2015)          (2015–2021)          (2022–2026)
一、为什么海力士必须改变:规模、债务与周期
视频 00:34–14:55
1999:合并换来了规模,也背上了债
1997 年亚洲金融危机之后,韩国政府推动了一轮叫作 “Big Deal” 的产业重组:把不同财阀里重复的业务合并,减少重复投资,造出能在国际上竞争的大公司。半导体是其中一项。1998 年现代和 LG 开始谈半导体整合,1999 年 5 月签署最终协议:现代电子以 2.56 万亿韩元收购 LG 集团持有的 59% LG Semicon 股份,其中 1 万亿韩元用分期票据支付 [2]。
合并之后,现代电子的 DRAM 份额和产能接近三星,可以和 Micron、日本厂商正面竞争。代价是资产负债表:视频给出的数字是,现代电子当时的债务约 130–140 亿美元。2000 年它还有约 15 亿美元营业利润,但融资成本和资产减值把净利润打成约 20 亿美元的亏损;2001 年又有约 31 亿美元债务到期。
这组数字说明了一个关键区别:工厂能赚钱,和公司能还得起债,是两回事。 营业利润衡量的是造芯片、卖芯片这门生意;净利润还要扣掉利息和减值;而到期债务要的是现金。
紧接着,互联网和电信泡沫在 2000 年下半年破裂。此前各家扩建的产能刚好在需求下滑时释放出来,部分 DRAM 的售价跌到了制造成本以下。半导体占现代电子收入的 80% 左右,没有别的业务能缓冲。
商品 DRAM 的周期是这样放大风险的:景气时各家同时扩产,新厂要一两年才能形成供给;等产能真正释放,需求往往已经转弱,价格和现金流一起下跌。对高负债的企业来说,建设期的资本开支、下行期的售价和债务到期时点三者错位,规模越大,下行期需要的现金越多。
用一条因果链概括:
政策推动合并 → 产能与份额增加,同时承接融资负担 → 需求转弱、价格下跌 → 经营收益盖不住财务成本与到期债务 → 出售资产、寻求融资、接受债权人重组
2001 年 3 月,现代电子更名为 Hynix(取 high/hi 加 electronics),同时剥离非核心业务、脱离现代集团 [3]。改名解决不了债务,同年 10 月,以韩国外换银行为首的债权人接管了公司,开始全面重组。
2002:董事会为什么否决 Micron 的方案
债权人控制下,Micron 提出收购海力士的存储业务。2002 年 4 月 22 日双方签署了非约束性 MOU,条款是 [4]:
- Micron 以约 1.086 亿股 Micron 普通股,换取海力士的存储业务;
- Micron 另投 2 亿美元,取得剩下的非存储业务 15% 股份;
- 韩国贷款机构为 Micron 的韩国业务提供 15 亿美元长期融资。
对债权人来说,卖掉最值钱的资产能回收资金。但对公司来说,存储业务是收入主力,卖掉之后剩下的非存储业务还要背着大量债务,现金流从哪来?
4 月 30 日,海力士董事会一致否决了这份 MOU。董事会声明给出的理由很具体:方案高估了 Micron 股票的价值,对或有负债和剩余企业现金流的假设过于乐观,把太多负担压在了剩余企业身上;同时,技术改进和市场回升让公司有机会独立经营下去 [5]。视频还提到了韩国国内舆论的强烈反对,以及参与谈判的管理层最终也投了反对票。
视频作者认为 Micron 的真实意图是关掉韩国工厂、消灭一个竞争者。这是作者对买方动机的推测,公开的交易条款里看不出来,条款里甚至还有给 Micron 韩国业务的长期融资安排。真正能从公告里读出的分歧是:债权人要的是回收资金,董事会要的是公司持续经营。
2003–2008:靠工艺降本活下来,但逃不出周期
否决交易之后,海力士开始自救:
- 卖资产:2003 年把 TFT-LCD 业务卖给京东方,2004 年剥离系统 IC 业务(后来成为 MagnaChip)。
- 工艺降本:视频把 Blue Chip、Prime Chip、Golden Chip 说成是产品品牌或质量分级,这一点视频说错了。按海力士 2001 年的官方公告,Blue Chip 是一个工艺平台:用现有设备做到 0.15 μm 制程,缩小晶粒、提高每片晶圆的产出,从而少买新设备 [6]。Prime Chip 和 Golden Chip 分别对应 0.13 μm 和 0.10 μm。2003 年 Golden Chip 量产时,公司称每片晶圆的晶粒数比 0.13 μm 平台多约 40% [7]。在没钱买新设备的年代,这是把旧产线榨出更多芯片的办法。
- 布局 NAND 与中国:与意法半导体合作在无锡建厂。合资协议 2004 年 11 月公布,2005 年 4 月奠基,分阶段建设 8 英寸和 12 英寸线 [8]。
卖资产降债务、工艺改进降成本、市场回升抬售价,三者叠加,海力士在 2004–2005 年恢复盈利,部分债权人拿回了钱,韩国媒体称之为”奇迹”。
然后周期又来了。2006 年行情不错,行业普遍押注 Windows Vista 会带来新一轮 PC 换机潮。2007 年 7 月,海力士宣布未来三年每年新建一条 300 mm 晶圆线,目标是 2017 年成为全球最大的存储厂商。结果 Vista 没能拉动需求,DDR2 价格下跌,2008 年金融危机又把需求和融资渠道一起掐断。视频给出的数字是,海力士 2008 年净亏损约 34 亿美元。
这一段暴露的是标准化 DRAM 的结构性问题:扩产决策依据的是当时的需求预测,产能真正投入时市场已经变了;就算一家公司把单位成本做到最低,全行业同步扩产照样能把价格打下来。降本让你在下行期活得更久,但改变不了客户可以随时换供应商这个事实。
2009 年后需求恢复,但 2011 年官方财报显示:收入 10.396 万亿韩元,营业利润 3250 亿韩元,净亏损 560 亿韩元 [9]。又一次”经营赚钱、账面亏损”。
2012:SK 为什么敢接手,打算改变什么
SK 集团本身就是靠跨行业收购长大的。前身鲜京纺织创立于 1953 年,1980 年收购大韩石油公社进入炼油;1994 年以每股 33.5 万韩元(高于市价)买下韩国移动通信约 23% 股份,1996 年 1 月推出 CDMA 商用服务,这家公司后来成为 SK Telecom [10]。视频还提到崔钟贤与沙特的关系帮助 SK 拿到了稳定的原油供应和融资。每一次,SK 都是在一个产业的转折点买进新的增长业务。
崔泰源 1998 年接班。海力士的债权人出售控股权时,他决定再进半导体。集团内部的反对意见很直接:半导体和原有业务没什么协同,存储行业周期剧烈、投入巨大,海力士自己的记录反复无常,2011 年还在亏。
崔泰源的判断有三层:
- 供给结构在集中:奇梦达已经退出,尔必达财务困难,能持续投资 DRAM 的厂商只剩几家,活下来的会处在更有利的位置。
- 需求结构在变化:iPhone 和 Android 带来了 PC 之外的存储需求,客户结构更分散,单一市场的冲击会被稀释。
- 经营方式:他四处请教业内人士,形成长期战略,而不是只看资产便宜。
视频引用《Super Momentum》一书中的回忆:崔泰源专程去台湾拜访张忠谋。张忠谋先问他是不是要做代工,然后强调,越是低谷越要贴近客户,景气时也不能高高在上。这段对客户关系的强调,直接影响了 SK 收购之后的战略。崔泰源随后逐个说服董事,据视频说,直到截止日才提交投标。
2012 年 2 月 14 日,SK Telecom 支付约 3.37 万亿韩元,取得海力士 1.461 亿股、21.05% 股权,成为控股股东,公司随后更名为 SK hynix [11]。
收购后,崔泰源去利川和大约 100 位高管逐一谈话,每次一两个小时,问同一个问题:这家公司将来应该擅长什么,怎么做到。他给出的方向是:不再按标准规格卖商品存储器,而是做客户离不开的产品,从设计阶段就和客户一起定义需求。
“商品存储器”(commodity memory)指的是标准化、可互换、主要靠价格竞争的产品,和工艺先进与否无关。DDR4 内存条,三星的和海力士的插上去都能用,客户只看价格;HBM 不一样,它要和某一款 GPU 一起设计、一起验证,换一家供应商意味着重新认证。新股东带来的不只是钱,还有一个能撑住长期研发的组织结构。
| 年份 | 关键转折 | 对下一阶段的影响 |
|---|---|---|
| 1999 | 现代收购 LG 半导体 | 规模上来了,财务负担也上来了 |
| 2001–2002 | 更名、债权人重组、否决 Micron 方案 | 保住核心存储业务,继续独立求生 |
| 2003–2005 | 卖资产、工艺降本、布局无锡 | 靠自救加市场回升走出危机 |
| 2007–2008 | 扩产计划撞上需求下行 | 暴露商品存储器的周期与现金风险 |
| 2012 | SK Telecom 取得 21.05% 控股权 | 稳定长期投入,转向设计阶段的客户协同 |
HBM 的想法比 SK 的收购早了二十多年。SK 的作用是让这条本来可能被砍掉的研发线,有了一个愿意等十年的股东。
二、HBM 解决什么问题:把更多数据送到计算芯片
视频 14:56–19:06
算力上去以后,瓶颈变成了数据搬运
视频从 AMD 的 Bryan Black 等人 2006 年发表的论文《Die Stacking (3D) Microarchitecture》讲起 [12]。论文研究的是用三维堆叠缩短片内和片间的连线,其中就包括把 DRAM 堆在处理器附近。后来 AMD 发现,GDDR5 的带宽和功耗都快走到头了:想要更高带宽,就得把板级走线跑得更快,功耗随之上升,而 GPU 的总功耗预算是固定的,内存接口多吃一瓦,计算单元就少一瓦。于是 AMD 找到海力士,一起做一种新的内存架构。
这里有个前提:增加带宽只对受带宽限制的负载有用。图形渲染和深度学习(尤其是 LLM 的 decode 阶段)大量时间花在从显存搬数据上,属于这一类;如果一个负载本身卡在算力或者延迟上,带宽翻倍不会让它快一倍。
另外,带宽、容量、延迟是三个独立的指标:带宽是每秒能搬多少数据,容量是能存多少数据,延迟是一次访问要等多久。HBM 多叠几层,主要增加的是容量;带宽上限由接口宽度和每根线的速率决定。
一座 HBM 堆栈的结构:TSV、微凸点和基底裸片
HBM 把多颗 DRAM 裸片在垂直方向叠起来,最下面是一颗基底裸片(base die),用逻辑工艺制造,负责和处理器交换数据的接口电路以及测试等辅助功能。
堆栈内部有两种连接:
- TSV(Through-Silicon Via,硅通孔):垂直穿过一颗裸片的硅体,解决”穿过一层”的问题。
- 微凸点(microbump):位于相邻两颗裸片之间,把上下两层的 TSV 接起来,解决”跨过层间界面”的问题。
一条数据沿垂直方向走,就是 TSV → 微凸点 → TSV → 微凸点……交替通过。
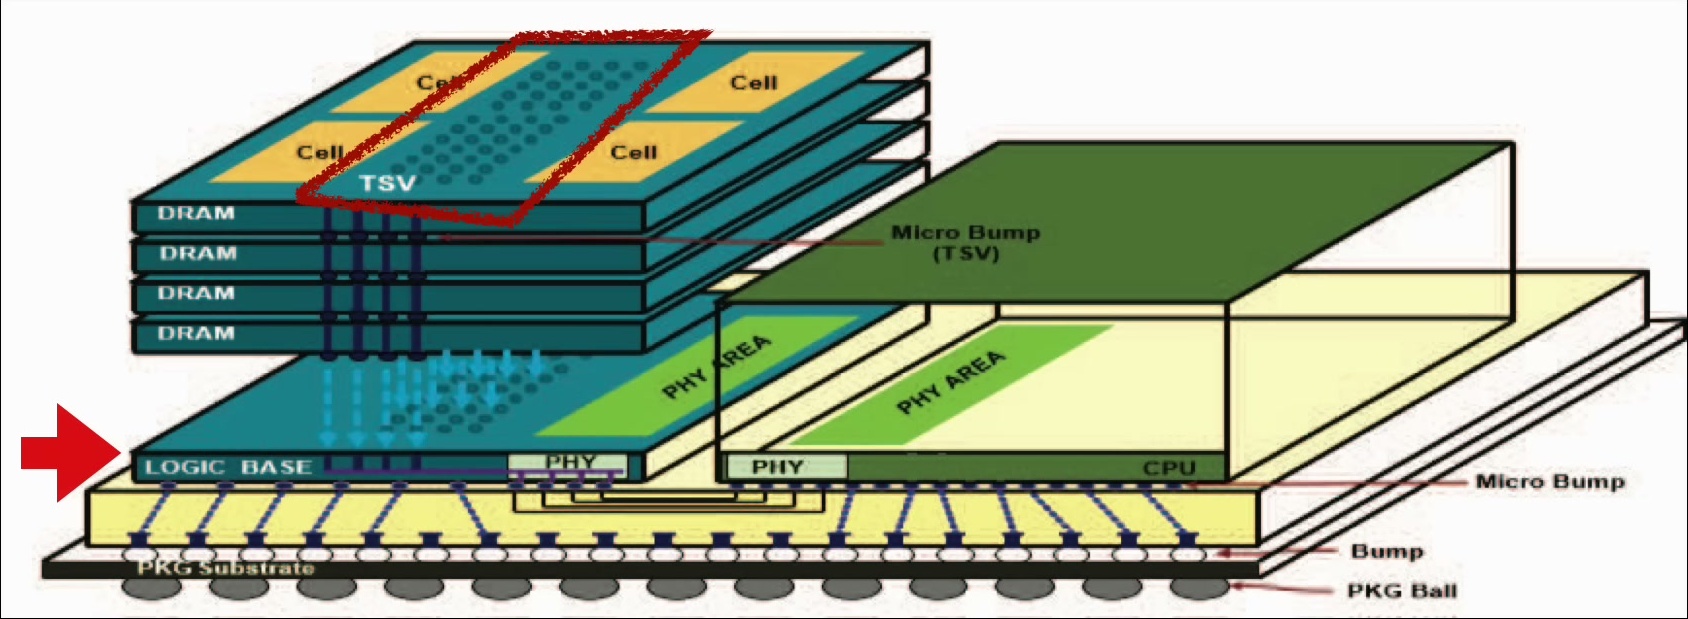
图 1:DRAM 堆栈、TSV 区域和逻辑基底裸片,右侧为标注 CPU 的处理器示意,两者通过下方的中介层横向相连。图出自视频引用的 Lee 等人论文。(视频 16:13–16:52)
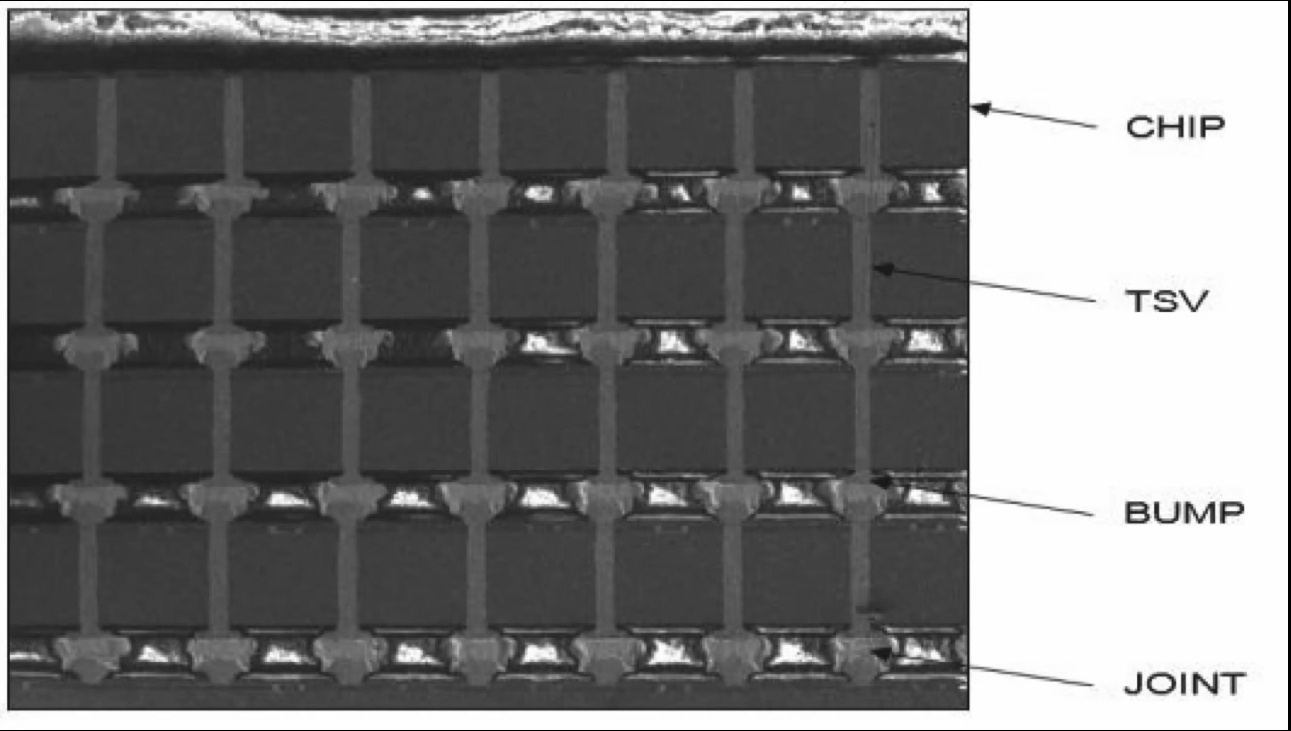
图 2:截面中的裸片、TSV、微凸点和接合位置。图出自视频引用的 Lee 等人论文。(视频 16:28–16:52)
HBM 放在 GPU 旁边,而不是叠在 GPU 上面。典型的 GPU + HBM 方案里,GPU 和几个 HBM 堆栈并排放在一块硅中介层(interposer)上,中介层负责 GPU 与各堆栈之间密集的横向布线。DRAM 堆栈内部是 3D 的,GPU 和 HBM 在中介层上的集成是 2.5D 的,TSMC 的 CoWoS 就是这一类封装 [13]。
早期 HBM 的基底裸片只承担接口、测试这类功能,到 HBM4 才开始讨论把更多逻辑放进去。SK 海力士在 2024 年 4 月和 TSMC 签了合作备忘录:到 HBM3E 为止用自家工艺做基底裸片,HBM4 改用 TSMC 的先进逻辑工艺,以容纳更多功能、支持客户定制 [13]。
宽而慢 vs 窄而快:带宽的算式
视频用两条河打比方:GDDR5 是一条又急又窄的河,HBM 是一条流得慢但宽得多的河,后者每秒的总水量更大。
换成算式,接口的理论峰值带宽是:
\[B = \frac{N \cdot r}{8}\]- $B$:峰值带宽,单位 GB/s;
- $N$:数据接口宽度,即并行数据线的条数,单位 bit;
- $r$:每条数据线的传输速率,单位 Gb/s(这已经是实际数据率,不需要再乘 DDR 的 2);
- $8$:bit 到 byte 的换算。
拿视频里的两张卡对比:
NVIDIA GTX TITAN Black(GDDR5):384 bit 接口,每线 7 Gb/s [14]。
\[B_{\text{GDDR5}} = \frac{384 \times 7}{8} = 336\ \text{GB/s}\]AMD Radeon R9 Fury X(HBM1):每个堆栈 8 个通道 × 128 bit = 1024 bit,四个堆栈共 4096 bit,每线 1 Gb/s [15][16]。
\[B_{\text{HBM1}} = \frac{4 \times 1024 \times 1}{8} = 512\ \text{GB/s}\]单个堆栈是 128 GB/s,四个堆栈合计 512 GB/s。这组对比里 HBM 领先约 1.52 倍,视频说”数倍”有点夸张。但关键在于实现方式:GDDR5 每根线跑 7 Gb/s,HBM 每根线只跑 1 Gb/s,靠宽度赢。低速信号对驱动电路、功耗和信号完整性的要求都低得多。
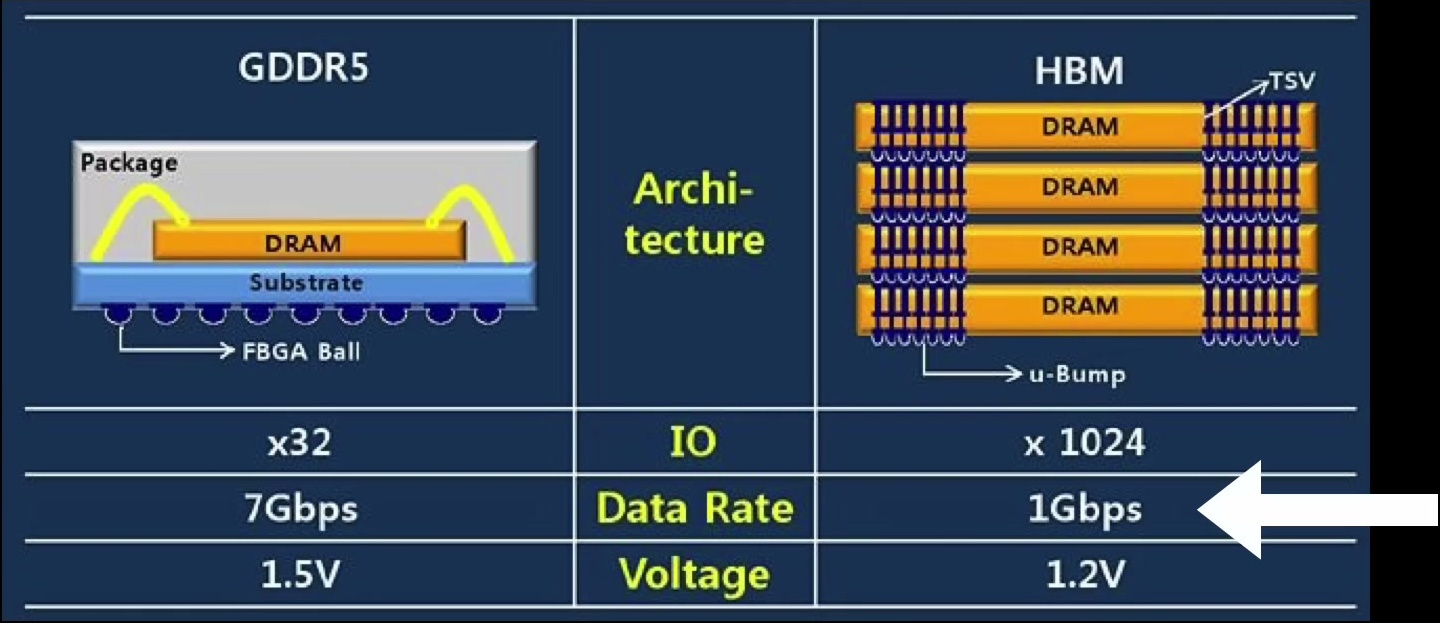
图 3:单颗 32 bit GDDR5 器件与一个 1024 bit HBM1 堆栈的对照;GDDR5 为 x32、7 Gbps、1.5 V,HBM 为 x1024、1 Gbps、1.2 V;整块 GPU 的总接口宽度要把所有器件或堆栈加起来。图出自视频引用的 Lee 等人论文。(视频 17:34–17:45)
| 对象 | 接口宽度 | 每线速率 | 峰值带宽 |
|---|---|---|---|
| GTX TITAN Black / GDDR5 | 384 bit | 7 Gb/s | 336 GB/s |
| 单个 HBM1 堆栈 | 1024 bit | 1 Gb/s | 128 GB/s |
| Fury X,4 个 HBM1 堆栈 | 4096 bit | 1 Gb/s | 512 GB/s |
| HBM2 目标,单堆栈 | 1024 bit | 2 Gb/s | 256 GB/s |
为什么宽接口必须配合 TSV?因为 1024 根线不可能从 PCB 上走。GDDR 芯片焊在显卡板上,信号要走几厘米的板级走线;HBM 堆栈和 GPU 挨在同一块中介层上,距离只有几毫米,堆栈内部更是靠几十微米长的 TSV 垂直连通。连线越短,电阻和电容越小,每传一个 bit 消耗的能量越低,也才能在有限面积里塞下上千根并行线。
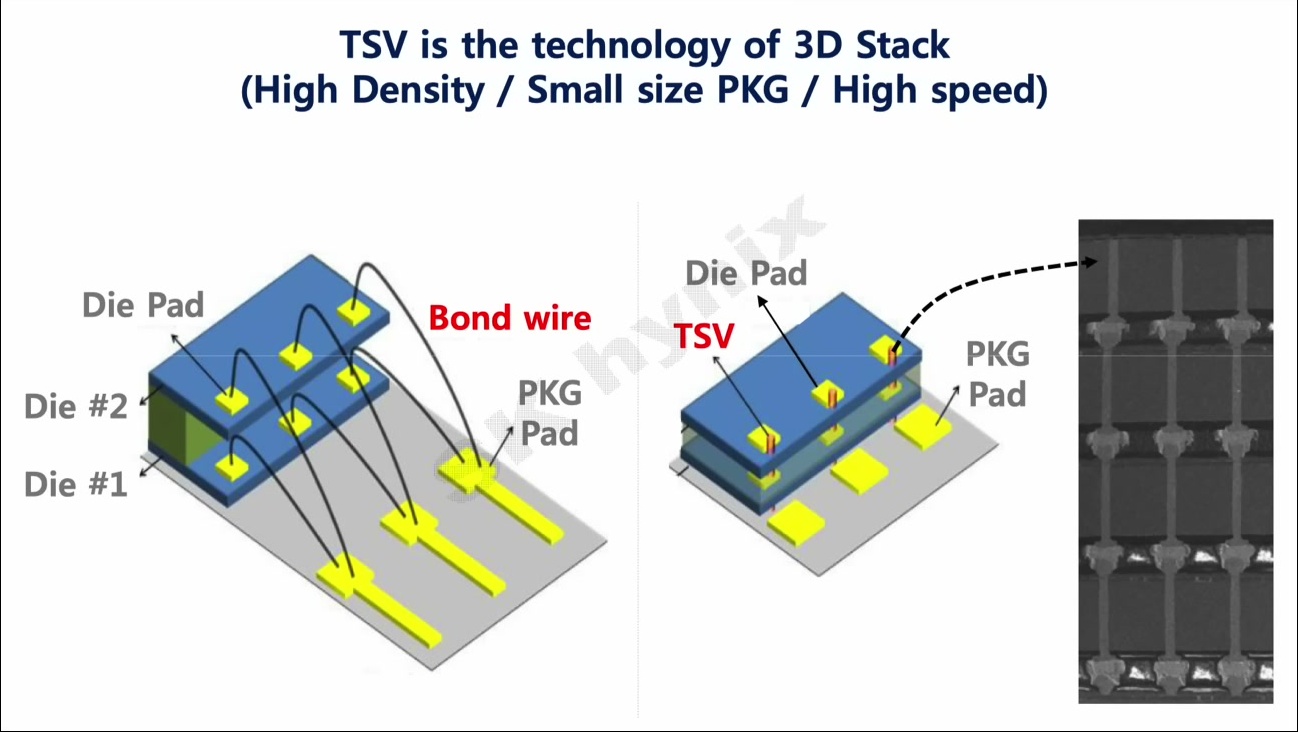
图 4:引线键合堆叠与 TSV 连接的路径对比,TSV 把垂直互连缩短到裸片厚度量级。视频引用 Kim 与 Kim,Hot Chips 2014。(视频 18:07–18:17)
HBM1:标准化和第一款产品
SK 海力士 2013 年 12 月宣布开发出 HBM1:1 Gb/s/pin、1024 数据 I/O、单堆栈 128 GB/s、1.2 V,与 AMD 联合开发 [17]。同年,SK 海力士和 AMD 把 HBM 规范提交给 JEDEC,成为行业标准。
把自己和客户联合开发的接口交给标准组织,等于把竞争对手也请进来。好处是生态:GPU 厂商敢用一种多家都能供货的内存,配套的中介层、封装、测试设备也会跟进。
2015 年 6 月,AMD 发布 Radeon R9 Fury X,这是第一款用上 HBM 的显卡 [15]。它的 Fiji 封装集成了来自多家供应商的 22 颗裸片,AMD 的演示资料里 GPU engine 面积约 596 mm²,整个封装标注为 1011 mm² [18]。Bryan Black 当时说:”我们会在更多 AMD 产品里看到 HBM。这项技术不是只为这一款开发的,是为未来开发的。”
三、技术领先为什么还是失败:从 HBM1 到 HBM2
视频 19:07–24:52
Fury X 卖得不好,但客户还要下一代
Fury X 证明了 HBM 能用在旗舰 GPU 上,但它没卖出量。视频说主要原因是量产困难和良率问题,供货一直跟不上。
从财务上看,继续做 HBM 不是显而易见的选择:这个小众产品没赚到什么钱,SK 海力士可能连产线设备的投资都没收回来。崔泰源后来回忆,他和 AMD CEO 苏姿丰会面时提了好几个新的合作方向(比如一起做 CPU),但苏姿丰最想要的,还是继续开发 HBM。
崔泰源决定继续投入。这是一次由客户需求驱动的战略投资。
竞争也逼着他继续。Fury X 发布六个月后,三星宣布量产 HBM2。当时 HBM 市场很小、客户只有几家,如果海力士交不出 HBM2,三星就会拿下这一代,甚至整个品类。
HBM2:一次跳过两个台阶的赌博
2015 年 3 月,海力士展示了首批 HBM2 晶圆,路演资料上写着 2016 年年中推出,还在 NVIDIA 当年的 GTC 上展示了测试晶圆。2015 年 12 月底,韩国 ETNews 报道三星和海力士的 HBM2 都已进入开发最后阶段,2016 年上半年量产。
但团队内部压力很大。HBM1 没卖好,所以 HBM2 既要性能翻倍(每线速率提到 2 Gb/s),又要降成本。他们的做法是从 2x 纳米级 DRAM 工艺直接跳到 2z,跳过中间的 2y。(2x/2y/2z 是 DRAM 厂商对 20 纳米级内部几代工艺的代号,数字依次变小,不对应精确的纳米数。)裸片更小,一片晶圆切出的裸片更多,单颗裸片就更便宜。
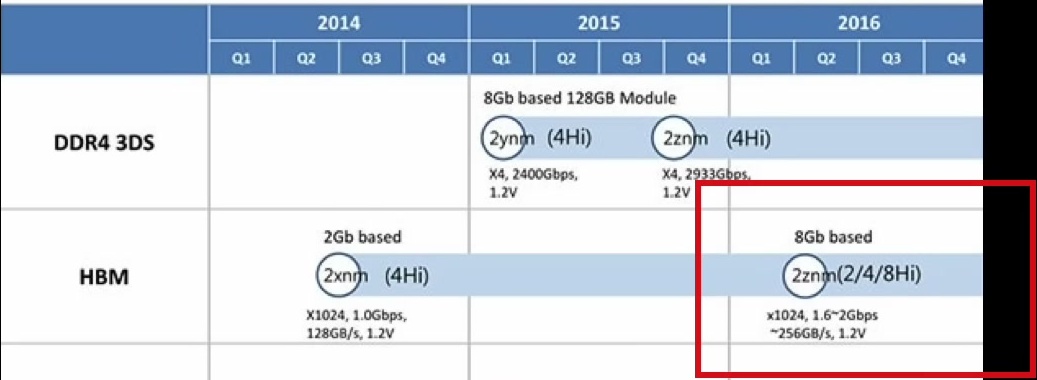
图 5:2015 年展示的 HBM 路线图局部,2016 一栏写着 2z 级工艺、1.6–2 Gb/s 和约 256 GB/s。(视频 20:56–21:08)
据视频回顾,接下来发生了一连串事故:
- 规格临时改变:产品规格在最后关头变了,设计被迫紧急调整。
- 电气性能崩了:主要因为寄生电容过高,TSV 的传输速率只有 500 Mb/s,是 2 Gb/s 目标的四分之一。原计划出 2 Gb/s 和 1.6 Gb/s 两个版本,每个季度都在延期,2 Gb/s 的高端版本最终取消。
- 封装来不及优化:设计改得太急,没有时间调封装工艺,堆叠时裸片开裂,晶圆切割也出问题。视频称 HBM2 的平均良率约 50%。
- 过不了客户认证:产品发布之后仍然没通过客户的 qualification。时任 CEO 朴星昱亲自去拜访一位客户,得到的是”严厉的批评”。
整个延期持续了一年半,HBM2 团队的最高设计负责人换了三次,产品直到 2018 年才最终交付。
这里能看到降本逻辑的漏洞:工艺缩小省下的是裸片面积,但一颗可以卖出去的 HBM 堆栈,成本还包括堆叠、封装、报废和认证。只盯着第一步(每片晶圆切出多少裸片),后面几步一旦出问题,省下的硅成本全部赔回去还不够。
发布、客户认证、量产交付也是三个不同节点。只看发布日期,会以为海力士在 2016 年就有 HBM2 了,实际客户能大批量拿到货是 2018 年。
终于交付,需求又没了
HBM2 量产后,海力士投资超过 4 亿美元建了一座新的封装测试厂 P&T4。2010 年代后期,HBM 的一个重要需求来源是加密货币挖矿 GPU。然后 2018 年币圈进入寒冬,视频说比特币跌了约 75%,到了 5000 美元区间,挖矿 GPU 和 HBM 的需求一起崩了,P&T4 长期开工不足。
教训:成本和性能,先选一个
HBM2 给团队留下的结论很直白:在当时的工艺能力和时间压力下,成本和性能只能先选一个。 2018 年年中启动第三代 HBM2E 时,他们全力押性能。
具体改动:TSV 数量翻倍,加入散热用的 dummy bump 来应对温度变化带来的物理应力。TSV 翻倍不代表数据接口翻倍:HBM2E 仍然是 1024 个数据 I/O [19],多出来的 TSV 用于供电、接地、冗余和散热。
但最大的变化在封装方式上。视频作者认为这一步风险很高:HBM 封装比普通 DRAM 多出约 100 道工序,耗时约为两倍;而且封装的对象是已经测试合格的好裸片,一旦在封装阶段失败,前面所有的晶圆制造成本都一起报废。
四、封装突破:从逐层热压到 MR-MUF
视频 24:53–31:58
先分清三件事:接合、底填、包封
HBM 堆栈的封装要完成三件事:
- 接合(bonding):每个微凸点是一根铜柱,顶上戴一个焊料帽。把裸片对齐叠好后加热,焊料熔化,上下两层的微凸点焊在一起,形成电气和机械连接。
- 底填(underfill):焊完之后,凸点之间还有约 10–50 μm 的空隙,不能空着。底填材料填进去,提供电气绝缘和防潮,最重要的是缓冲应力:硅、铜、焊料的热膨胀系数不同,温度一变各自伸缩的幅度不一样,没有底填,焊点会被反复拉扯直到开裂。
- 包封(overmold):最后用模塑料把整个堆栈包起来,保护外部。
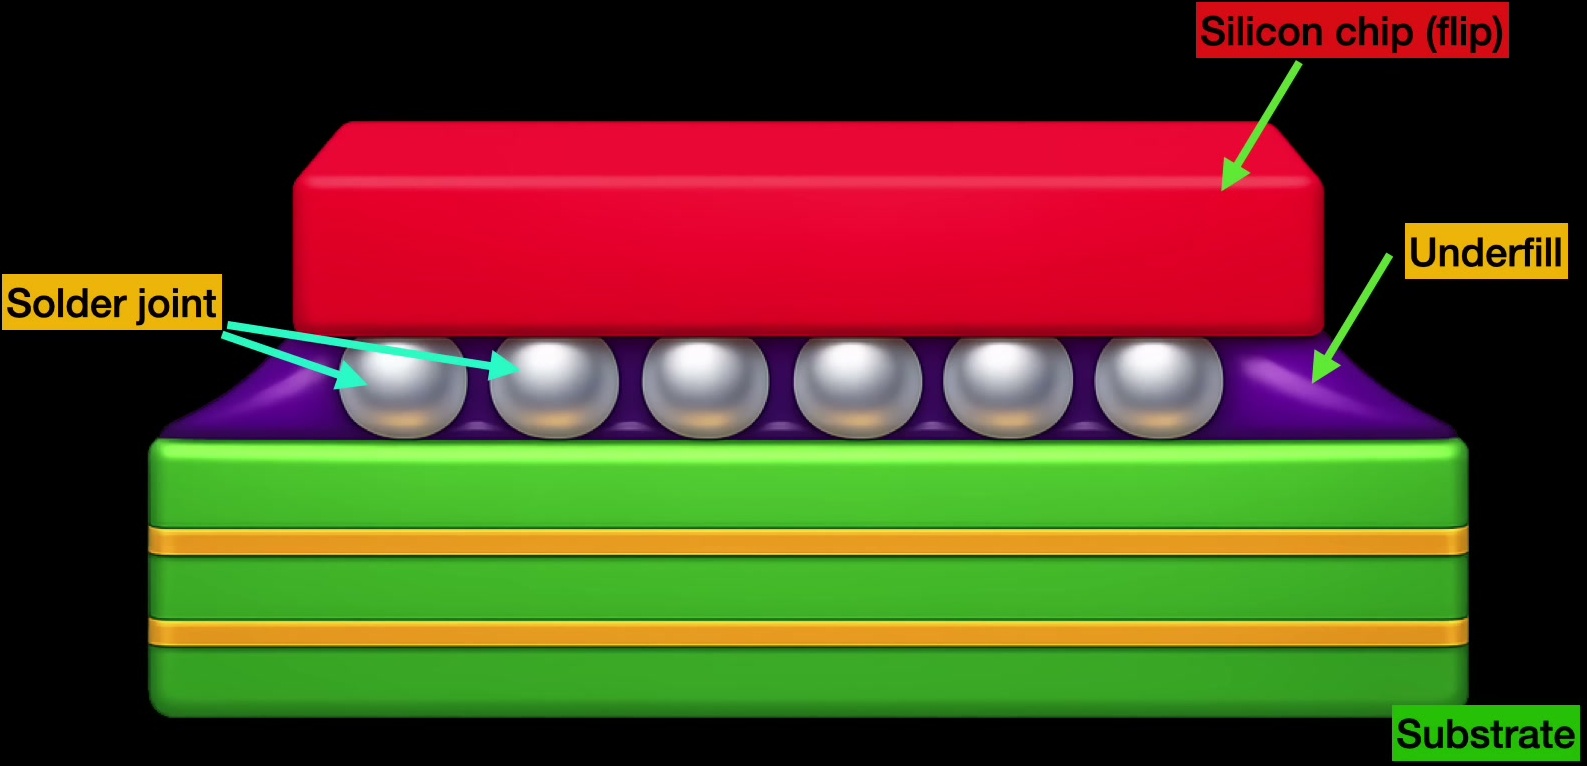
图 6:倒装芯片示意,紫色的底填材料位于焊点周围,用来说明底填的功能,尺寸不代表 HBM 实际情况。(视频 25:08–25:34)
┌──────────────────────────────────┐  ← 上层 DRAM 裸片
│▓▓       ▓▓       ▓▓       ▓▓     │  ← 微凸点(铜柱 + 焊料)
│░░░░░░░░░░░░░░░░░░░░░░░░░░░░░░░░░░│  ← 底填材料:填满凸点之间的空隙,缓冲热应力
└──────────────────────────────────┘  ← 下层裸片
后面三种工艺路线的区别,就在于这三件事分几步做、哪几件合并在一起做。
TC-NCF:一层一层地压
HBM1 和 HBM2 用的是 TC-NCF(Thermal Compression with Non-Conductive Film,非导电膜热压接合)。
流程是:先在每颗裸片上贴一层非导电胶膜(通常是环氧树脂和丙烯酸的混合物),然后把裸片对齐、叠上去,一边加热一边用力往下压。焊料熔化形成连接的同时,胶膜也软化流动,填满凸点之间的空隙。接合和底填一步完成。
视频的比喻是做 smash burger(压扁汉堡):把肉饼放在铁板上用力压扁。海力士最高用到约 40 公斤的接合力,”想象一袋大米砸在 HBM 上”。
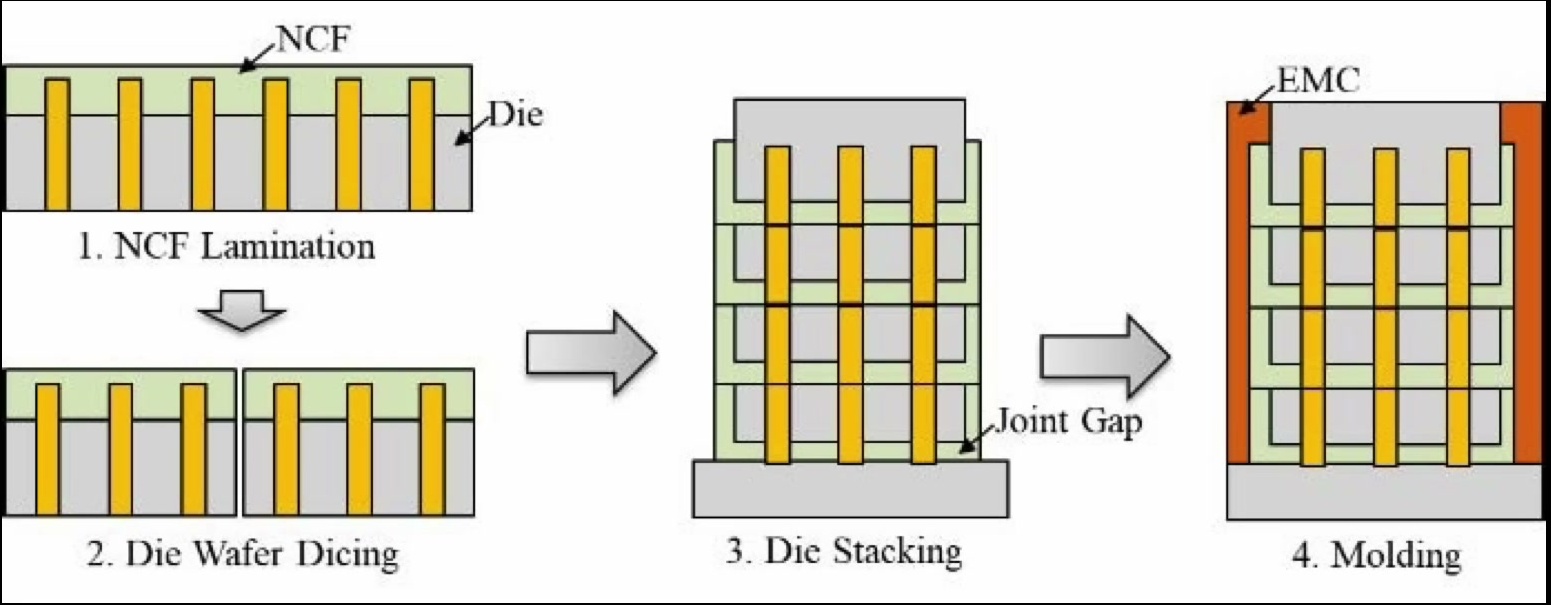
图 7:NCF 贴膜、晶圆切割、裸片堆叠和外部模塑的流程。视频引用 Hong 等,ECTC 2022。(视频 26:00–26:30)
TC-NCF 的优点:
- 用膜而不用胶,绝缘性好,短路风险低;
- 形成的底填层均匀,空洞少。层厚不均匀的话,叠到八层就成了比萨斜塔。
难点在工艺窗口:接合力、接合温度、升温速率、保温时间(dwell time)四个参数要同时调到刚刚好。偏了任何一个,都会出缺陷:
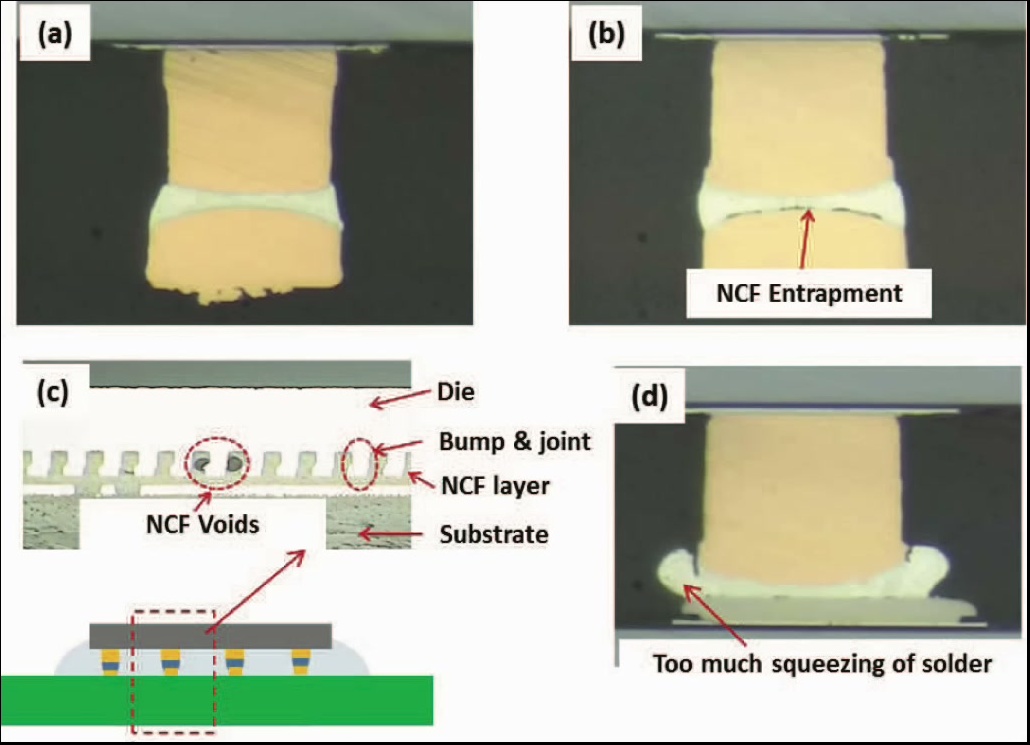
图 8:(a) 正常接合;(b) NCF 夹在焊点里;(c) NCF 中有空洞;(d) 焊料被过度挤出。视频引用 Yang 等,EPTC 2015。(视频 26:52–27:04)
但最大的问题是 TC-NCF 一次只能接一层。HBM 堆栈有 5 颗或 9 颗裸片(4 层或 8 层 DRAM,加一颗基底),就要重复热压 4 次或 8 次。像做三层汉堡,每层肉饼单独压一遍。这不仅慢,而且每多压一次就多一次出错的机会:一个九层堆栈里有一个 TSV 没连上,九颗裸片全部报废。
HBM2E 让问题更严重:TSV 数量翻倍、又加了 dummy bump,要让所有凸点都接上,就得加更大的压力;更大的压力和更多次的加热,意味着更多裂片和质量问题。
层数越多,良率越难:一个简化模型
可以用一个简单的模型直观感受层数的影响。假设每个接合界面成功的概率都是 $p$,且互相独立,那么 $k$ 个界面全部成功的概率是:
\[Y = p^{k}\]9 颗裸片之间有 8 个界面($k = 8$):
- $p = 99\%$ 时,$Y = 0.99^8 \approx 92.3\%$;
- $p = 95\%$ 时,$Y = 0.95^8 \approx 66.3\%$。
12 层 DRAM 加基底是 13 颗裸片、12 个界面,$p=99\%$ 时 $Y \approx 88.6\%$。这是教学用的模型,不是海力士的实测数据,没有考虑冗余 TSV、返修和裸片本身的缺陷,但它说明了一点:单层看起来”已经很好”的成功率,乘上层数以后可能就不够用了。
视频作者的判断是:TC-NCF 这条路再往下走不通,而且就算硬做成了,得到的东西和以前也没有本质区别,形成不了差异化。海力士需要换一条路。
MR-CUF:接合变快了,填充还是慢
2019 年,团队尝试了 Mass Reflow(整体回流,MR):先把所有 DRAM 裸片叠好,然后整体加热一次,所有层间的微凸点同时熔化焊接。不用再一层一层压了。
这一步成功了。但底填怎么办?
团队先试了 Capillary Underfill(毛细底填,CUF),这是封装行业的成熟技术:回流之后,从芯片边缘注入液态底填材料,靠毛细作用把液体吸进所有缝隙,再加热固化。MR + CUF 就是 MR-CUF。
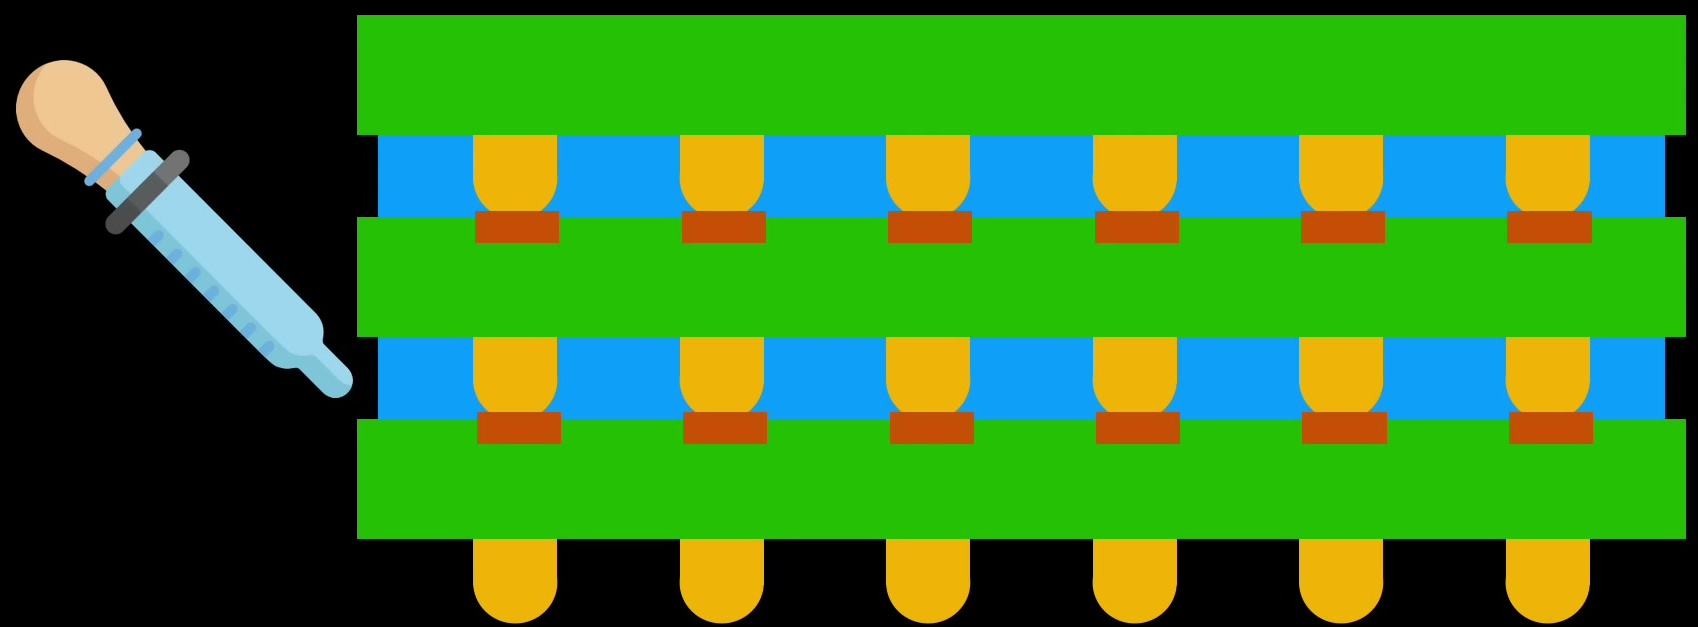
图 9:蓝色表示毛细底填材料已经进入各层间隙。(视频 28:55–29:24)
问题在于,MR-CUF 的毛细灌注和固化要对堆栈里的每一层依次重复。接合是一次搞定了,填充又变成了串行的瓶颈。试了半年,海力士放弃了这条路线。
这是制造业里的典型现象:把一道工序加速之后,瓶颈转移到了下一道。
MUF:底填和包封一次完成
团队接着看向移动芯片封装领域的 Molded Underfill(模塑底填,MUF)。手机芯片厂商采用 MUF,正是因为也被同样的吞吐问题折磨过。
MUF 用一种特殊的模塑料 EMC(Epoxy Molding Compound,环氧模塑料):树脂里混着细小的填料颗粒。在模具里注入 EMC,它不仅流进凸点之间的缝隙,还同时包住整个芯片,然后一起加热固化。底填和包封合并成一步,也不用等毛细作用慢慢渗透。
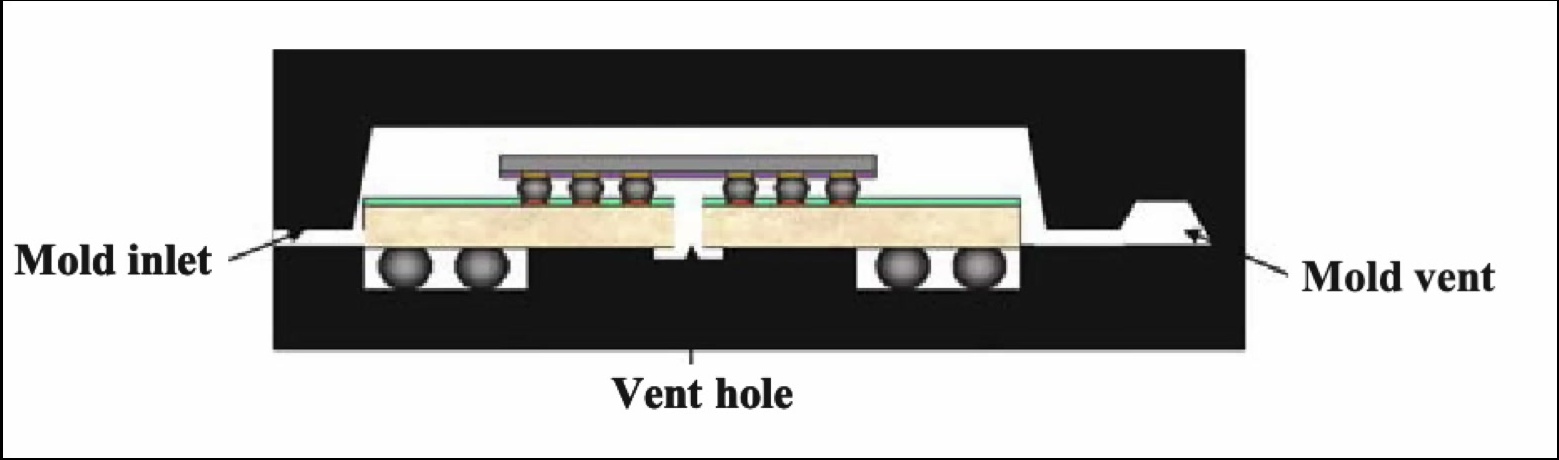
图 10:MUF 模具的进料口、排气口与排气孔(单颗倒装芯片示意,Lu 与 Wong,2009)。(视频 29:44–30:16)
听起来很合理,前提是能做成。难点有两个:
- 空洞:EMC 要流进凸点之间几十微米的缝隙,还不能留下气泡,粘度、填料颗粒大小、注塑压力、排气都要配合;
- 没人做过:MUF 以前只用在单颗小芯片的倒装封装上,从来没有用在八层 DRAM 堆栈上。
MR-MUF:所有东西从零开始共同开发
MR-MUF = 整体回流(一次完成所有层的接合)+ 模塑底填(一次完成底填和包封)。
因为市面上没有现成的设备和材料,海力士得全部自己联合开发:
- 模塑设备和日本 TOWA 一起做;
- EMC 材料和日本 NAMICS 一起开发,迭代了大约 50 次。
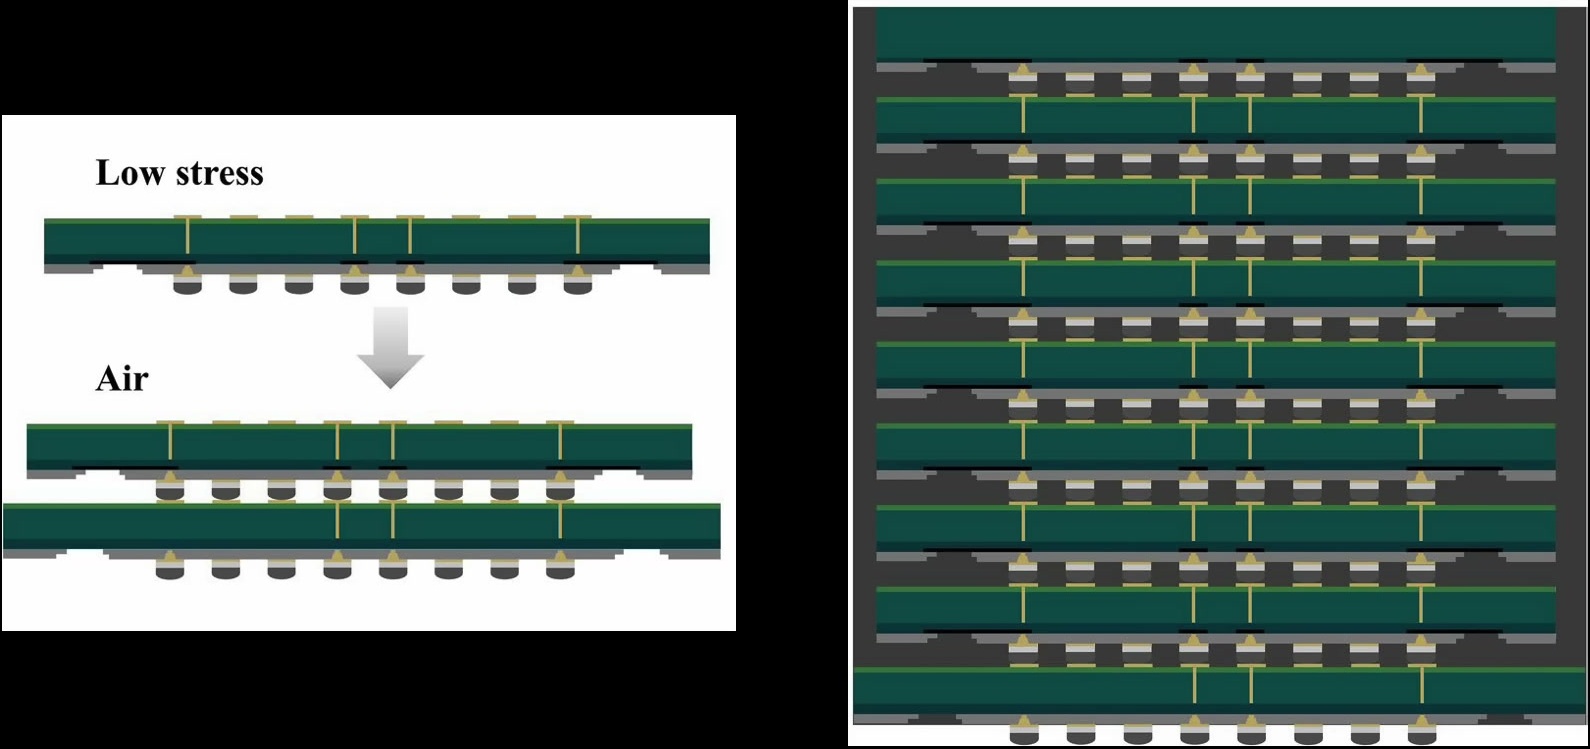
图 11:左侧为回流形成接合,右侧为多层堆栈的模塑填充与包封。视频引用 Lee 等,2025。(视频 31:10–31:43)
另外还要说服客户。HBM 和普通 DRAM 不同,是高度定制的:GPU 和 HBM 一起设计、一起验证。如果 MR-MUF 失败导致 HBM 延期,客户不可能去货架上随便买一个替代品。2019 年初,海力士第一次向潜在客户介绍 MR-MUF 时,客户(视频说”大概是被 HBM2 的事故吓怕了”)的反应是怀疑:这东西真能行?
它成了。2019 年 8 月,海力士宣布 HBM2E 开发完成:每线 3.6 Gb/s,单堆栈 460 GB/s,8 颗 16 Gb DRAM 裸片叠成 16 GB [20]。按公式验算:$1024 \times 3.6 / 8 = 460.8$ GB/s。客户认证测试中,HBM2E 的带宽表现远超预期,客户随即把它定进了自己的 GPU 设计。2020 年 7 月,HBM2E 量产 [19]。
后来海力士的 Advanced MR-MUF 还加入了逐片短时加热固定(chip control)的步骤,用来控制薄裸片的翘曲 [21],所以”整体回流”只指接合这一步集中处理。海力士自己的数据是,MR-MUF 让 HBM2E 的散热比 HBM2 提高了 36% [21]。
三条路线对比:
| 路线 | 接合 | 底填与包封 | 瓶颈 |
|---|---|---|---|
| TC-NCF | 逐层对齐、热压 | 膜底填与接合同步完成,再单独包封 | 热压次数随层数增加,工艺窗口窄,薄裸片易裂 |
| MR-CUF | 多层整体回流 | 毛细底填逐层灌注、固化,再单独包封 | 接合快了,填充变成新瓶颈 |
| MR-MUF | 多层整体回流 | EMC 模塑一次完成底填与包封 | 材料流动、空洞控制、多层可靠性,需要设备与材料共同开发 |
MR-MUF 是海力士在那个阶段、针对自己的瓶颈给出的解法。三星和 Micron 在 HBM3E 上继续沿用并改进 TC-NCF,下一代还有无凸点的混合键合(hybrid bonding),工艺之争还没结束。
2021 年 10 月,海力士宣布 HBM3 开发完成:单堆栈 819 GB/s,8 层 16 GB 和 12 层 24 GB 两个版本 [22]。2022 年 6 月宣布量产,供应 NVIDIA H100 [23]。
五、AI 需求怎样兑现:技术准备、客户路线与产能
视频 31:59–36:05
ChatGPT 之前:一个没人要的小众产品
视频估计,在 ChatGPT 出现之前,HBM 只占整个 DRAM 市场的 1.5%–2%。价格贵、性能过剩,加密寒冬之后挖矿 GPU 需求也没了,没几个人想要。
视频作者推测,三星管理层在这个阶段大概也开始怀疑,为什么要往 HBM 里投这么多钱。2010 年代后期,业界普遍认为 AI 的未来在边缘端:IoT 设备、5G 等。于是在一个关键节点上,三星把重心放到了 HBM-PIM(Processing-in-Memory,存内计算),而不是 HBM3。
HBM-PIM 的思路是在内存里集成可编程的 AI 计算单元,绕开冯·诺依曼瓶颈,减少数据搬运。这个概念有它的价值,但需要大量配套软件工作,而且作为”边缘推理”方案,它针对的是语音识别、机器视觉这类负载,不是大语言模型。
结果是:2022 年 11 月 30 日 ChatGPT 发布那天,能为人人都想买的 NVIDIA GPU 提供高性能 HBM3 的,只有 SK 海力士一家。
AI 需求爆发时,客户要的是能通过系统验证、能按时交付的 HBM。接口设计、封装工艺、和 NVIDIA 多年的联合验证,这些东西新进入者几个月内复制不出来。需求爆发放大的是此前积累的能力。
需求爆发不等于马上赚钱
ChatGPT 火了,但海力士的财报没有马上好转。2022 年整个存储行业都在消化疫情后的库存,DRAM 和 NAND 价格暴跌。ChatGPT 发布的那个季度(2022 年第四季度),海力士录得约 1.7 万亿韩元(视频按约 15 亿美元计)营业亏损 [24],这是十年来第一次季度营业亏损,之后又连亏了三个季度。
新产品的需求要经过订单、生产、出货、确认收入,才能反映到财报上;而 HBM 当时在海力士总收入里占比还很小,盖不住标准 DRAM 和 NAND 的亏损。
2023 年春天:所有人都在催货
到 2023 年春天,HBM 这边开始变得有意思了。ChatGPT 迅速膨胀,客户要更多的 HBM,越快越好。视频说,崔泰源每见一个人,对方都要求他再把开发进度往前提,他开玩笑说都不敢再见人了。
海力士开始四处找产能:
- P&T4 满负荷运转:就是那座加密寒冬后开工不足的封装厂,现在全速运转,但还是不够。
- M15 改造:来不及建新厂,海力士把清州 M15 厂二楼一个原本规划给 NAND 的空洁净室,塞进了数百台设备,六个月内改造成 HBM 封装产线。前段晶圆厂的空间被改成了后段封装用途。
M15X:真正的信仰之跃
更大的赌注是 M15X 扩建。2022 年 9 月,ChatGPT 发布前几个月,海力士宣布在清州 M15 旁边扩建新厂。但很快,疫情后的巨额亏损让项目被搁置:公司已经在龙仁建一座新厂了,再扩建显得太冒进。
但龙仁要到 2027 年才能完工。到 2024 年初,HBM 需求增长的速度超出了所有人的预测。2024 年 4 月,海力士正式重启 M15X,并把它从原计划转为生产 DRAM(为 HBM 提供裸片)。官方公告的工厂建设费约 5.3 万亿韩元(视频按约 40 亿美元计),加上后续分期投入的设备,长期总投资超过 20 万亿韩元 [25]。
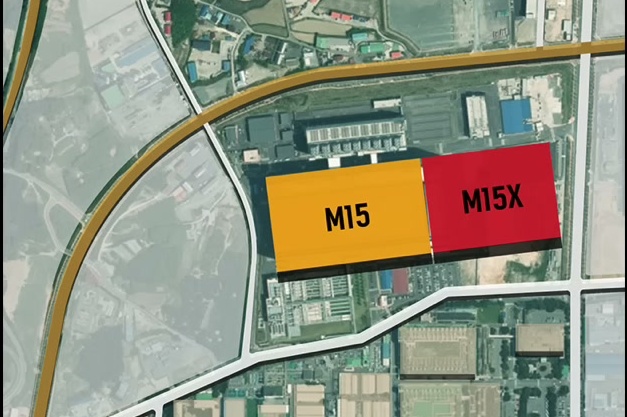
图 12:清州 M15 与相邻的 M15X 位置。原图来自 SK hynix。(视频 35:10–35:22)
HBM 产能是前段和后段配套的:DRAM 晶圆厂提供裸片,TSV 加工、堆叠封装、测试形成成品。只扩前段、封装跟不上,交不出 HBM;只扩封装、没有足够的合格裸片,设备也只能闲着。海力士一边用 M15 的空洁净室快速补封装产能,一边重启 M15X 补 DRAM 晶圆产能,两头一起扩。
看产能新闻时,可以问三个问题:
- 增加的是晶圆投片能力、堆叠封装能力,还是通过客户认证的成品交付能力?
- 数字是设备名义上限,还是稳定产量?
- 时间点是宣布、完工、试产,还是量产?
六、结尾:从韩国公司到全球 AI 存储供应商
视频 36:06–38:08
ADR 上市
2026 年 7 月 10 日,SK 海力士 ADR 在纳斯达克开始交易 [26]。按 SEC 最终招股书,此次发行 1.779 亿股 ADS,每股 149 美元,总发行额约 265.07 亿美元 [27]。纳斯达克称其为美国资本市场史上最大的 ADR 上市;视频说是”美国历史上第二大发行”,这个排名口径更宽,我没有找到一手资料直接确认。
视频作者认为,股价会去它该去的地方,但更重要的是:历史上很少有韩国公司像这样走出韩国、进入美国资本市场。崔钟贤时代进入能源和电信,让 SK 成为韩国第五大财阀;崔泰源收购海力士,让 SK 升到了第二。
印第安纳与 1100 万亿韩元
SK 海力士已经在美国印第安纳州 West Lafayette 建设先进封装生产与研发基地。2024 年 4 月公告的投资额约 38.7 亿美元,计划 2028 年下半年量产 [28]。视频发布之后,2026 年 8 月 28 日的奠基公告把预计总投资上调到超过 40 亿美元,洁净室计划 2028 年 10 月启用,量产推迟到 2029 年下半年;在韩国生产的晶圆运到印第安纳封装测试 [29]。
视频结尾时,DRAM 价格高企,供给已经被预订到两年之后。海力士在 2026 年 6 月公布了一项 1100 万亿韩元(1.1 × 10¹⁵ 韩元,”这个数字我在频道里还能说几次?”)的中长期投资策略 [30]:
- 龙仁集群:约 600 万亿韩元(投资会延续到 2033 年之后);
- 清州集群:约 100 万亿韩元(NAND 厂、设备、HBM 后段封装);
- 西南地区新集群:约 400 万亿韩元(选址待定)。
这是分阶段、分批经董事会批准的长期规划,主要靠经营现金流支撑,没有统一的截止年份,也不是年度资本开支。
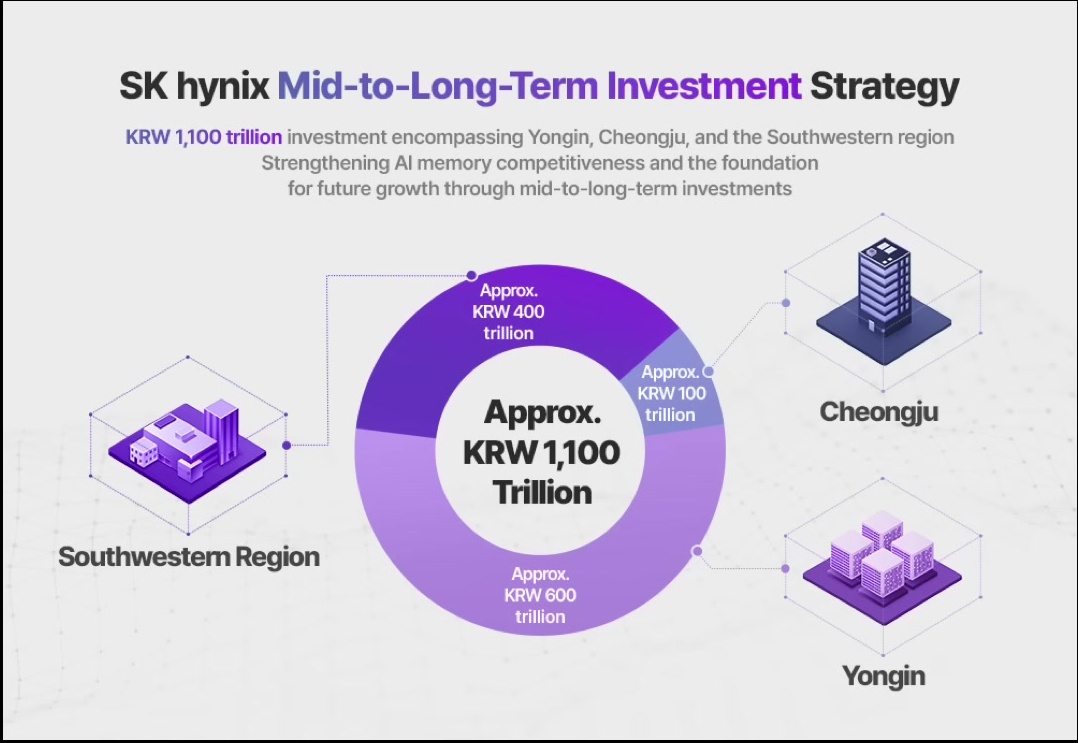
图 13:2026 年 6 月公布的 1100 万亿韩元中长期投资策略及地区分配。原图来自 SK hynix。(视频 37:13–37:27)
视频作者还开玩笑说:”将来也许会有一个美国集群?做做梦嘛。”
视频的收束
很少有公司在危机和成功之间摆动得这么剧烈。连年亏损之后,海力士几乎被所有人放弃;SK 顶着内外反对把它买了下来;它做出了 HBM,然后 HBM 作为一个没人在意的小众产品躺了好几年;市场没有给出任何会有回报的信号时,公司还在继续做。
在《Super Momentum》的采访中,崔泰源回忆自己曾向父亲承诺,要打造一家能比肩甚至超越日本一流企业的公司。视频的最后一句是:借助 HBM 革命,SK 海力士做到了。
七、HBM 各代规格速查
视频主要讲到 HBM3,下面把一手资料里的各代规格补齐。注意带宽都是单个堆栈的接口峰值,不是整块 GPU 的总带宽,也不是程序实测的持续带宽。
| 世代 | 关键时间点 | 接口宽度 | 每线速率 | 单堆栈带宽 | 备注 |
|---|---|---|---|---|---|
| HBM1 | 2013-12 海力士开发;2015-06 Fury X 上市 | 1024 bit | 1 Gb/s | 128 GB/s | 8 × 128 bit 通道 [17] |
| HBM2 | 2016 Hot Chips 已公开规格 | 1024 bit | 1.0/1.6/2.0 Gb/s | 128/204/256 GB/s | 新增 64 bit 伪通道模式;2/4/8-high [31] |
| HBM2E | 2019-08 开发;2020-07 量产 | 1024 bit | 3.6 Gb/s | 460.8 GB/s | 8 × 16 Gb 裸片 = 16 GB;首次采用 MR-MUF [19][20] |
| HBM3 | 2021-10 开发;2022-01 JEDEC 标准;2022-06 量产 | 1024 bit | 6.4 Gb/s | 819 GB/s | 16 个独立通道,每通道 2 个伪通道;8-high 16 GB / 12-high 24 GB [22][32] |
| HBM3E | 2024-03 量产;2024-09 12 层 | 1024 bit | 最高 9.6 Gb/s | 1.18 TB/s(3 月产品);9.6 Gb/s 时理论 1228.8 GB/s | 12-high 36 GB [33][34] |
| HBM4 | 2025-04 JEDEC JESD270-4;2025-09 海力士开发完成 | 2048 bit | 标准 8 Gb/s;海力士产品 >10 Gb/s | 标准约 2 TB/s | 32 个独立通道;最高 16-high、64 GB;基底裸片转向 TSMC 逻辑工艺 [35][36] |
几个容易看错的地方:
- Gb 和 GB:16 Gb 是单颗裸片容量,16 GB 是八颗合起来的堆栈容量,差 8 倍;Gb/s 和 GB/s 也差 8 倍。
- 层数和带宽:从 HBM1 到 HBM3E,接口宽度一直是 1024 bit,叠 8 层还是 12 层只改变容量,不改变带宽。HBM4 的带宽跃升来自接口宽度翻倍到 2048 bit。
- TSV 数量和数据 I/O:1024 指的是数据线,不包括地址、命令、电源、地线,TSV 的总数远多于 1024。
- 单堆栈和整卡:H100 SXM 用 5 个 HBM3 堆栈,B200 用 8 个 HBM3E 堆栈,整卡带宽要乘以堆栈数(再考虑实际降频)。
总结
回头看,海力士的 HBM 优势是四件事叠在一起的结果:
- 一个肯等的股东。SK 的收购让 HBM 这条亏钱的研发线,在 Fury X 卖不动、HBM2 延误、加密寒冬这些节点上都没被砍掉。
- 一个肯等的客户。AMD 在 Fury X 失败后仍然最想要 HBM,后来 NVIDIA 把 HBM2E、HBM3 定进了数据中心 GPU。HBM 是定制件,客户关系本身就是护城河。
- 封装工艺上的一次换道。TC-NCF 走到头之后,海力士没有在原路上硬加压力,而是先试 MR-CUF,半年后放弃,再和 TOWA、NAMICS 从零开发 MR-MUF。HBM2E 之后的几代领先,主要来自这一次换道。
- 扩产时前后段一起扩。M15 的空洁净室改封装,M15X 重启做 DRAM,P&T4 从闲置到满载。
AI 带来的需求,正好撞上了此前十年积累下来的可交付能力。用”押中了一个热门概念”来解释海力士的成功,漏掉了中间所有真正难的部分。
对看存储行业新闻的人,这个故事给出的问题清单是:负载缺的是带宽、容量还是算力?厂商给的是单堆栈还是整卡指标?裸片、互连、封装是否同时达标?客户认证和实际产量到了哪一步?扩产计划覆盖了所有瓶颈环节吗?
留几个还没想清楚的问题:
- HBM4 把基底裸片交给 TSMC 之后,”定制 HBM”会让内存厂和 GPU 厂的关系更紧,还是让 TSMC 成为新的瓶颈?
- 12 层、16 层之后,MR-MUF 和 TC-NCF 谁的扩展性更好?混合键合什么时候进入量产?
- 三星当年选择 HBM-PIM 而非 HBM3,在 LLM 时代回头看是战略误判。但 PIM 的方向本身,会不会在推理侧(比如 decode 阶段的 GEMV)重新回来?
参考
[1] Asianometry,SK hynix and the HBM Revolution,YouTube,2026-08-13。本文叙述主线、管理层回忆和未另注明的数字取自该视频;截图时间区间为视频内时间码。
[2] SK hynix,Hyundai and LG Sign Definitive Agreement on Acquisition of LG Semicon,1999-05。
[3] SK hynix,Hyundai Electronics Name Change to Hynix Semiconductor Inc.,2001-03-09。
[4] SK hynix,Hynix Signs a Non-Binding MOU with Micron for Sale of Its Memory Business,2002-04-22。
[5] SK hynix,Statement from Hynix Semiconductor,2002-04-30。
[6] SK hynix,Hynix Introduces Innovative Blue Chip Technology,2001。
[7] SK hynix,Hynix to Launch Production on Its 0.10 Micron Process Technology,2003。
[8] SK hynix,Hynix and STMicroelectronics Lay First Stone for Memory Manufacturing Fab in China,2005-04-28。
[9] SK hynix,Hynix Semiconductor Inc. Reports Fiscal Year 2011 and Fourth Quarter Results,2012。
[10] SK Group,History。
[11] SK Telecom,2012 Annual Report。
[12] Bryan Black et al.,Die Stacking (3D) Microarchitecture,MICRO 2006。
[13] SK hynix,SK hynix Partners with TSMC to Strengthen HBM Technological Leadership,2024-04-19。
[14] NVIDIA,GeForce GTX TITAN Black Specifications。
[15] AMD,AMD Ushers in a New Era of PC Gaming with Radeon R9 and R7 300 Series Graphics Line-Up,2015-06-16。
[16] AMD,AXI HBM Controller: HBM Topology (PG276)。
[17] SK hynix,TSV 기반 초고속 메모리 개발(HBM1 开发公告),2013-12-26。
[18] Bryan Black / AMD,The Road to the AMD Fiji GPU,ECTC 2016 Panel,PDF;另见 CMU 18-600 Lecture 27 存档第 45 页。
[19] SK hynix,SK hynix Starts Mass-Production of High-Speed DRAM, HBM2E,2020-07-02。
[20] SK hynix,SK hynix Develops World’s Fastest High Bandwidth Memory, HBM2E,2019-08-12。
[21] SK hynix,Rulebreaker Revolutions: MR-MUF Unlocks HBM Heat Control,2024-07-30。
[22] SK hynix,SK hynix Announces Development of HBM3 DRAM,2021-10-20。
[23] SK hynix,SK hynix to Supply Industry’s First HBM3 DRAM to NVIDIA,2022-06-08。
[24] SK hynix,SK hynix Reports 2022 and Fourth Quarter Financial Results,2023-02。
[25] SK hynix,SK hynix to Produce DRAM from M15X in Cheongju,2024-04-24。
[26] SK hynix,SK hynix Lists ADRs on Nasdaq,2026-07-10;Nasdaq,Trader News ETA2026-37,2026-07-08。
[27] SK hynix,Final Prospectus (Form 424B4),SEC,2026-07-09。
[28] SK hynix,SK hynix Signs Investment Agreement of Advanced Chip Packaging with Indiana,2024-04-03。
[29] SK hynix,Groundbreaking Ceremony in Indiana,2026-08-28。
[30] SK hynix,Explainer: SK hynix’s Mid-to-Long-Term Investment Strategy,2026-06-29。
[31] Kevin Tran / SK hynix,The Era of High Bandwidth Memory,Hot Chips 28 Tutorial,2016。
[32] JEDEC,JEDEC Publishes HBM3 Update to High Bandwidth Memory (HBM) Standard,2022-01-27。
[33] SK hynix,SK hynix Begins Volume Production of Industry-First HBM3E,2024-03-19。
[34] SK hynix,SK hynix Begins Volume Production of the World’s First 12-Layer HBM3E,2024-09-26。
[35] JEDEC,JEDEC and Industry Leaders Collaborate to Release JESD270-4 HBM4 Standard,2025-04-16。
[36] SK hynix,SK hynix Completes World’s First HBM4 Development and Readies Mass Production,2025-09-12。