前置阅读:LLM 推理(Inference)性能推导 · DualPath:用双路径 KV-Cache 加载打破 Agentic 推理的存储瓶颈
本文基于 Caleb Writes Code 的视频《Inference Engines explained in 10min..》整理(2026-09-30 发布,10 分 18 秒),按各项目的原始论文和官方文档补充了公式、数字边界和命令行参数(文档核对于 2026-10)。文中截图均来自该视频,图注末尾标出对应画面在视频中的时间区间;04:12–05:05 的赞助段未收录。
同一个 Llama 模型,可以用 PyTorch 跑,可以用 llama.cpp 跑,也可以用 vLLM、SGLang、TensorRT-LLM 跑。为什么需要这么多推理引擎?
视频给出的答案是:每个项目诞生时,盯着的瓶颈不一样。llama.cpp 想解决”模型太大,我的电脑装不下”;vLLM 想解决”KV cache 太浪费,并发上不去”;SGLang 想解决”大家的 prompt 开头都一样,为什么要算很多遍”;TensorRT-LLM 想解决”怎么把 NVIDIA 的硬件榨干”。
这些项目发展到今天,功能列表已经高度重合:分页 KV、连续批处理、前缀缓存、量化,几乎每家都有。只看功能列表很难分出区别,回到它们各自最初要解决的问题,区别就清楚了。
视频封面。
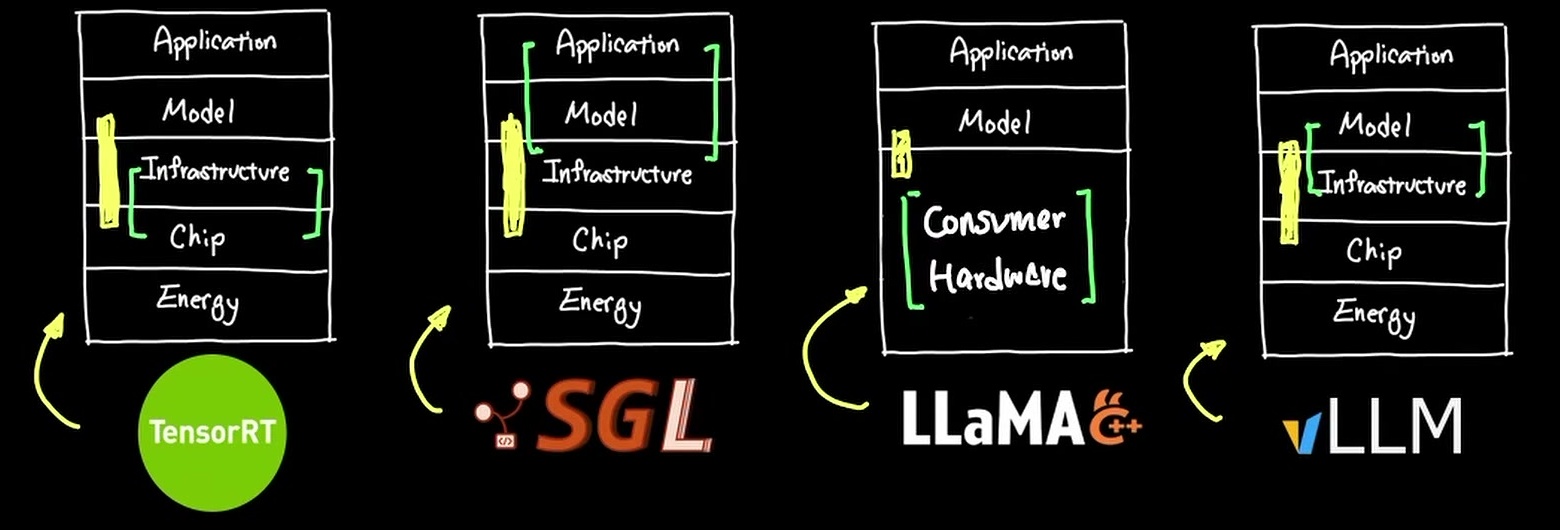
图 1:四个引擎在 AI 栈中各自的设计重心,由同一画面的四个局部横向拼接。这是”最初主攻哪一层”的示意,不是功能边界。(视频 09:09–09:24)
一张表先把全文压缩:
| 引擎 | 最初要解决的问题 | 代表性机制 | 主要改变的是 |
|---|---|---|---|
| PyTorch | 怎么方便地表达和运行模型 | 张量、算子、autograd | —— |
| llama.cpp | 消费级设备装不下、跑不动 | 量化、CPU/GPU 混合执行、mmap | 权重容量 |
| vLLM | 多请求的 KV cache 分配浪费 | PagedAttention、连续批处理 | 请求状态的存储组织 |
| SGLang | 共享前缀被重复计算 | RadixAttention、缓存感知调度 | 计算工作量 |
| TensorRT-LLM | NVIDIA 硬件利用不充分 | 专用内核、软硬件栈协同 | 执行效率 |
四条优化可以叠加:权重更紧凑、请求状态分配更省、共同输入少算几遍、计算和调度更贴合硬件。分别对应容量、存储、工作量、执行效率四个维度。
一、为什么会有这么多推理引擎
推理引擎做什么
推理引擎把训练好的模型变成可执行的计算,并管理执行时需要的资源。对 LLM 来说,具体包括:加载和表示权重、调用计算内核、管理 KV cache、调度多个请求、逐个输出 token,很多引擎还自带一个 OpenAI 兼容的 HTTP 服务。
它横跨模型结构、运行时系统和硬件三层。只看某个矩阵乘法跑多快,解释不了一个服务的整体表现。
自回归生成改变了工作负载
视频先回顾了负载的变化。早期深度学习推理的主角是 CNN:卷积、池化,输入输出形状固定,一次前向就结束。到了自回归 LLM,问题变成了 attention、batching、KV cache 和量化。
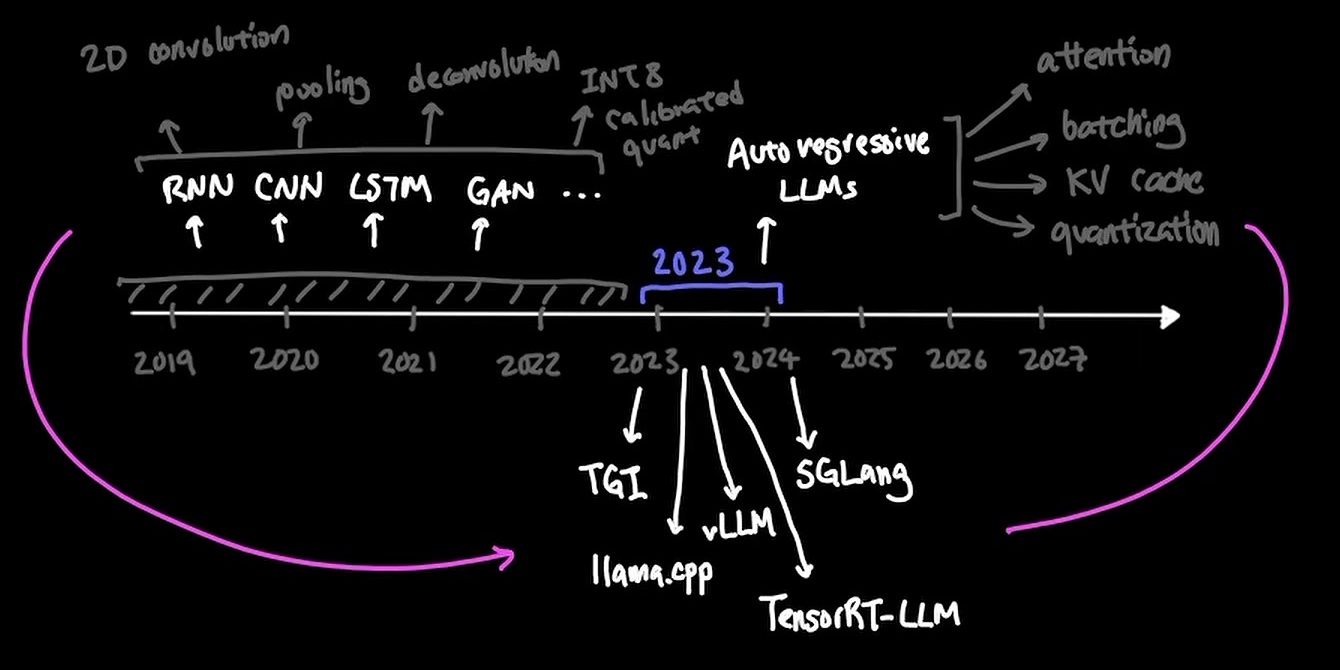
图 2:视频对比传统模型常见负载与自回归 LLM 的 attention、batching、KV cache、量化需求。(视频 00:49–01:13)
关键区别在于:LLM 的输出长度事先不知道,每生成一个 token,都要用到之前所有 token 的上下文,执行过程中有一份持续增长的状态。
LLM 推理分两个阶段:
- Prefill:一次性处理用户输入的全部 token,计算并保存它们每一层的 Key 和 Value(即 KV cache)。这一步是计算密集的大矩阵乘。
- Decode:基于已有的 KV cache 逐个生成新 token,每生成一个就把它的 K、V 追加进缓存。这一步每次只算一个 token,是访存密集的。
          ┌──────────────────────┐       ┌──────────────────────┐
输入 ───▶ │ Prefill:处理输入     │ ───▶  │ Decode:逐 token 生成 │ ──┐
          │ 建立输入的 KV cache   │       │ 读取并追加 KV cache   │ ◀─┘
          └──────────────────────┘       └──────────────────────┘
权重被所有请求共享,但每个请求的 KV cache 是独立的、长度各不相同。所以”模型装得下”和”许多长请求一起跑得好”是两个问题,后面的引擎就是在分别回答它们。
PyTorch:能跑,但服务需要的东西它不管
PyTorch 用张量和算子表达模型,既能训练也能推理。视频的观点是:直接调用模型的 forward,不会自动解决高并发自回归服务需要的那些问题:请求怎么合批、KV cache 怎么分配、请求结束了怎么回收、该用哪个内核。
那给 PyTorch 加上量化,能不能得到 llama.cpp 的效果?GPTQ、AWQ 这些量化方法确实能降低权重的内存占用,但一个能部署的系统还要把权重格式、计算内核、加载方式、运行设备组织到一起,量化只是其中一项。
PyTorch 本身完全可以做到高效推理。PyTorch 官方的 GPT, Fast 示例用 torch.compile、静态 KV cache、int4/int8 量化、投机解码,在纯 PyTorch 里把 Llama-7B 的 decode 速度做到了很高的水平 [2](博客之前也自测过 gpt-fast 的投机解码)。而且现在的 vLLM 和 TensorRT-LLM 底层都是 PyTorch:vLLM 用 torch.compile 和 CUDA Graph,TensorRT-LLM 已经把 PyTorch 作为唯一后端 [9]。
所以 PyTorch 和专用引擎是上下层关系:PyTorch 负责让模型容易表达和执行,专用引擎在它之上补上调度、缓存、专用内核这些服务层能力。
二、llama.cpp:在手头已有的设备上把模型跑起来
第一个限制:权重太大
llama.cpp 最初的目标很明确:针对 Llama 这类 Transformer 做推理优化,降低内存占用,尽量少依赖,让模型能在消费级设备上跑起来。
核心手段是量化:每个权重用更少的位数表示。权重的原始大小可以这样估算:
\[M_{\text{weights}} \approx \frac{P \cdot b}{8}\]- $M_{\text{weights}}$:权重大小,单位字节;
- $P$:参数量;
- $b$:每个参数的位数,FP16 是 16,INT4 是 4;
- $8$:bit 到 byte 的换算。
以 7B 模型为例:
- FP16:$7 \times 10^9 \times 16 / 8 = 14$ GB;
- 4-bit:$7 \times 10^9 \times 4 / 8 = 3.5$ GB。
14 GB 需要一张 16 GB 以上的显卡,3.5 GB 一台普通笔记本就能放下。实际的 GGUF 文件会比 3.5 GB 稍大,因为量化需要保存每组权重的 scale 和 zero point,部分敏感张量(比如 embedding、输出层)也可能保留更高精度。
这只是权重。运行时还要加上 KV cache、激活值和临时工作区。上下文越长、并发越多,KV cache 越大。”4-bit 模型 3.5 GB”指的是文件大小,进程的内存峰值要更高。
另外,GGUF 是文件格式,4-bit 是量化方式,两者是不同维度:GGUF 文件里可以存 FP16 张量,也可以混合多种量化类型 [3]。
第二个限制:GPU 装不下整个模型
llama.cpp 的第二个特点是同时利用 CPU、GPU、RAM 和 SSD。它支持 CPU、Apple Silicon(Metal)、NVIDIA(CUDA)、AMD(HIP)、Vulkan、SYCL 等多种后端,也支持 CPU + GPU 混合推理:显存放不下的层留在 CPU 上算 [3]。
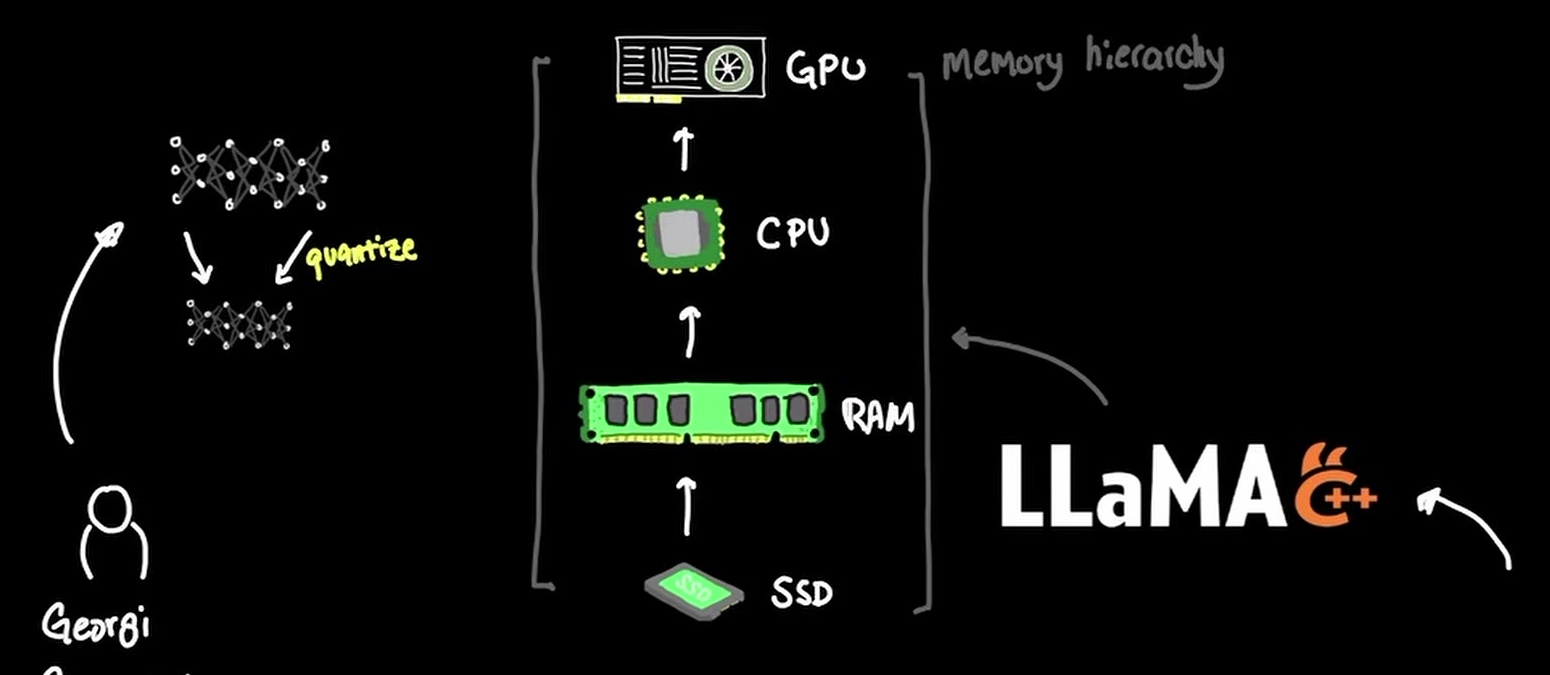
图 3:llama.cpp 的量化与 GPU、CPU、RAM、SSD 层次示意。(视频 02:31–02:57)
这四层角色不同:SSD 存文件,RAM 存 CPU 能直接访问的数据,GPU 在自己能访问的内存上计算。数据在层间搬运需要时间,如果慢速层被频繁访问,生成速度会明显下降。所以”能跑起来”和”跑得够快”要分开确认。
对应的命令行参数:
# -ngl:放到 GPU 上的层数,其余层留在 CPU;设一个很大的数等于全部放 GPU
# -c:上下文长度,直接决定 KV cache 大小
llama-server -m ./Llama-3.1-8B-Instruct-Q4_K_M.gguf -ngl 20 -c 8192
显存不够时,逐步调小 -ngl 直到能加载;-c 开太大,KV cache 会挤占本可以放权重的显存。
mmap:换一种方式加载权重
视频在 02:57–03:53 介绍了 llama.cpp 用 mmap 加载模型。
普通的文件读取(read)会把文件内容从内核的页缓存复制到应用自己的缓冲区,相当于内存里有两份。mmap 则把文件直接映射到进程的虚拟地址空间,应用访问那段地址时,操作系统按页把文件内容调入物理内存(缺页中断),页缓存里的那一份就是应用看到的那一份,不再额外复制。
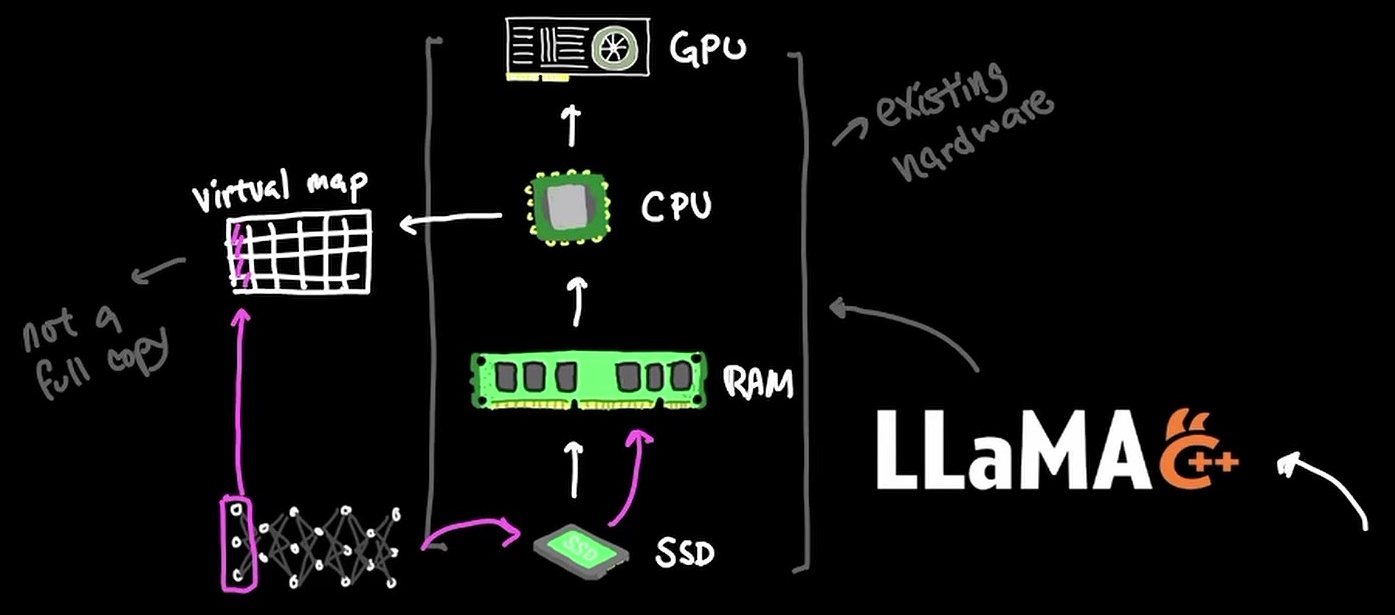
图 4:文件页、虚拟映射与内存层次示意,”not a full copy”指不再有另一份完整的用户态副本。(视频 03:31–03:53)
带来的好处:
- 启动快:映射几乎是瞬间完成的,权重在第一次被访问时才真正读入;
- 多进程共享:多个进程映射同一个模型文件,物理内存里只有一份;
- 重启快:进程退出后文件页还留在页缓存里,再次启动基本不用重新读盘。
mmap 不会让模型不占内存:被访问的页必须驻留在物理 RAM 里才能被 CPU 使用 [4]。如果模型比可用内存还大,操作系统会不停地换入换出页面,推理速度会被磁盘 I/O 拖垮。SSD 容量够大,不代表推理速度够快。llama.cpp 也提供 --no-mmap(一次性读入)和 --mlock(锁住页面防止被换出)两个开关。
mmap 管的是数据怎么加载,CPU/GPU 混合执行管的是计算放在哪里,两者都服务于”用已有设备把模型跑起来”这个目标。
三、vLLM:把 KV cache 管好,才能服务更多请求
瓶颈从权重转移到请求状态
视频在 05:05 回到 vLLM。权重可以被所有请求共享,KV cache 却随每个请求的上下文增长:一个用户生成 50 个 token,另一个生成 500 个,需要的缓存长度差了十倍。几十上百个用户同时访问时,怎么分配这些大小不一、还在不断变长的缓存,就成了核心问题。
vLLM 原论文给了一个例子:在 A100 40 GB 上跑 13B 模型,参数占约 26 GB(65%),KV cache 占 30% 以上,剩下的是激活等 [5]。
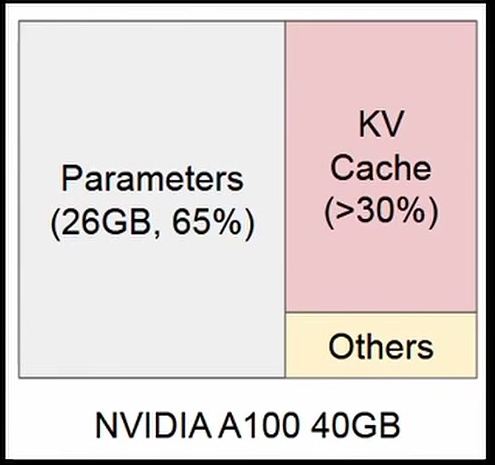
图 5:vLLM 论文中的 A100 40 GB 显存构成:参数约 26 GB(65%),KV cache 超过 30%。比例对应论文的 13B 模型示例。(视频 05:40–05:58)
KV cache 的大小可以这样估算(标准 Transformer,完整注意力):
\[M_{\text{KV}} \approx 2 \cdot L \cdot B \cdot T \cdot H_{\text{KV}} \cdot D_h \cdot s\]- $2$:Key 和 Value 各一份;
- $L$:层数;
- $B$:同时驻留的序列数;
- $T$:每条序列已缓存的 token 数(输入加已生成);
- $H_{\text{KV}}$:KV 头的数量。MHA 下等于 query 头数,GQA 下更少,MQA 下为 1;
- $D_h$:每个头的维度;
- $s$:每个元素的字节数,FP16 为 2。
推导很直接:每层的 K 缓存形状是 [B, H_KV, T, D_h],V 也一样,元素个数乘以字节数,再乘 2 和层数 [10]。
代入一组 Llama-3-8B 量级的配置:$L=32$,$H_{\text{KV}}=8$(GQA),$D_h=128$,$s=2$:
- 每个 token:$2 \times 32 \times 8 \times 128 \times 2 = 131072$ 字节 $= 128$ KiB;
- 一条 8192 token 的会话:$128\ \text{KiB} \times 8192 = 1$ GiB;
- 16 条这样的会话并发:16 GiB。
8B 模型 FP16 权重约 16 GB,16 条 8K 会话的 KV cache 就和权重一样大了。如果是 MHA($H_{\text{KV}}=32$),还要再乘 4。这就是为什么高并发服务里,KV cache 而不是权重,才是显存的主要矛盾。
连续大块预分配为什么浪费
早期系统的做法是:为每个请求按最大可能长度预留一块连续的显存。问题在于输出长度事先不知道:
- 预留浪费:按 2048 token 预留,结果只生成了 100 个,剩下的空间被占着没用;
- 内部碎片:分配粒度大于实际需要,块内有空位;
- 外部碎片:请求不断进入、结束,空闲空间被切成大小不一的小段,新的大请求放不进去。
vLLM 论文测量发现,现有系统中只有 20%–38% 的 KV cache 空间真正存了 token 状态,60%–80% 被浪费在碎片和过度预留上 [5]。
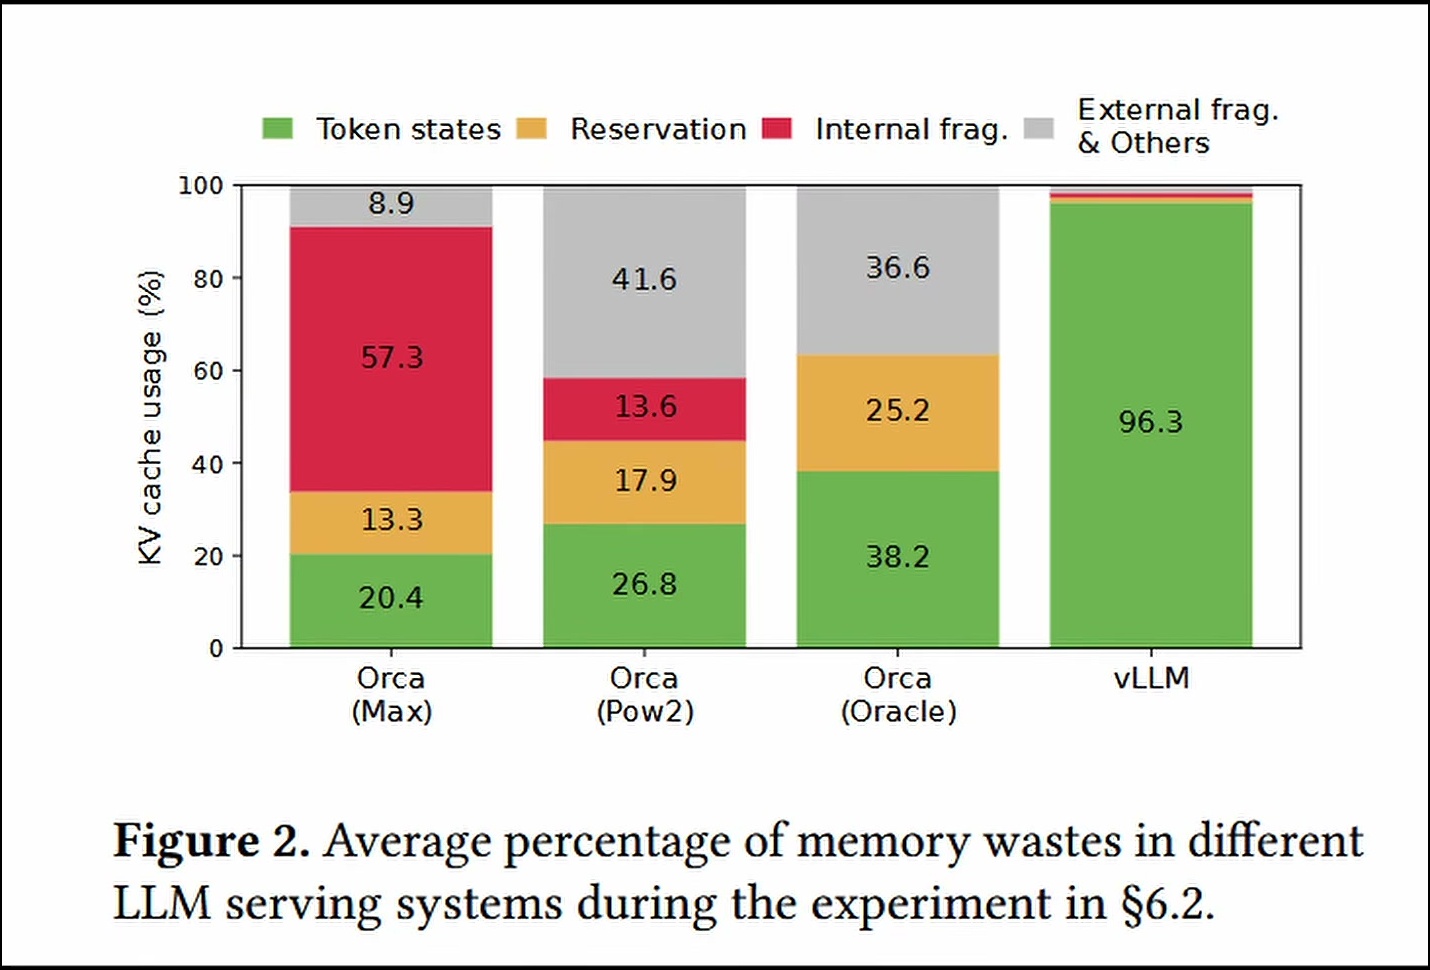
图 6:vLLM 论文实验中的 KV cache 空间构成:绿色为实际 token 状态,黄色为预留,红色为内部碎片,灰色为外部碎片。(视频 06:16–06:26)
这个比例是论文对 2023 年当时的基线系统(FasterTransformer、Orca)测出来的。
PagedAttention:逻辑上连续,物理上分散
vLLM 的解法借鉴了操作系统的虚拟内存分页。把 KV cache 切成固定大小的块(block),每块存固定数量 token 的 K 和 V;为每个请求维护一张块表,记录”第几个逻辑块对应哪个物理块”。注意力内核计算时,通过块表找到数据所在的物理位置。
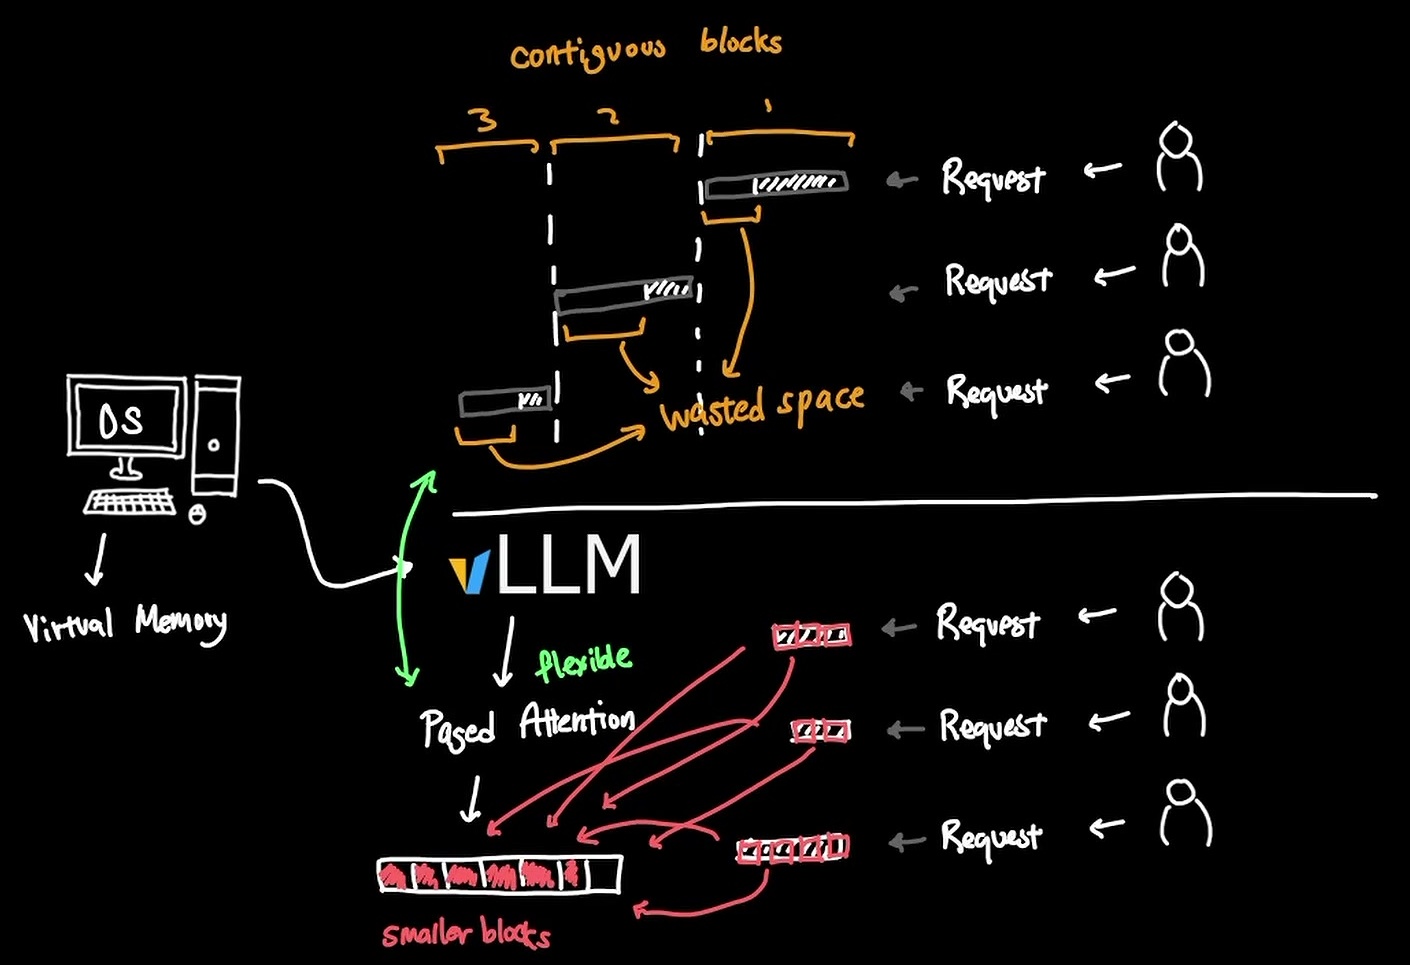
图 7:上方是连续空间预留造成的浪费,下方是较小的物理块和请求映射,逻辑序列可以对应分散的物理块。(视频 06:26–06:46)
举个例子:块大小为 16 个 token,一个请求当前有 33 个 token,需要 $\lceil 33/16 \rceil = 3$ 个块,最后一块只用了 1 个位置。浪费最多就是最后一块里的 15 个位置,不用再为未知的最大长度一次性预留整段空间。请求每多生成 16 个 token,再申请一个新块。
块表还让共享变得容易:并行采样(同一个 prompt 生成多个回答)、beam search 时,多个序列可以指向同一组物理块,写入时再复制(copy-on-write)。
按论文的结果,vLLM 在相同延迟下的吞吐是 FasterTransformer 和 Orca 的 2–4 倍 [5]。
llama.cpp 的 mmap 和 vLLM 的 PagedAttention 都借鉴了虚拟内存,但对象不同:前者管的是模型文件页和进程地址空间,由操作系统执行;后者管的是 KV cache 的逻辑块和 GPU 显存里的物理块,由 vLLM 自己的块管理器和注意力内核执行。PagedAttention 不会把 KV cache 放到 SSD 上。
连续批处理:一个请求结束,马上补一个新的
省下来的显存要能转化成更多的并发,还需要调度器配合。视频在 06:48–07:02 介绍了 continuous batching(也叫 in-flight batching、iteration-level scheduling)。
传统的静态批处理是:一批请求一起开始,等最慢的那个生成完,整批才结束,下一批才能进来。短请求早就生成完了,却只能干等。
连续批处理在每一次 decode 迭代的边界检查:已经结束的请求移出批次,排队中的新请求立即补进来。
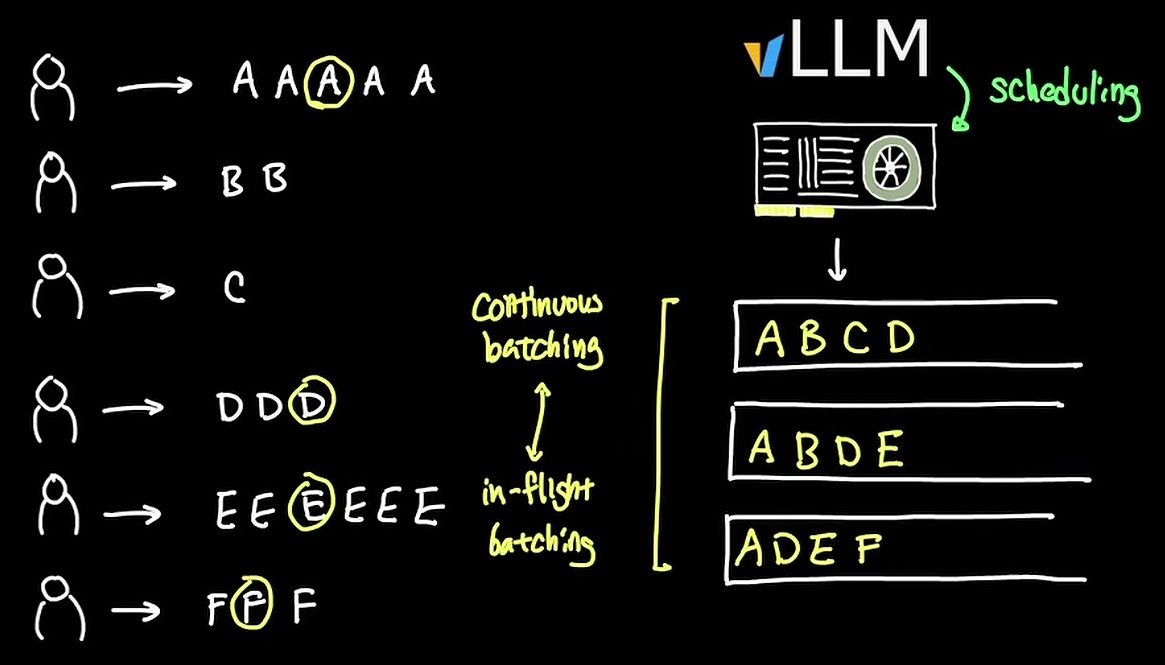
图 8:批次从 ABCD 变为 ABDE,再变为 ADEF,已结束的请求退出,新请求进入后续的生成迭代。(视频 06:48–07:02)
PagedAttention 解决缓存怎么存,连续批处理解决请求怎么进出,两者是配合使用的不同机制。连续批处理最早由 Orca 论文提出 [12],现在各家引擎都支持,并不是 vLLM 独有。
吞吐提升不等于每个请求的首 token 延迟(TTFT)都下降:新请求进来要做 prefill,会和正在 decode 的请求抢算力。这就是后来 chunked prefill 和 PD 分离要解决的问题。
对应的 vLLM 参数:
# --gpu-memory-utilization:vLLM 可用的显存比例,扣掉权重后剩下的都给 KV cache 块
# --block-size:每个 KV 块容纳的 token 数
# --max-num-seqs:一次迭代最多同时调度的序列数,即连续批处理的批大小上限
# --max-model-len:单个请求的最大上下文长度
vllm serve meta-llama/Llama-3.1-8B-Instruct \
  --gpu-memory-utilization 0.90 \
  --block-size 16 \
  --max-num-seqs 256 \
  --max-model-len 8192
启动日志会打印这张卡的 KV cache 最多能容纳多少 token(旧版本打印 # GPU blocks: N,乘以 block size 得到 token 数;V1 引擎直接打印 GPU KV cache size: N tokens)。用上面的 KV 公式反推,可以检查显存是否按预期分配。
四、SGLang:共享前缀,减少重复 prefill
请求不同,开头可能一样
视频从高并发场景引出另一个观察:很多请求的开头是一样的。最简单的例子是系统提示”You are a helpful assistant”,后面才是各自的问题。实际场景中更常见的是:
- 同一个应用的所有请求带着相同的角色设定和工具定义(agent 的 system prompt 动辄几千 token);
- 多轮对话中,每一轮都要重新提交完整的历史;
- 针对同一篇长文档提出不同的问题;
- few-shot 示例对所有请求都一样。
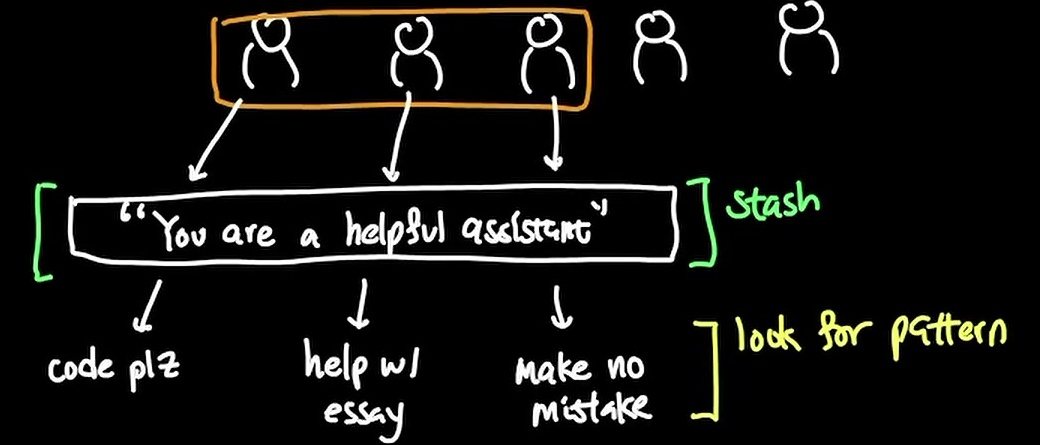
图 9:多个请求共享同一个助手前缀,后面分别要求写代码、帮忙写作文、避免错误。(视频 07:28–07:44)
这些相同的 token 前缀,在每个请求里算出来的 KV cache 完全一样。如果能缓存下来复用,新请求只需要对后面不同的部分做 prefill。
RadixAttention:用基数树组织可复用的缓存
SGLang 用一棵 radix tree(基数树)来组织所有请求的 KV cache [6]:
- 树的每条边是一段 token 序列,对应一段 KV cache;
- 共同前缀落在共享的路径上,后续不同的内容在分叉处形成分支;
- 新请求进来时,沿着树查找最长匹配前缀,命中的部分直接复用,从分叉点开始计算;
- 显存不够时,按 LRU 策略淘汰没有被活跃请求引用的叶子节点,仍在使用的共享路径会被保留。
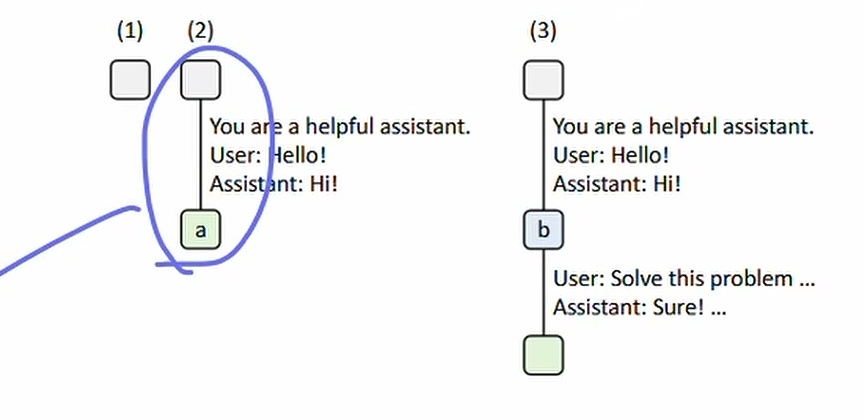
图 10:已缓存的对话前缀可供后续问题复用,新增内容继续扩展路径。(视频 07:55–08:04)
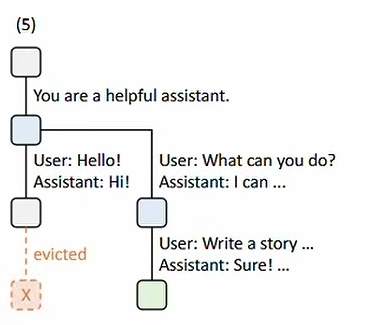
图 11:共享路径形成分支,容量不足时淘汰不再需要的末端节点,图中以虚线和 evicted 标记。(视频 07:44–07:55)
原论文还提出了缓存感知调度:把等待队列里的请求按匹配前缀长度排序,优先调度能复用最多缓存的请求,提高命中率 [6]。SGLang 本身也是一个结构化 LLM 程序的前端语言,RadixAttention 是它运行时的一部分。
复用的是完全相同的 token 序列产生的 KV cache,不是语义相似。差一个 token,从那个位置往后就无法复用。另外,前缀缓存省掉的是 prefill 的计算,后续每一步 decode 照样要读取完整的 KV(包括复用的那部分)来做注意力,长回答的 decode 开销不会因此减少。
收益有多大
视频引用了”最高 6.4 倍吞吐”,并马上补充:取决于工作负载。这个数字来自 SGLang 论文,指的是特定评测(few-shot、agent、多轮对话、树状推理等前缀复用很多的任务)下,整个 SGLang 系统相对当时基线的最大端到端吞吐提升,单位是”程序实例/秒”,包含了多次模型调用和并行等系统设计的综合效果 [6]。如果请求之间几乎没有共同前缀,或者缓存频繁被淘汰,收益会很小。
vLLM 现在也有 Automatic Prefix Caching,实现方式是对每个 KV 块的内容做哈希 [7]。前缀缓存已经是各家的标配,区别在实现:树结构 vs 块哈希,以及调度策略。
对应参数:
# SGLang:RadixAttention 默认开启;--schedule-policy lpm 启用最长前缀匹配优先调度
# (核对时默认值为 fcfs);--mem-fraction-static 控制权重加 KV 池占显存的比例
python -m sglang.launch_server \
  --model-path meta-llama/Llama-3.1-8B-Instruct \
  --schedule-policy lpm \
  --mem-fraction-static 0.85

# vLLM:显式开启自动前缀缓存
vllm serve meta-llama/Llama-3.1-8B-Instruct --enable-prefix-caching
评测前缀缓存时,要分别看 TTFT(prefill 被省掉的部分主要体现在这里)、每 token 生成延迟(TPOT)和整体吞吐,以及缓存命中率。
五、TensorRT-LLM:沿着 NVIDIA 的软硬件栈往下挖
硬件厂商为什么也做推理软件
视频把 NVIDIA 的推理软件史串了起来:TensorRT(最早叫 GIE,GPU Inference Engine)、FasterTransformer,再到 2023 年的 TensorRT-LLM。NVIDIA 同时掌握硬件指令、内存层次和软件执行路径,可以把计算内核、精度选择(FP8、FP4)、缓存管理和多 GPU 执行一起针对自家平台优化。
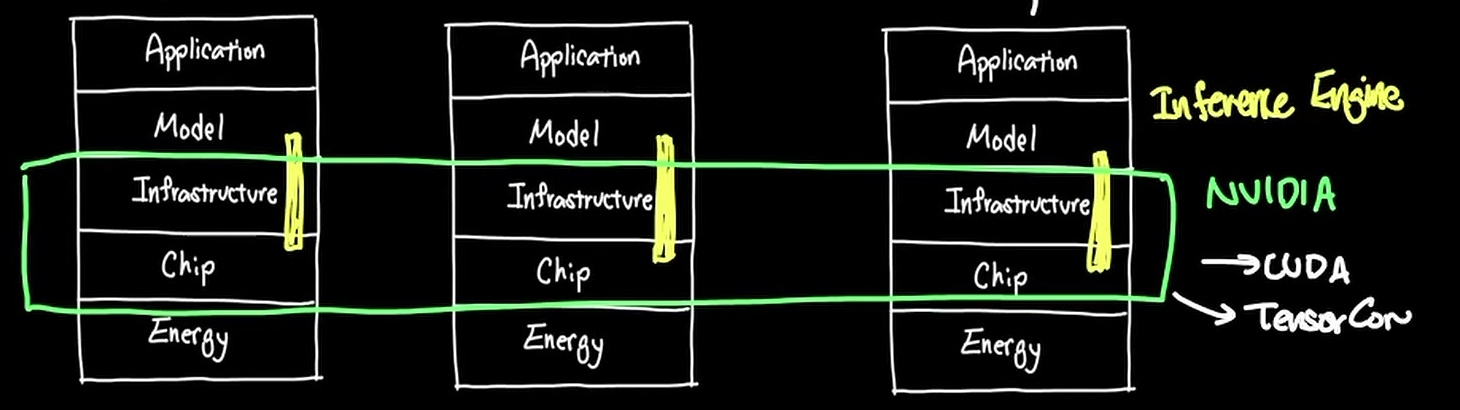
图 12:NVIDIA 贯穿基础设施与芯片层,右侧标出 CUDA 和 Tensor Core。(视频 08:39–08:57)
视频把 TensorRT 的起点简化为 2017 年,实际上 NVIDIA 在 2016 年就已经用了这个名字,2017 年发布的是 TensorRT 3 [8]。
总拥有成本
这条路线的卖点是总拥有成本(TCO):同样的硬件,如果在满足延迟目标的前提下能处理更多请求,每个有效 token 的成本就更低。
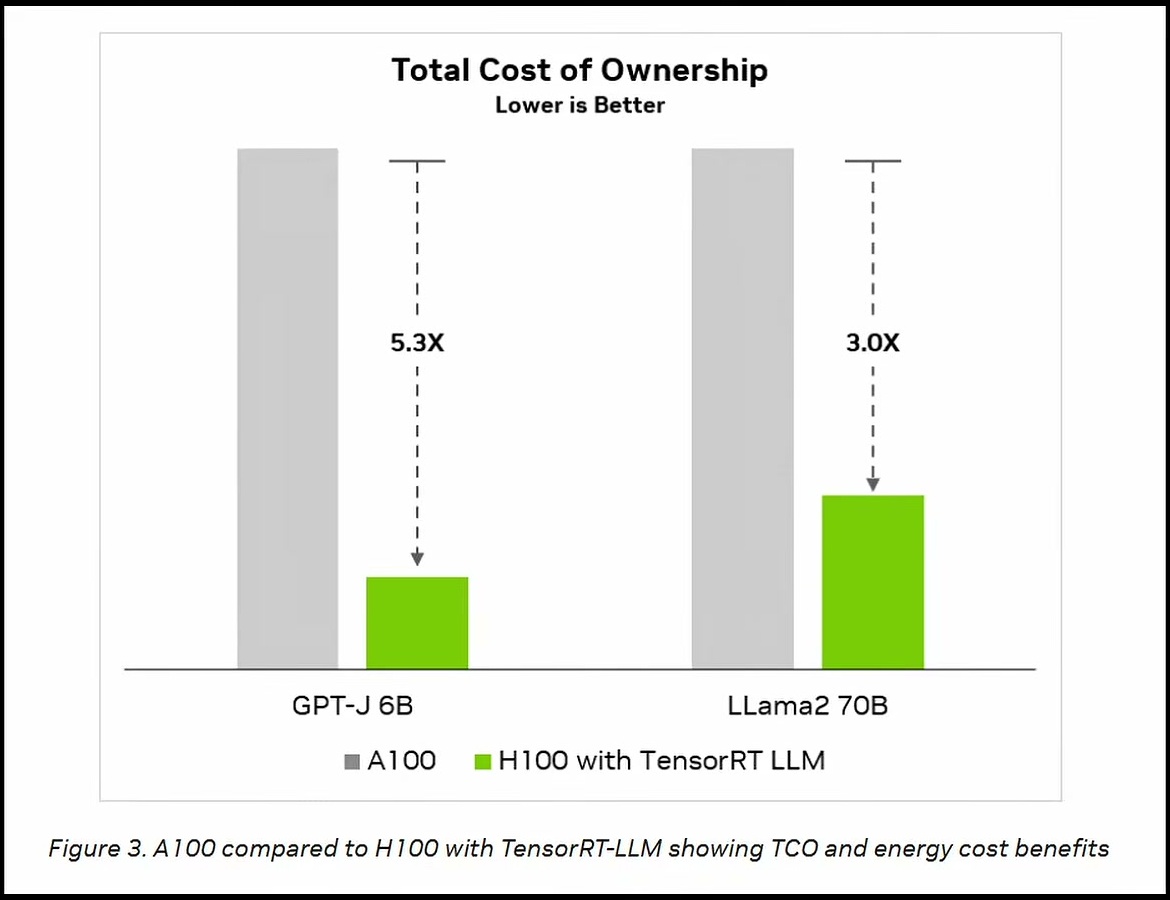
图 13:视频引用的 TCO 图,比较 A100 与 H100 + TensorRT-LLM,标出 5.3 倍和 3.0 倍的改善。这里硬件和软件同时换了,收益是两者叠加的结果。(视频 08:57–09:09)
真实成本还取决于能耗、利用率、开发和维护成本。TensorRT-LLM 的收益要看具体模型是否被充分支持、精度是否满足质量要求、内核是否适配当前 GPU、多卡通信和调度是否成了新瓶颈。跟平台绑得越深,越要关注版本和支持矩阵。
TensorRT-LLM 的工作流也变了。早期需要先把 Hugging Face 权重转换成 checkpoint,再用 trtllm-build 离线编译成 TensorRT engine。当前版本已经移除了 TensorRT engine 后端,PyTorch 成为唯一后端,可以直接加载 Hugging Face 权重 [9]:
trtllm-serve meta-llama/Llama-3.1-8B-Instruct
网上很多 convert_checkpoint.py + trtllm-build 的教程对应的是旧版本,照着做之前先确认版本。
六、总结:从引擎的名字回到工作负载
功能趋同
视频 09:09 之后的结论是:这些项目起初各有优化目标,发展多年后功能越来越像。今天几乎每个主流引擎都有分页 KV、连续批处理、前缀缓存、量化、FlashAttention、融合内核、TP/PP、投机解码和 chunked prefill。
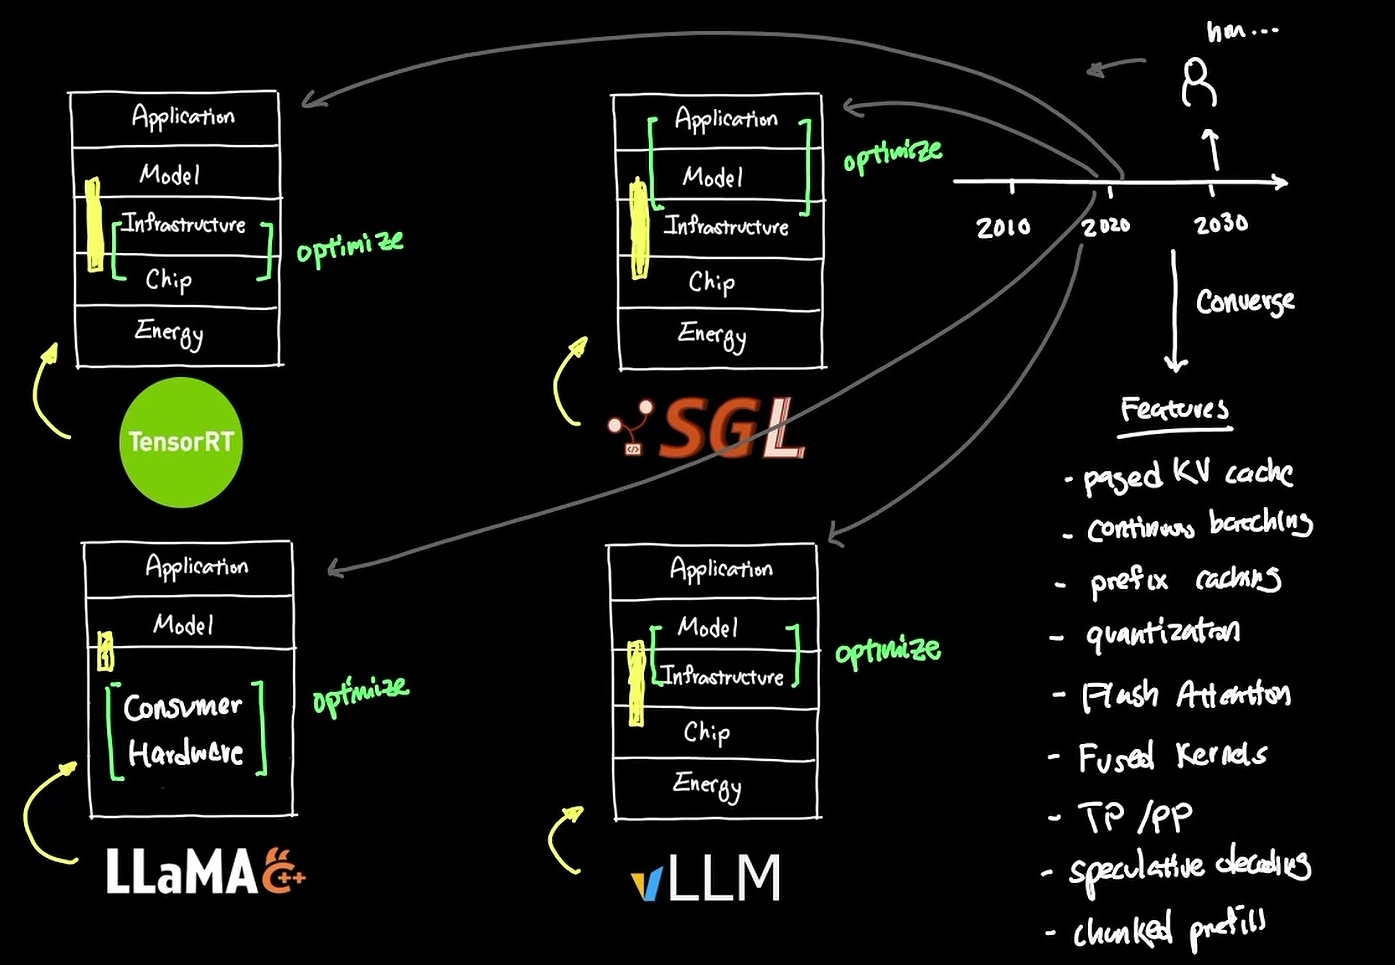
图 14:讲者总结的功能趋同:分页 KV、连续批处理、前缀缓存、量化、FlashAttention、融合内核、TP/PP、投机解码与分块 prefill。后五项视频没有展开。(视频 09:22–09:40)
讲者最后强调需求还在变:Agent 需要长时间运行、多步交互;模型架构越来越复杂,需要专用内核(视频举了 DeepSeek、Kimi、Meta、MiniMax 等例子,比如 MLA、稀疏注意力、超大 MoE)。这些都会持续给推理引擎施加新压力。所以关键能力是看懂瓶颈在哪里,以及系统用什么架构改动来缓解它。
选型时的检查步骤
- 记录约束:设备、显存/内存、模型结构(层数、KV 头数、是否 MoE)、权重精度、预期上下文长度和并发量。先用上面两个公式算出权重占用和 KV cache 占用。
- 描述请求:输入和输出长度的分布、共同前缀的比例、请求到达速率、是否有 agent 式的多步交互。
- 分开测量:TTFT、TPOT、吞吐、显存峰值分别看。对比不同引擎时保持模型、硬件、量化方式、请求分布一致。
- 定位瓶颈:
- 装不下:检查精度和权重放置(量化、
-ngl、TP 切分); - KV cache 膨胀、并发上不去:检查分页和并发参数(
--max-num-seqs、--gpu-memory-utilization); - 前缀大量重复:检查前缀缓存是否开启、命中率多少;
- GPU 利用率低:检查批大小、内核选择和调度策略。
- 装不下:检查精度和权重放置(量化、
- 固定版本复测:新模型架构或新版本可能改变最优执行路径,不要拿两年前的结论直接套用。
几个可以继续追的问题:前缀缓存命中率上去之后,瓶颈会不会转到 decode?量化压缩了权重之后,并发的 KV cache 会不会变成主要限制(这时候 KV cache 量化、MLA 这类结构就有价值了)?合批带来的吞吐,是否还满足交互式场景的延迟要求?
参考
[1] Caleb Writes Code,Inference Engines explained in 10min..,YouTube,2026-09-30。本文叙述主线与截图取自该视频,截图时间区间为视频内时间码。
[2] PyTorch Team,Accelerating Generative AI with PyTorch II: GPT, Fast,2023。
[3] ggml-org,llama.cpp,GitHub;GGUF 文件格式规范。
[4] Apple,About the Virtual Memory System,2013;Linux Kernel Documentation,Page Cache。
[5] Woosuk Kwon et al.,Efficient Memory Management for Large Language Model Serving with PagedAttention,SOSP 2023,arXiv:2309.06180;vLLM Team,vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention,2023-06-20。
[6] Lianmin Zheng et al.,SGLang: Efficient Execution of Structured Language Model Programs,NeurIPS 2024,arXiv:2312.07104。
[7] vLLM,Automatic Prefix Caching;Prefix Caching 设计文档。
[8] NVIDIA,Production Deep Learning with NVIDIA GPU Inference Engine,2016;TensorRT 3: Faster TensorFlow Inference and Volta Support,2017。
[9] NVIDIA,TensorRT Backend Removal Migration Guide;TensorRT-LLM Overview。
[10] Hugging Face,Cache explanation;Llama 模型配置。
[11] SGLang,Server Arguments。
[12] Gyeong-In Yu et al.,Orca: A Distributed Serving System for Transformer-Based Generative Models,OSDI 2022。