讲 MoE 执行流程的材料里,常能看到这样一条链:token 先发到专家所在的 GPU,做两次矩阵乘加一次激活,结果再传回原来的 GPU。EP(Expert Parallelism,专家并行)解释了为什么要跨卡,可光看这条链,看不出通信是怎么被计算盖住的。
DeepGEMM 的 MegaMoE 把 EP Dispatch、Linear 1、SwiGLU、Linear 2 和 EP Combine 放进同一个 mega-kernel,让 NVLink 通信和 Tensor Core 计算重叠起来。[1] 问题也就来了:同一个 token 明明必须先收到、再计算、再回传,重叠究竟发生在哪里?
下面先跟住一个 token,再展开专家内部的矩阵形状,最后顺着源码看不同数据块怎么同时推进。本文基于 2026-10-14 阅读的 DeepGEMM 版本 1fc9c66975ee322d628b3288534ca0e9ce12a64d,分析其中 NVIDIA SM100 的 FP8×FP4 / FP8×FP8 路径;三张图都是教学示意。
1. 先跟住一个跨卡的 token
假设两张 GPU 上一共放了四个路由专家,每个 token 选两个专家,专家内部先不做 TP:
| GPU / rank | 持有的完整专家权重 |
|---|---|
| GPU 0 | 专家 0、专家 1 |
| GPU 1 | 专家 2、专家 3 |
GPU 0 上有一个 token,hidden 向量为 $x_0$,路由选中了专家 2 和专家 1,权重分别是 0.6 和 0.4。这一层路由专家的输出就是:
\[y_0=0.6f_2(x_0)+0.4f_1(x_0).\]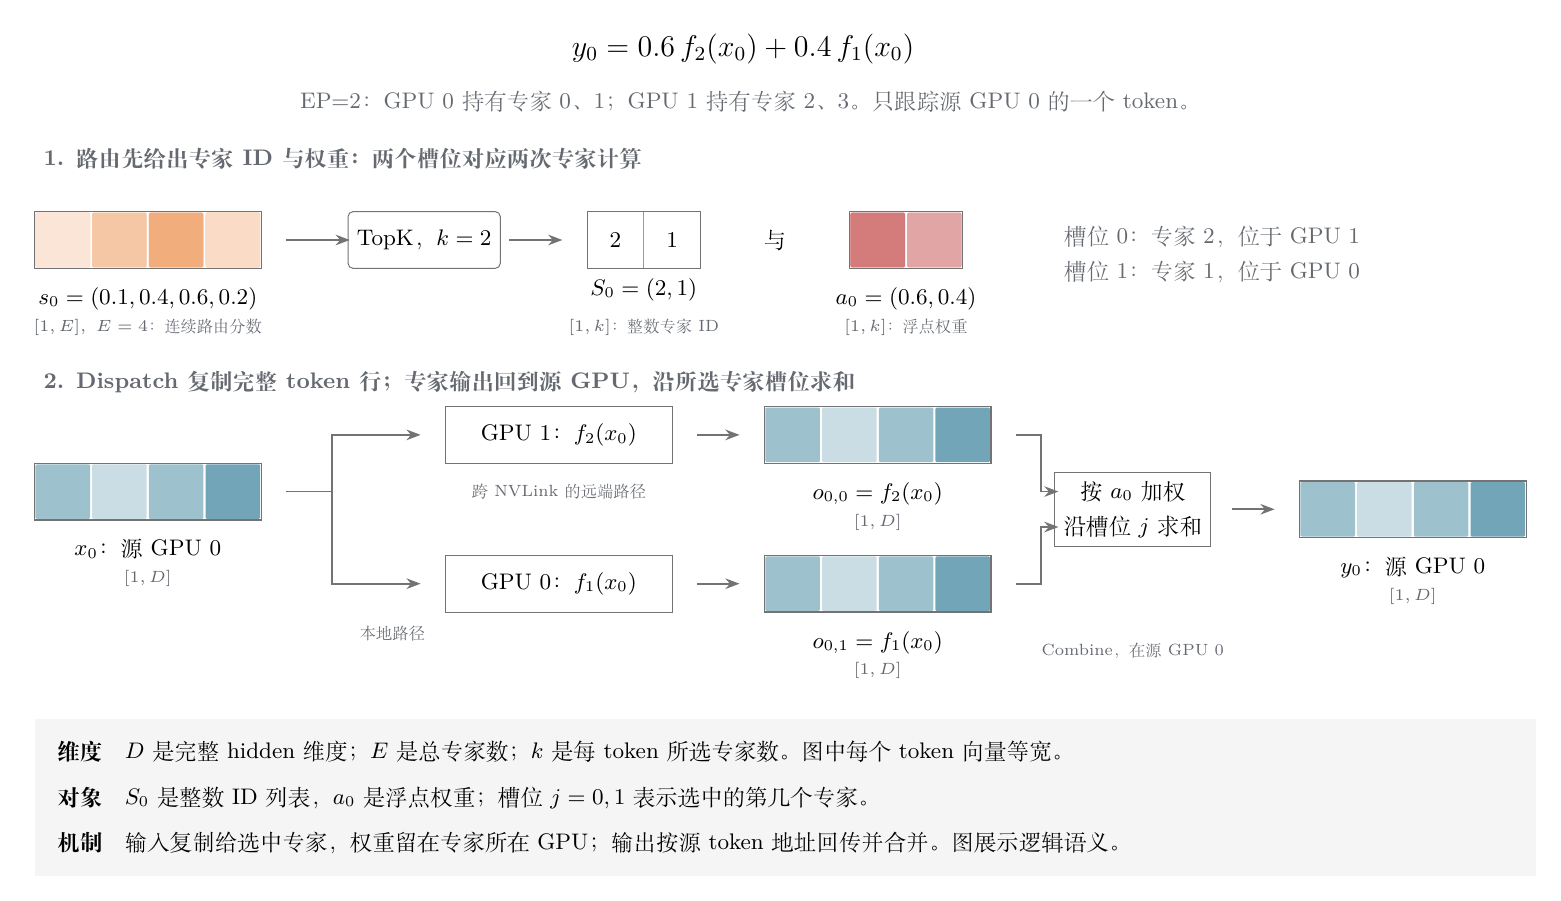
图里连续的路由分数经过选择,得到整数专家 ID 列表 $S_0=(2,1)$,以及和两个槽位一一对应的浮点权重 $a_0=(0.6,0.4)$。专家 2 在 GPU 1 上,所以完整的 $x_0$ 要送过去;专家 1 就在 GPU 0,走本地路径即可。两边各自用本地的专家权重算完,远端的输出传回 GPU 0,最后按路由权重归并。
这条路径上来回移动的只有 token 激活和专家输出,专家权重早就放在对应的 GPU 上,不会跟着每个 token 搬来搬去。EP 切的是专家集合,所以每次专家计算拿到的仍是完整的 hidden 向量。另外,一个 token 选中的两个专家也可能刚好都在 GPU 0,所以 Top-k 数量不能直接当成跨卡次数。[2][4]
当然,每张 GPU 同时也有自己的源 token。图里只追了 GPU 0 的一行,实际执行时是多个 rank 互相收发,构成 EP 的 all-to-all 数据交换。MegaMoE 在内核里完成这整条数据路径,图中的每根箭头并不对应一次单独的通信库调用。
2. 到了专家那里,两次矩阵乘在算什么?
把单个 token 扩展成一批。设 EP group 有 $P$ 个 rank、共 $E$ 个路由专家,均匀放置时每个 rank 持有 $E/P$ 个专家。源 rank $r$ 本轮有 $T_r$ 个 token,接口附近最重要的几块数据如下:
| 对象 | 每个源 rank 上的逻辑形状 | 含义 |
|---|---|---|
| $X^{(r)}$ | $[T_r,D]$ | token hidden 向量;本文路径输入为 FP8,另带缩放因子 |
$S^{(r)}$ / topk_idx |
$[T_r,k]$ | int64 专家 ID |
$a^{(r)}$ / topk_weights |
$[T_r,k]$ | FP32 路由权重,与所选专家槽位配对 |
| $Y^{(r)}$ | $[T_r,D]$ | Combine 后的 BF16 输出 |
topk_idx 的第二轴表示“选中的第几个专家”,和 hidden 通道无关。Dispatch 按专家 ID 聚集 $X$ 的行,同时还得记下源 rank、源 token 序号和 Top-k 槽位,不然专家算完了,也不知道结果该送回哪一行、填进哪个贡献槽位。[2][4]
专家 $e$ 从各个源 rank 一共收到 $M_e$ 行,拼成 $X_e\in\mathbb R^{M_e\times D}$。先按普通的 SwiGLU 专家把计算写出来:
\[[G_e\mid U_e]=X_eW_{1,e},\qquad A_e=\operatorname{SiLU}(G_e)\odot U_e,\qquad O_e=A_eW_{2,e}.\]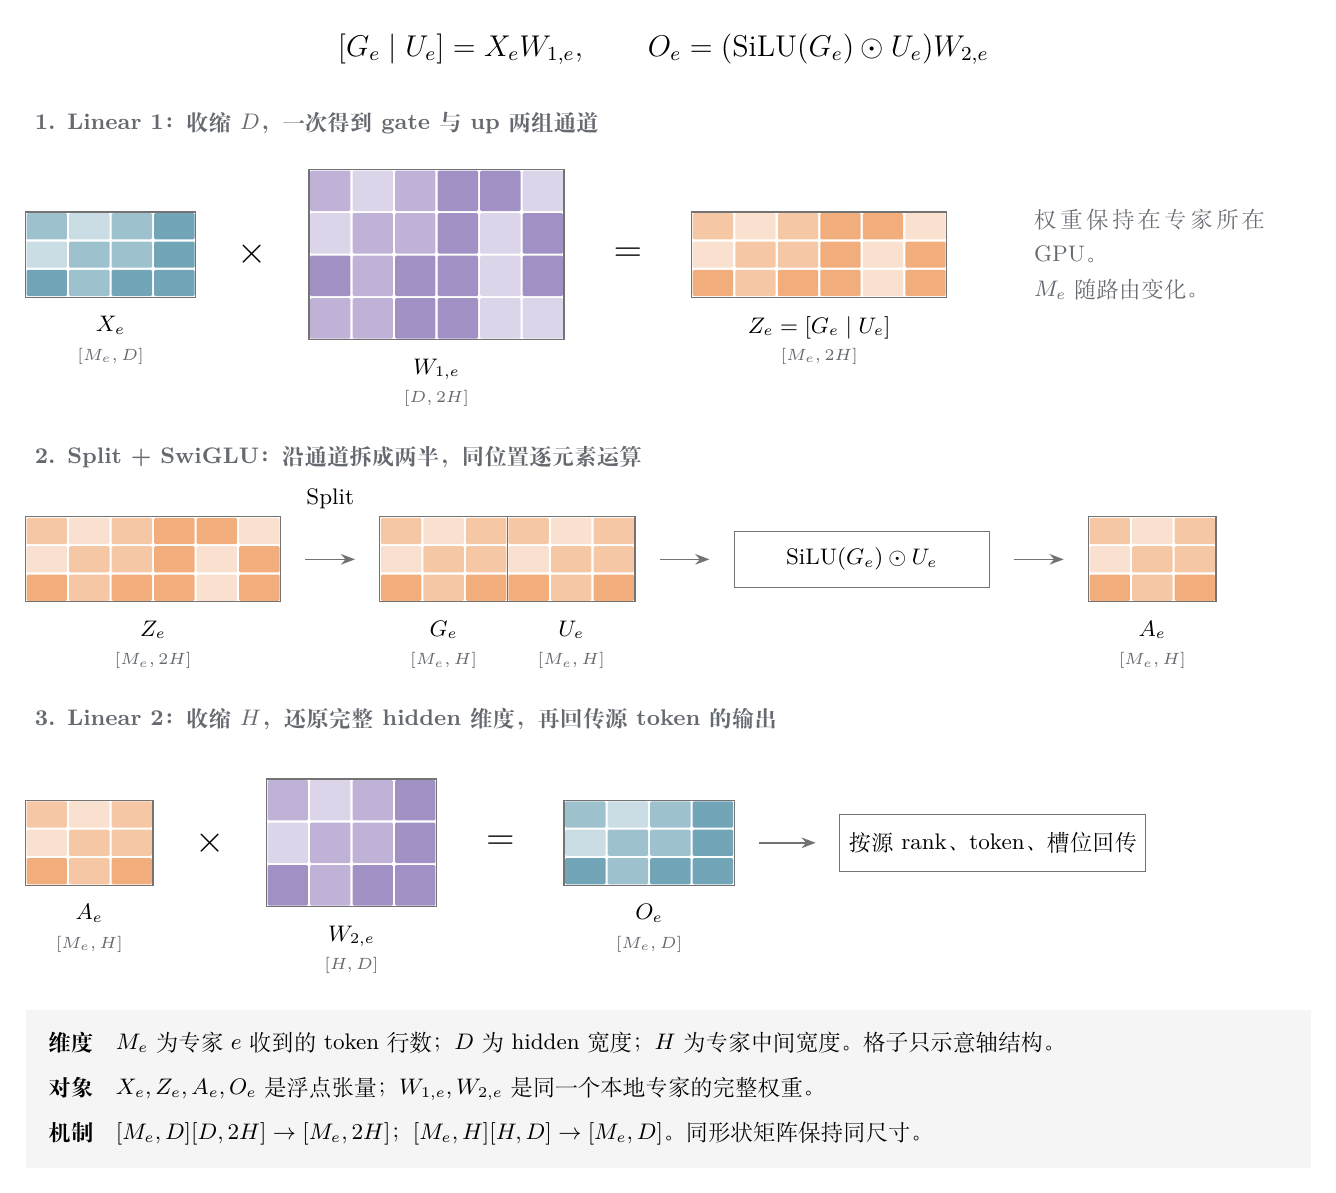
第一次矩阵乘把 $D$ 维输入投影到 $2H$ 维,再沿通道拆成 gate 和 up 两半,各为 $[M_e,H]$。gate 过一遍 SiLU 后和 up 逐元素相乘,得到 $A_e$;第二次矩阵乘再把 $H$ 维投影回 $D$ 维:
X_e [M_e,D] × W_1,e [D,2H] → Z_e [M_e,2H]
Z_e 沿通道拆分              → G_e、U_e,各 [M_e,H]
SiLU(G_e) ⊙ U_e            → A_e [M_e,H]
A_e [M_e,H] × W_2,e [H,D]  → O_e [M_e,D]
$D$ 是模型的 hidden 宽度,$H$ 是专家的中间宽度,$M_e$ 则随每轮路由变化。如果每个 token 都有 $k$ 个有效且互不相同的专家,不算 padding 和 shared expert,就有:
\[\sum_{e=0}^{E-1}M_e=k\sum_{r=0}^{P-1}T_r.\]左边是各专家收到的行数之和,右边是各源 rank 的 token 数乘上 Top-k,两边数的都是“token—专家对”。同一行输入可以参与多次专家计算,但在这个 EP 示例里,它的 $D$ 个通道始终放在一起。
图里用的是逻辑上右乘权重的写法。实际接口还涉及转置、gate/up 交错排列和量化缩放布局,要靠 transform_weights_for_mega_moe 等准备函数转换。源码里还有 activation clamp 之类的数值处理,上面的公式只用来说明张量关系,这些选项就不展开了。[1][2][5]
路由权重乘在哪一步,也有个容易忽略的差别。图 1 按数学定义画成“专家输出回来后再加权”,而当前内核是在 SwiGLU 之后就把路由权重乘进激活,再做 Linear 2。[2] 对某一行来说,权重 $a$ 是标量,忽略量化和舍入的话:
\[(aA_e)W_{2,e}=a(A_eW_{2,e}).\]所以写回源 rank 的已经是加权后的贡献,最终归并只要相加就行。不过量化位置和浮点舍入仍可能带来数值差异。
3. 从整批等待改成块级推进
如果按阶段整批执行,流程很直观:等 Dispatch 全部完成,再算所有专家,最后 Combine。问题是,专家 rank 哪怕已经收到了一部分输入,也得等阶段切换后才能开算。
MegaMoE 的融合范围覆盖了这整条主体路径:[1]
┌──────────────────── 同一个 mega-kernel ────────────────────┐
│ EP Dispatch → Linear 1 → SwiGLU → Linear 2 → EP Combine     │
└────────────────────────────────────────────────────────────┘
路由得到的专家 ID 和路由权重、输入量化、权重转换,仍由调用方事先准备好。进了内核之后,各阶段以数据块为单位交换就绪状态,输入依赖已经满足的工作就可以先往前走。
把输入切成三块,记第 $i$ 块的输入接收为 $D_i$、专家计算为 $C_i$、结果回传为 $R_i$。同一块内部的依赖没有变:
\[D_i\rightarrow C_i\rightarrow R_i.\]重叠发生在块与块之间:第 2 块在计算的时候,第 3 块可以继续接收,第 1 块的输出贡献可以回传。
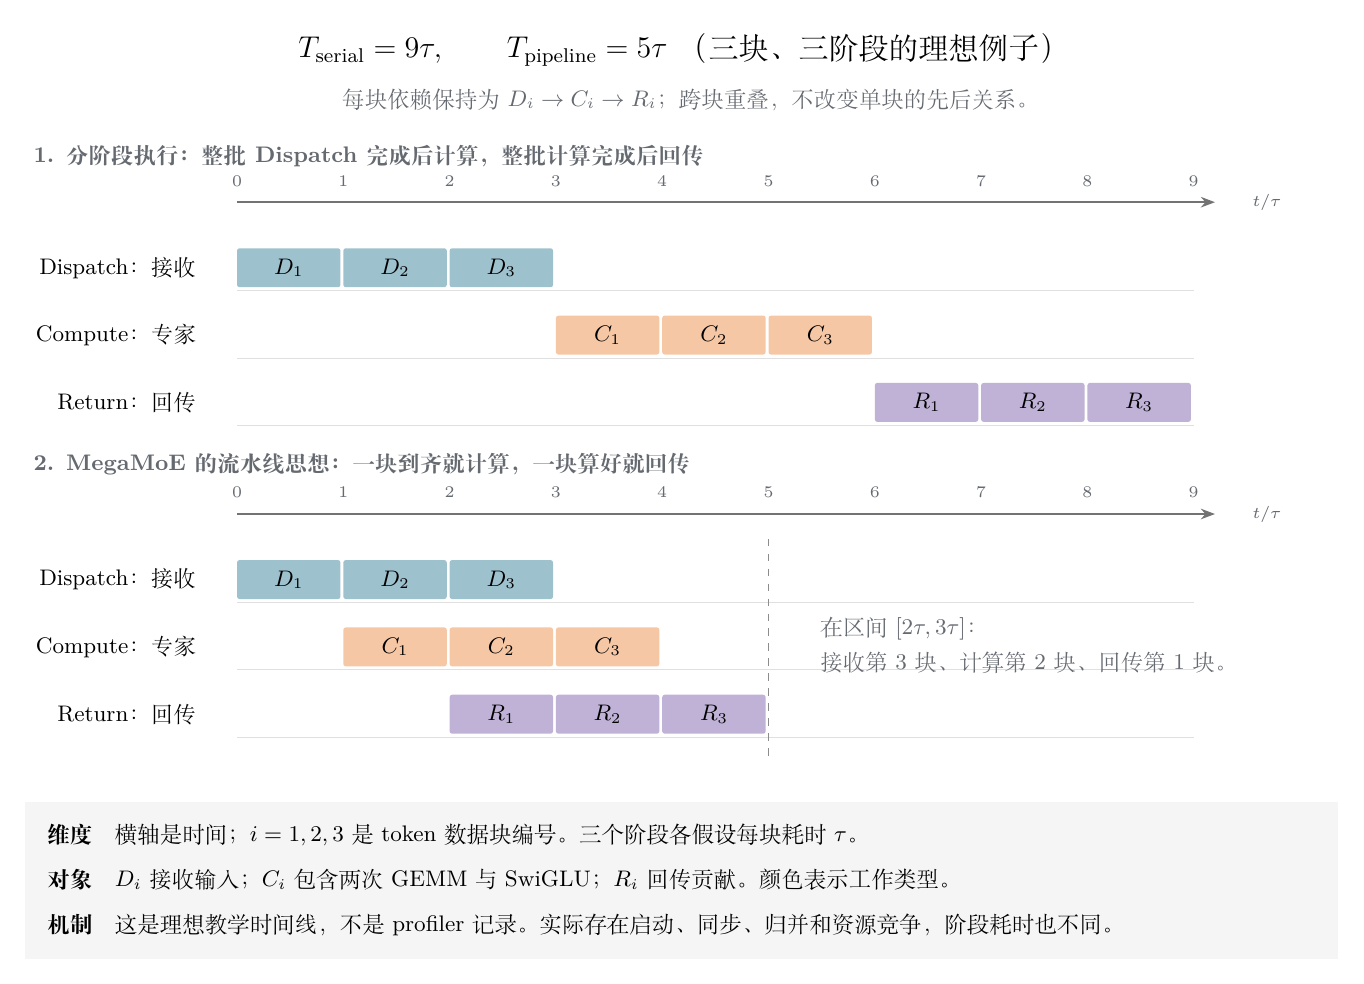
图中假设三个阶段各有可并行的资源,每块每阶段都耗时 $\tau$。分阶段整批执行要 $9\tau$;换成流水线,启动后每隔 $\tau$ 推进一块,三块一共 $5\tau$。9 和 5 是按教学模型手算的,图里也没算最终归并和同步,不能当成 MegaMoE 的实测加速比。
实际的计算比图里的 $C_i$ 更细。Linear 1 和 Linear 2 都会拆成矩阵 tile,GPU 上的 scheduler 先安排一定数量的 Linear 1 任务预热,再交错安排后续任务。预热还有一个作用是避免调度死锁:如果太早安排了等待 Linear 1 结果的 Linear 2 任务,而负责产出这些结果的任务还没轮到执行,流水线就可能卡住。[3]
两次 GEMM 共用同一组 Tensor Core,交错调度不会让它们各自占满硬件同时跑。它要隐藏的是等输入、搬数据这些空隙,让通信和计算资源尽量都有活干。
融合还省掉了分阶段启动 kernel、交接状态的开销。但中间数据照样要进缓冲区,跨 CTA(线程块)、跨 GPU 的协作也照样离不开计数器、内存可见性控制和同步。[2–4]
4. 源码里,谁负责搬数据,谁负责算?
打开 sm100_fp8_fp4_mega_moe.cuh,从 Different warp roles 往下读,能看到内核按职责给 warp 分工。warp 是 GPU 内的一组线程,下面这些角色都在单张 GPU 内部协作。[2]
| 线程职责 | 主要工作 | 要等待什么 |
|---|---|---|
| Dispatch warps | 统计路由、交换元数据、拉取 token 和缩放因子 | 路由元数据、远端输入、可复用槽位 |
| Scheduler warp | 安排专家的 Linear 1 / Linear 2 tile | 专家 token 数、调度计数、阶段依赖 |
| TMA load warps | 异步加载激活、权重和缩放因子 | 对应数据块就绪、shared memory 空位 |
| MMA issue warp | 发出 Tensor Core 矩阵乘指令 | 加载完成、累加器可用 |
| Epilogue warps | SwiGLU、路由加权、量化、结果回传与最终归并 | 矩阵乘完成、目标缓冲区可写 |
这些 worker 跑在 persistent 循环里,连续处理多个 tile,任务由 GPU 内的调度器产生。对照图 3 来看:Dispatch 侧负责推进输入,计算侧消费输入、产出结果,epilogue 再把结果交给后续阶段。
专家 rank 拉取输入,再把贡献写回源 rank
调用之前,每个 rank 都会建立对称显存缓冲区,让其他 rank 能通过映射访问。这里的“对称”说的是跨 rank 分配和访问的对应关系,不要求各 GPU 本地虚拟地址的数值相同。[1][4]
真正拉取输入的位置,是内核里的 Pull token data and SF from remote ranks into local L1 buffer。源 rank 先把路由元数据写给目标专家 rank,专家 rank 再据此从源 rank 拉取 token、缩放因子和路由权重,放进本地缓冲区,然后用本地专家权重计算。[2]
Linear 2 算完后,epilogue 根据保存下来的源 rank、token 序号和 Top-k 槽位,把加权贡献写进源 rank 的 combine buffer。图 1 里“送过去、再送回来”的数学路径,落到实现上就是 NVLink 上的远端读和远端写。
full / empty 控制槽位能否读取和复用
一个数据块能开算,要满足两个条件:输入已经写好,存放它的槽位没被别的工作占着。环形缓冲区会反复复用有限的槽位,所以生产者和消费者之间要双向通知:
空闲 → 写入数据 → 发布 full → 消费者使用 → 发布 empty → 再次写入
full 保证消费者不会读到没写完的数据,empty 保证生产者不会覆盖还在用的内容。实际源码还用计数、位掩码和代次来区分不同块的状态。比如 scheduler 里的 L2KBlockDependency 会检查 Linear 2 某个 K 块所需的 Linear 1 输出是否就绪,依赖满足的部分就先推进。[3][4]
融合的一个关键作用就在这里:阶段之间可以在内核内部交接细粒度的状态,需要整批一起等的范围就小了。
回传能提前推进,但最终归并还有同步边界
图 3 里的 Return 指的是输出贡献的回传。源码在 Linear 2 的 epilogue 里写回这些贡献,但源 token 的最终输出还有后续步骤。[2]
当前实现先用本地 grid sync 确认本 rank 的 Linear 2 写回都已完成,再向 peer 发布这次调用的 combine readiness。源 rank 做最终归并时,要等这个 token 选中的专家所在的 peer 完成相应写回,然后读取各槽位求和。
所以,“收到一块就推进计算、算出贡献就推进回传”说的是流水线怎么流动;整层输出什么时候完成,还得看最终归并的同步边界。图里的理想时间线,并不代表每个 token 能立即走完整层。
5. 对照接口:哪些准备工作留给了调用方
从调用边界看,使用前要先初始化多进程通信组、分配对称显存,并按要求准备好专家权重。下面摘出 FP8 输入路径的关键调用,省略了初始化和量化细节:[1][5]
# group、专家权重和量化输入由调用方准备
buffer = deep_gemm.get_symm_buffer_for_mega_moe(
    group, num_experts, num_max_tokens_per_rank,
    num_topk, hidden, intermediate_hidden,
    mma_type="fp8xfp4",  # FP8 路由专家权重则用 "fp8xfp8"
)
transformed_l1, transformed_l2 = deep_gemm.transform_weights_for_mega_moe(
    l1_weights, l2_weights
)

# 每轮更新 token 输入、缩放因子和路由结果
buffer.x[:num_tokens].copy_(x_fp8)
buffer.x_sf[:num_tokens].copy_(x_sf)
buffer.topk_idx[:num_tokens].copy_(topk_idx)
buffer.topk_weights[:num_tokens].copy_(topk_weights)

y = torch.empty((num_tokens, hidden), dtype=torch.bfloat16, device="cuda")
deep_gemm.fp8_fp4_mega_moe(y, transformed_l1, transformed_l2, buffer)
对称显存接口要求 PyTorch 2.9 或更高版本。[1] num_max_tokens_per_rank 决定缓冲区容量,本轮实际用的是 num_tokens。输入和缩放因子必须按接口规定的布局准备,光把普通张量转成 FP8 是不够的,缩放因子和权重转换都省不掉。
如果手上有对应的 SM100 GPU 和 NVLink 互联,可以接着用仓库里的 tests/test_mega_moe.py 验证,它已经包含多进程启动、输入构造、正确性测试和性能比较。下面这组参数方便和本文对照,关掉了 shared expert,只看路由专家路径:
python tests/test_mega_moe.py \
  --num-processes 8 \
  --num-max-tokens-per-rank 1024 \
  --num-tokens 1024 \
  --hidden 7168 \
  --intermediate-hidden 3072 \
  --num-experts 384 \
  --num-topk 6 \
  --num-shared-experts 0 \
  --mma-type fp8xfp4
参数取自该版本测试脚本的接口,脚本会自己启动多个进程。本文没有跑 GPU 性能测试;具体支持哪些形状、需要多少显存、依赖哪些软件,请结合目标机器和该版本的测试代码确认。[5]
6. 重叠能隐藏多少通信?
如果输入、输出传输能持续推进,又有足够多的计算块把流水线填满,主体耗时可以粗略写成:
\[T_{\mathrm{layer}}\approx T_{\mathrm{startup}} +\max(T_{\mathrm{compute}},T_{\mathrm{communication}}) +T_{\mathrm{tail}}.\]这里的通信时间包括前面讨论的输入和输出传输,启动、元数据交换、同步和最终归并要另算。这个式子只是表达“相加变成部分重叠”的趋势:NVLink 双向流量、显存访问和 GPU 线程之间也可能抢资源,所以实际延迟没法直接用它预测。
token 少的时候流水线很短,启动和收尾容易占大头;专家负载不均时,热点专家所在的 GPU 会拖慢最终完成时间。本地 tile 调度得再好,专家的跨卡归属也没变。此外,通信 warp、shared memory、寄存器和缓冲区容量都要占资源,流水线加深就得在这些资源之间取舍。[2–4]
FP8 / FP4 则是从数据量和矩阵乘吞吐的方向继续优化,可以和通信计算重叠一起发挥作用。不过要理解重叠本身,先抓住数据块、依赖和资源这三点就够了。
回到开头的问题:同一个 token 的接收、专家计算和回传依旧有先后顺序。EP 决定它去哪个专家、哪张 GPU;专家内部要不要再做 TP,决定一次矩阵计算怎么切;MegaMoE 则把这些通信和计算放进同一个内核,靠块级依赖和持续调度,让不同数据块同时往前走。
参考
以下链接都固定到本文阅读的版本。本文讨论的是源码中的前向执行路径,图中的形状与时间线为教学推导。
[1] DeepSeek,2026,DeepGEMM README:Mega MoE 接口与融合范围。
[2] DeepSeek,2026,SM100 MegaMoE 内核。重点阅读 Different warp roles、Pull token data、SwiGLU、Linear 2 epilogue 和 combine readiness。
[3] DeepSeek,2026,MegaMoE scheduler。包括 Linear 1 预热、Linear 1 / Linear 2 交错调度、块依赖和环形缓冲容量。
[4] DeepSeek,2026,MegaMoE buffer layout。包括源 token 元数据、对称缓冲区和环形缓冲区布局。
[5] DeepSeek,2026,MegaMoE 多进程测试与参考计算。