翻 Cerebras 的规格表,最扎眼的数字是 44 GB 片上 SRAM。平时聊 GPU,片上缓存都是按 MB 算的,几十 GB 那是 HBM 的量级。Cerebras 是怎么把这么多 SRAM 塞进计算芯片里的?
首先靠面积:WSE-3 做到了约 215 × 215 mm,相当于约 57 颗 H100 的计算裸片。其次是组织方式:内存分散在几十万个小核心旁边,核心之间用片上网络连起来。最后,制造上的冗余和容错让这么大一块硅片能真正做成产品。[1][2][3]
顺着这条线看下去,还能顺带回答两个问题:它的 PB/s 级带宽是怎么来的,以及为什么有了 44 GB,跑一个 70B 模型还是得用好几块晶圆。
1. GPU 也有 SRAM,区别在于权重放在哪里
以 H100 SXM 为例,它有 50 MB L2 cache,还有各个 SM 用的 shared memory 等片上存储;80 GB HBM3 则是独立的 DRAM 堆叠,通过封装内互联接到 GPU 裸片上。[1] 所以”在同一个封装里”不等于”在同一块计算硅片上”。
SRAM 能和逻辑电路做在一起,贴着计算单元提供快速访问,代价是每个存储位占的面积大。HBM 则用独立的 DRAM 芯片提供容量,GPU 不用把所有工作数据都塞进昂贵的逻辑硅片。
放到大模型上,这个分工就很好理解。一个 70B 模型用 FP16 或 BF16 存权重,光参数本身就要约
\[70\times10^9\times2\ \text{bytes}=140\ \text{GB}.\]这里和后文的容量手算都用十进制单位,$1\ \text{GB}=10^9\ \text{bytes}$。百 GB 级的权重远远超出单颗 H100 的 L2,所以 GPU 推理得从 HBM 往片上计算单元喂数据,再靠缓存和 kernel 内的复用尽量少搬几次。
Cerebras 走的是另一条路:直接把计算硅片上的存储做大。在它的权重驻留推理方案里,模型被映射到一块或多块 WSE(Wafer-Scale Engine)的局部 SRAM 上,运行时大量核心并行读取各自身边的权重。[4] 先来看它给 SRAM 腾出了多大的地方。
2. 先把硅片做大,再让缺陷可以被绕开
WSE-3 面积 46,225 mm²,集成 4 万亿个晶体管、90 万个 AI 核心和 44 GB 片上内存。H100 的 GH100 裸片面积是 814 mm²,两者之比约为
\[\frac{46{,}225}{814}\approx56.8.\]注意这比的是计算硅片,H100 封装里的 HBM 没算进分母。[1][2] 能放下几十 GB SRAM,第一个前提就是这么大的面积和晶体管预算。
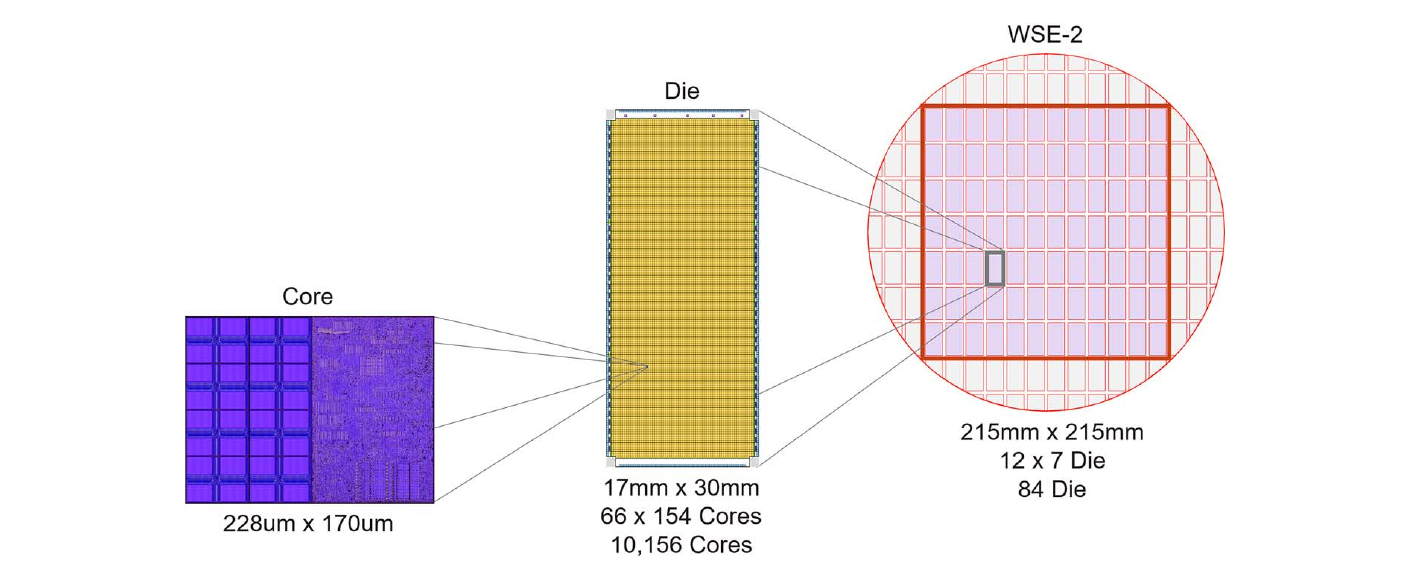
图 1:Core → Die → Wafer。摘自 IEEE Micro 2023 论文第 7 页、Figure 7;图中是 WSE-2,包含 84 个 die 区域。这里用它说明晶圆级扩展方式,具体核心数量属于该代产品。[5]
晶圆级芯片同样受光刻单次曝光范围的限制。Cerebras 的做法是保留多个曝光区域,用跨区域边界的金属互联把本该被切开的区域连成一个整体。所以图里的 die 指的是晶圆上的重复区域,而不是先切成小芯片再装到同一块基板上。[2][5]
SRAM 本身并不会因此变得更省面积。拿典型的六晶体管 SRAM 单元(6T)估个量级,每个存储位用六个晶体管,44 GB 的存储单元就需要
\[44\times10^9\times8\times6 =2.112\times10^{12}\]个晶体管,约 2.1 万亿。这还没算译码、读写外围电路和冗余;而且 6T 只是参照公开 SRAM 单元实例做的假设,Cerebras 并没有披露实际的单元实现。[6] 跟全片 4 万亿晶体管放在一起看,就知道片上内存吃掉了多少硬件。
但面积做大之后,新问题马上就来了:硅片越大,覆盖的制造缺陷越多。要是有一处坏了就得扔掉整片,这产品根本做不出来。
Cerebras 的办法是把基本单元做得足够小,再备好备用核心和冗余通信路径。官方给出的 WSE-3 单核面积约 0.05 mm²,坏掉的单元由备用资源顶上,软件看到的仍然是一张规则的计算网络。[3] 这样局部缺陷就能被隔离,不至于连累整块晶圆。晶圆级的面积和容错设计,缺了哪个都不成立。
3. 44 GB 是很多局部内存的总和
Cerebras 在 Hot Chips 2024 上公布,WSE-3 每个核心配 48 kB SRAM,外加 512 B local cache(容量标记沿用官方写法)。[2] 把大量这样的核心铺满整片晶圆,加起来就是几十 GB 的片上存储。
所以别把这 44 GB 想成一块统一的大缓存:每个核心直接用的是自己附近那一小块内存,核心之间要共享数据,得走网络。
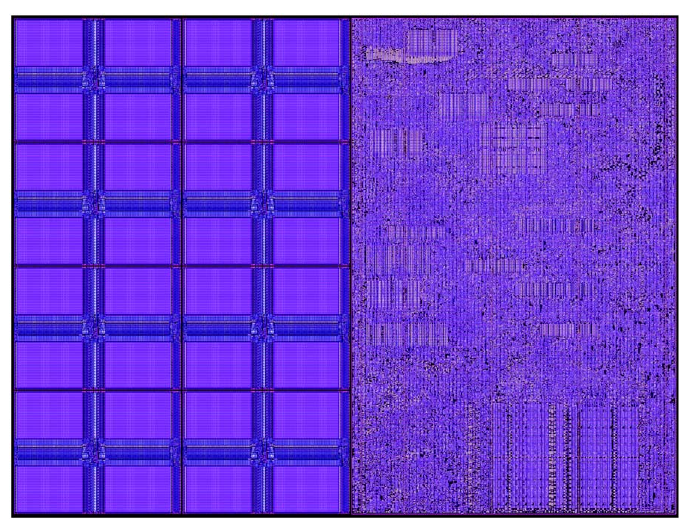
图 2:WSE-2 核心的物理布局,左侧约一半面积是 SRAM,右侧是逻辑。摘自 IEEE Micro 2023 论文第 3 页、Figure 2。[5]
2023 年的架构论文把 WSE-2 的核心讲得更细:48 kB 局部 SRAM 分成八个 bank,数据通路一次能做两个 64-bit 读和一个 64-bit 写。分 bank 是为了让一次计算要用的几个操作数能并行取到。[5]
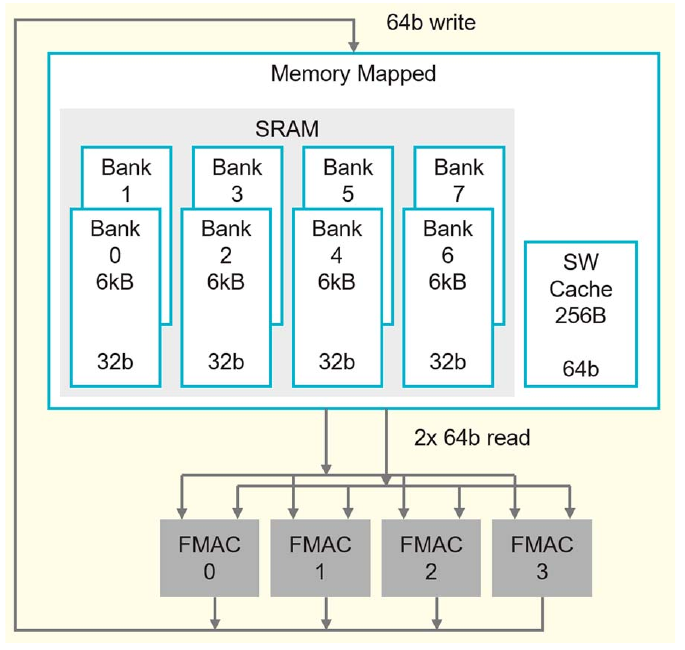
图 3:WSE-2 的局部内存组织。摘自 IEEE Micro 2023 论文第 4 页、Figure 3。图中的八个 bank 和 256 B 软件管理缓存属于 WSE-2;WSE-3 的局部缓存规格见正文引用的 Hot Chips 2024 资料。[2][5]
这些主 SRAM 阵列里放什么由软件决定,不靠普通硬件缓存那套 tag 查找和自动替换。编译器要负责把计算和数据摆到合适的位置,算完的结果再显式发给其他核心。图里另外还有一个小的软件管理缓存,所以准确地说,是主要的局部存储由软件管理,而不是核心里完全没有缓存。[5]
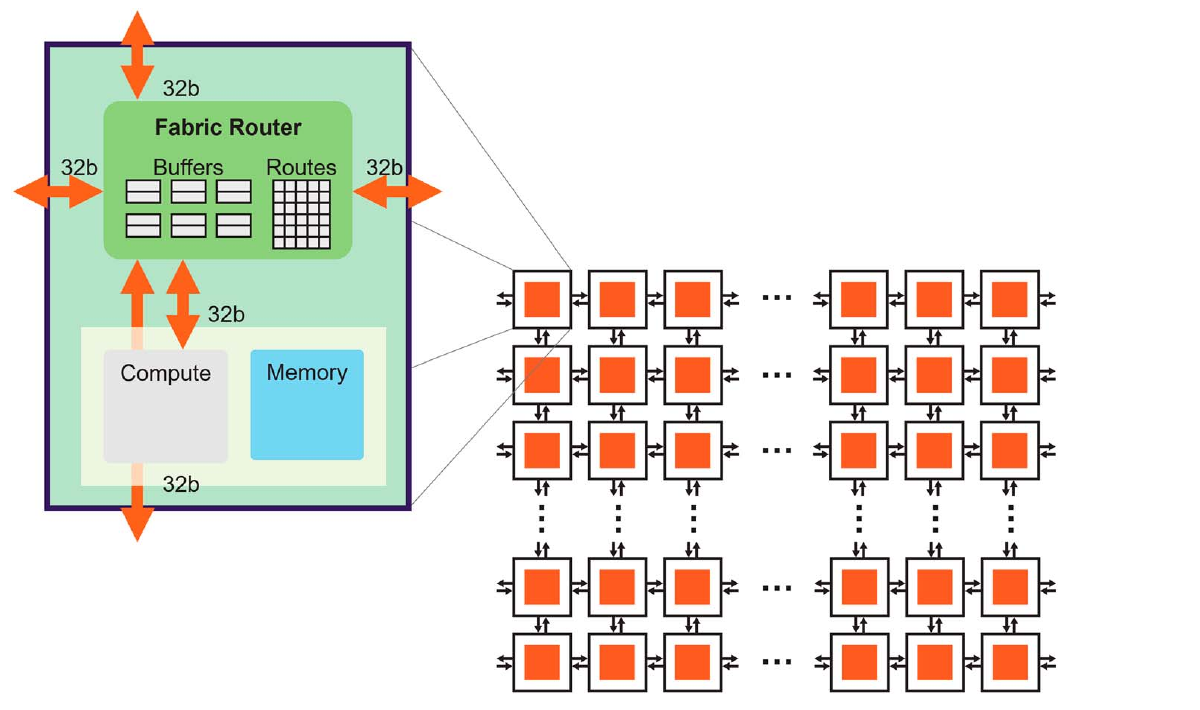
图 4:WSE-2 的二维 mesh fabric。摘自 IEEE Micro 2023 论文第 7 页、Figure 8。每个节点同时包含计算、内存和路由器。[5]
这些局部单元由二维 mesh 连起来,再通过跨曝光区域的连接铺满整片晶圆。[2][5] 打个比方,就像很多工位各带一个小仓库:干活时从身边取料,工位之间通过网络交换半成品。
这种组织方式让容量和访问并行度一起变大,但数据放在哪儿也就成了性能的一部分。计算主要吃本地数据时,短距离连线的优势能发挥出来;一旦要走很多跳、集中汇总或者跨晶圆传输,就得付出相应的通信代价。
4. PB/s 带宽来自哪里,又怎样帮助 decode
WSE-3 官方给出的片上内存带宽约 21 PB/s,这是大量局部内存通路同时工作的聚合值。[2][4] 写成公式,就是把各核心的局部带宽加起来:
\[B_{\mathrm{aggregate}}=\sum_{i=1}^{N}B_{\mathrm{local},i}.\]要吃满这个总量,得有足够多的核心同时在读自己的数据。它说的不是某个核心从全片任意位置读数据有多快。
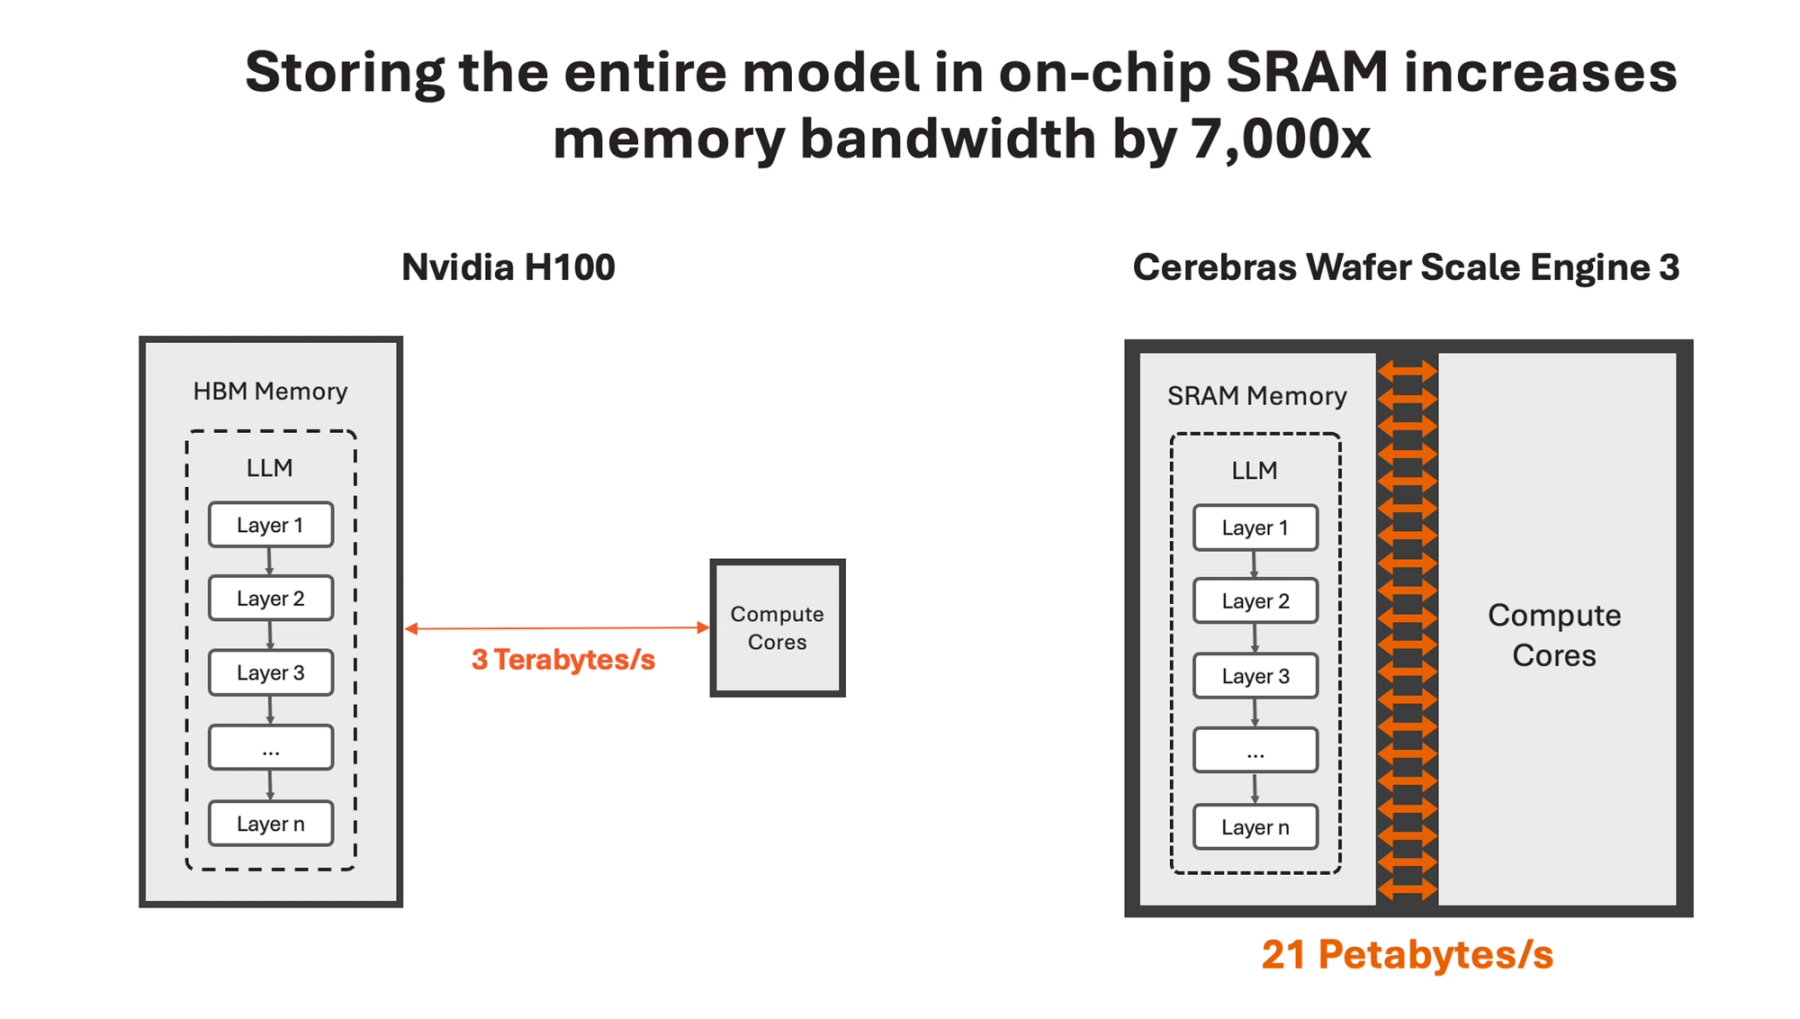
图 5:Cerebras 2024 年的推理介绍图。图中将 H100 约 3 TB/s 的 HBM 带宽,与 WSE-3 约 21 PB/s 的片上聚合带宽相比较;“7,000x”指这两个带宽数字的比值。示意图省略了 GPU 的缓存层级和 WSE 的分布式布局。[4]
实际分析时,本地 SRAM 带宽、晶圆内 fabric 带宽和晶圆间 I/O 带宽是三个不同的数。数据走哪条路,就受哪条路的约束;局部带宽加起来再大,也补不上跨晶圆网络的不足。
那这种设计为什么特别适合低延迟 decode?从一层线性计算看起。设权重 $W\in\mathbb{R}^{m\times n}$,输入 $x\in\mathbb{R}^{n}$,计算 $y=Wx$。单个 token 的矩阵向量乘约有 $2mn$ 次浮点运算;如果权重每次都从容量层读进来,每个参数占 $s$ bytes,读取量就约是 $smn$ bytes。只看权重流量,算术强度约为
\[I_{\mathrm{weight}}\approx\frac{2mn}{smn}=\frac{2}{s}.\]FP16/BF16 下 $s=2$,结果只有约 1 FLOP/byte。也就是说,单个 token 在每个权重上只做很少的计算,瓶颈很容易落在供数速度上。
如果一次处理 $B$ 个 token,并且这次矩阵运算里能复用同一份权重读取,权重对应的算术强度就能提到约 $2B/s$。这就是 GPU 能靠 batching 提吞吐的原因,也是小 batch、低延迟请求更容易被权重带宽卡住的原因。(这个推导忽略了激活、KV 和其他算子,是简化版。)
Cerebras 的权重驻留方案,把反复取数的地方挪到了核心旁边的 SRAM。[4] 不过模型层与层之间、相邻生成的 token 之间仍然有依赖,片上网络、算子执行和 KV 访问也都要花时间,所以图 5 的带宽比值没法直接换算成端到端的生成速度。
5. 放不进一块晶圆的模型怎么办
回到开头的 70B 模型。用 16-bit 权重,光参数就约 140 GB,一块 44 GB 的晶圆显然放不下。只算权重、按标称容量取理想下界,需要
\[N_{\mathrm{wafer}}\ge \left\lceil\frac{140}{44}\right\rceil=4.\]四块晶圆名义上一共 176 GB,放完权重还剩约 36 GB。但这些空间散在不同晶圆、不同核心上,程序、激活、通信缓冲和 KV cache 都要从里面分,模型切分也不一定能刚好把容量填满。
Cerebras 2024 年的推理介绍里提到,超过单晶圆容量的模型会按层边界映射到多套 CS-3 上,70B 模型最少用四套系统。[4] 这可以作为实际部署的参考,至于能支持多长的上下文、多少并发,还得按具体的内存布局去算。
所以”整个模型驻留片上”,实际可能是模型分散在多块晶圆各自的片上 SRAM 里。MoE 也逃不开这个容量约束:每个 token 只用到部分专家,当步的计算和读取量是少了,但没被选中的专家权重照样得有地方放。
扩到多块晶圆以后,激活和中间结果就要走系统间互联了。片上 SRAM 解决了数据离计算近的问题,但容量一扩展,又多出了新的通信边界。所以比较推理性能时,晶圆数量、精度、上下文和并发这几项都得一起标出来。
6. 把 SRAM 用在最需要它的阶段
同一个模型的 prefill 和 decode,访问模式差别很大。Prefill 一次处理多个输入 token,线性层权重的复用机会通常更多;低延迟 decode 批量小,更依赖快速供数。所以两个阶段可以交给不同的硬件来跑。[7][8]
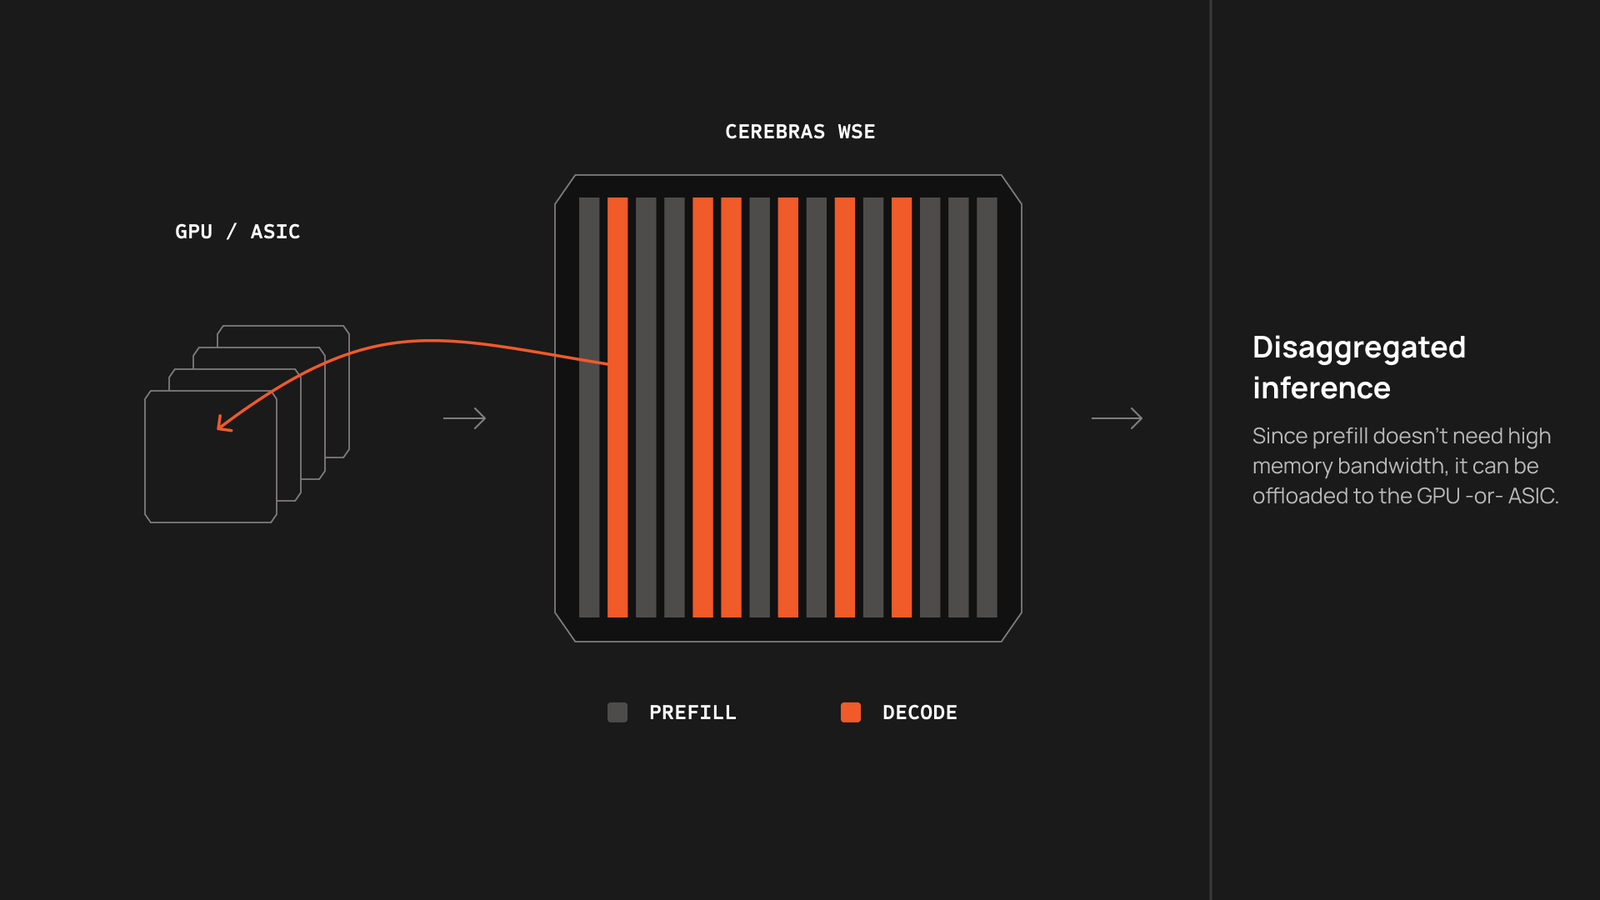
图 6:Cerebras 2026 年 CS-4 介绍中的分离式推理示意。灰色为 prefill,橙色为 decode;橙色弯箭头表达将 prefill 工作移到 GPU/ASIC 的安排,并非 KV cache 的传输方向。[7]
在已经公布的合作方案里,AWS Trainium 或 AMD Helios 负责 prefill,Cerebras 系统负责后面的 decode。[8][9] 两边跑的是同一个模型的不同阶段:prefill 侧处理 prompt、生成 KV cache,状态传给 decode 侧后,由它持续生成 token。这要求两边都有对应的模型权重和实现,KV 布局、精度、网络和调度也都得对得上。
这样分工,WSE 上能有更多资源留给 decode,但也多了状态传输和调度的开销。看部署效果时,首 token 延迟和逐 token 延迟要一起看;只报生成阶段的 tokens/s,prefill 和交接的开销就被藏起来了。
看产品代际也要注意粒度。2026 年 8 月公布的 WSE-3 Turbo 单晶圆还是 44 GB SRAM,内存带宽提到 43.2 PB/s;CS-4 则是一套装了三块 WSE-3 Turbo 的系统。[10] 芯片容量、整机容量和整机带宽,要分开算。
另外,Cerebras 的训练系统用过 MemoryX 加 weight streaming 的执行方式:权重存在外部系统里,按需流入 WSE,梯度再流回 MemoryX 做更新。[11] 这条路是靠外部存储扩展模型容量,跟本文讲的推理时权重长期驻留 SRAM 是两种内存安排。2026 年公开的 CS-6 路线则打算把晶圆级计算、SRAM 和 3D 堆叠 DRAM 结合起来,继续扩大容量,不过这还只是未来规划。[12]
回到”为什么放得下”这个问题,Cerebras 付出的代价很具体:更大的硅面积、分布式的数据布局、容错制造,再加上晶圆级系统的供电和散热。换来的是让更多权重贴近计算单元。对那些要反复读取权重、又没法靠大 batch 摊薄读取成本的 decode 请求,这笔交易最划算。
参考
[1] NVIDIA,NVIDIA Hopper Architecture In-Depth,2022-03-22。GH100 裸片面积,以及 H100 SXM 的 HBM、L2 与片上存储。
[2] Sean Lie,Cerebras,Wafer-Scale AI: GPU Impossible Performance,Hot Chips 2024。PDF 第 3 页列出 WSE-3 整片规格,第 29 页列出每核 48 kB SRAM 与 512 B local cache,第 30–31 页说明晶圆组织和跨 reticle 互联。
[3] Cerebras,100x Defect Tolerance: How Cerebras Solved the Yield Problem,2025。小核心、备用核心与冗余通信路径。
[4] Cerebras,Introducing Cerebras Inference: AI at Instant Speed,2024-08-27。图 5 来源;片上聚合带宽、权重驻留及 70B 跨四套 CS-3 的部署说明。
[5] Sean Lie,Cerebras Architecture Deep Dive: First Look Inside the Hardware/Software Co-Design for Deep Learning,IEEE Micro,2023。WSE-2 架构;图 1–4 分别摘自 PDF 第 7、3、4、7 页的 Figure 7、2、3、8。
[6] E. Nowak 等,A Functional FinFET-DGCMOS SRAM Cell,IEDM,2002。六晶体管 SRAM 单元的公开实例,用于量级估算。
[7] Cerebras,Introducing Cerebras CS-4,2026-08-18。图 6 来源;分离式推理与系统连接方式。
[8] Cerebras、AWS,AWS and Cerebras Collaboration Aims to Set a New Standard for AI Inference Speed and Performance in the Cloud,2026-03-13。Trainium prefill、CS-3 decode 与 EFA 互联的联合方案。
[9] AMD、Cerebras,AMD and Cerebras Announce Industry-Leading Ultra-Low-Latency and High Throughput AI Inference Solution,2026-07-23。Helios 与 WSE 的联合方案;公告中的部署时间属于当时计划。
[10] Cerebras,Cerebras Unveils CS-4: Up to 30 Times Faster than GPU-based Solutions,2026-08-18。WSE-3 Turbo 与三晶圆 CS-4 的规格;该公告将 CS-3 带宽列为 21.6 PB/s,本文沿用 2024 资料的“约 21 PB/s”。
[11] Cerebras,Cerebras Execution Modes — Weight Streaming Execution,SDK 1.9.1 文档。MemoryX 与权重、梯度的数据流。
[12] Cerebras,Ultrafast Frontier Inference: Cerebras Deep Dive at Hot Chips 2026,2026-08-25。CS-6 的 SRAM 与 3D DRAM 路线图。