前置阅读:FlashAttention:IO 感知的精确 Attention 计算 · LLM 推理(Inference)性能推导
给 Attention 加一个 sliding window,看起来只需要改一行代码:
scores = scores.masked_fill(~window_mask, float("-inf"))
但如果执行到这里时,Q @ K.T 已经算完,那么窗口外的 dot product 一个也没省。再把这段逻辑放进 fused Attention,问题又变成:现有 kernel 是否支持这个窗口,能不能再叠加 document mask、相对位置 bias 或 soft-capping?
FlexAttention 试图让这两件事一起成立:用户用几行 PyTorch 代码表达规则,生成的 kernel 既保留 FlashAttention 的分块与融合,也能利用规则中的块稀疏性。理解它的关键,是沿着一条路径往下看:Python 里的规则,怎样变成 kernel 里的运算,以及哪些规则能让一个计算块彻底消失。
1. FlashAttention 省了搬运,窗口还可以省计算
固定 batch 和 head,设 $Q\in\mathbb R^{N_q\times d}$、$K,V\in\mathbb R^{N_{kv}\times d}$,标准 Attention 为:
\[S=\frac{QK^{\mathsf T}}{\sqrt d},\qquad P=\operatorname{softmax}(S),\qquad O=PV.\]两个矩阵乘的计算量都是 $O(N_qN_{kv}d)$。朴素实现还要在 HBM 中保存形状为 $N_q\times N_{kv}$ 的分数和概率矩阵,并在矩阵乘、softmax 之间反复读写它们。
FlashAttention 把这条链分块执行,用 online softmax 维护逐行统计量,使完整的 $S$、$P$ 不必写入 HBM。对于 dense self-attention,计算量仍为 $O(N^2d)$,但输入、输出和保存的状态只需 $O(Nd)$ 存储;这里把 head 维度 $d$ 也保留在复杂度里。[1] 原论文也讨论了 block-sparse 扩展,因此“减少 IO”和“利用稀疏性”本来就可以结合。
现在加上 causal sliding window。约定 $W$ 包含当前 token,位置从零开始,则 query $i$ 可以看到的 key 满足:
\[0\le i-j<W.\]例如 $W=4$ 时,query $i=6$ 只能看 $j=3,4,5,6$。整个序列的有效配对数为:
\[\sum_{i=0}^{N-1}\min(i+1,W) =NW-\frac{W(W-1)}2,\qquad 1\le W\le N.\]这是把前 $W$ 行的 $1+2+\cdots+W$,与后面每行的 $W$ 项相加。以 $N=8192,W=1024$ 手算,有效配对约为 786 万;完整 dense 矩阵有 6711 万个位置,普通 causal Attention 则有约 3356 万个有效位置。窗口带来的计算机会很大,但能省下多少工作,还取决于 kernel 是否真的跳过窗口外的块。配对数量的比例也不能直接当作耗时比例。
2. 把变化部分留给两个函数
常见 Attention 变体共享同一条主体:算分数、做 softmax、加权求和。变化通常发生在 softmax 之前。例如 ALiBi 给分数加位置 bias,soft-capping 对分数做非线性变换,document mask 则限制不同文档之间的可见性。
FlexAttention 把这些变化拆成两个 callable:[2][3]
def score_mod(score, b, h, q_idx, kv_idx):
    return modified_score

def mask_mod(b, h, q_idx, kv_idx):
    return allowed  # True 表示参与 Attention
这里的 score 是已经乘过缩放系数的单个分数;b、h、q_idx、kv_idx 指明它属于哪个 batch、head 和 query-key 配对。调用参数在语义上是标量 Tensor,不能把它当作普通 Python 循环变量,写依赖数据的 if 或调用 .item() 来分支。
沿用前面的窗口,再叠加一个 soft-cap,规则就是:
W = 256
CAP = 20.0

def causal_window(b, h, q_idx, kv_idx):
    return (q_idx >= kv_idx) & (q_idx - kv_idx < W)

def soft_cap(score, b, h, q_idx, kv_idx):
    return CAP * torch.tanh(score / CAP)
< W 对应“含当前 token 共 $W$ 个”。如果写成 <= W,窗口就会多一个位置。CAP=20 在这里是演示参数,实际使用时应与模型定义一致。
两条规则合起来,对应的分数为:
\[\widetilde S_{bhij}= \begin{cases} c\tanh(S_{bhij}/c),&0\le i-j<W,\\ -\infty,&\text{其他位置}, \end{cases} \qquad O=\operatorname{softmax}(\widetilde S)V.\]这个顺序很重要:先修改有效分数,再把不允许的位置设为 $-\infty$。 如果先做 mask,再对所有分数做 soft-cap,$-\infty$ 会被变成有限的 $-c$,被屏蔽的位置就重新获得了非零概率。
从表达能力看,用 score_mod 返回 $-\infty$ 也能实现 mask。单独提供 mask_mod 的价值,是把“这里不参与计算”的信息交给块稀疏路径。实际调用时,mask_mod 先传给 create_block_mask,得到 BlockMask,再把这个对象传给 flex_attention;flex_attention 本身没有一个直接接收 mask_mod 的同名参数。[4]
这个抽象也有边界。它适合按当前分数、位置索引和捕获的 Tensor 表达逐元素规则;如果新算子需要跨整行排序、全局 top-k 或改变 softmax 的归约方式,就超出了这两个函数直接表达的范围。
3. 编译器具体生成了什么
看到“用 Python 生成高性能 Attention”,容易把最困难的部分都归功于自动编译。FlexAttention 的设计更具体:框架先提供优化好的 Attention 模板,再把用户规则编译进去。[2]
论文描述的 Triton 路径中,TorchDynamo 捕获自定义函数的计算图,TorchInductor 将这些子图生成对应的 Triton 运算,并嵌入 forward、backward 和 decoding 模板。模板负责 tiling、online softmax、加载与并行分工,用户函数负责分数和 mask 的变化。自动求导还会为受支持的 score_mod 生成反向计算,接到 Attention 的 backward 路径中。[2][3]
以当前的窗口加 soft-cap 为例,forward 内部可以概括成下面的伪代码。它省略了线程布局和 softmax 更新公式,但保留了执行顺序:
固定一个 query tile,初始化 online-softmax 状态
    从 BlockMask 读取需要访问的 KV block 编号
    对每个保留的 block:
        计算 Q_tile @ K_tile.T,并缩放
        在片上分数 tile 中执行 score_mod
        若为部分有效块,执行 mask_mod,把无效分数设为 -inf
        更新 online-softmax 状态,累加与 V_tile 的乘积
    归一化并写回输出
torch.tanh 因而成为 Attention 循环里的一段运算,无需先写回整个分数矩阵,再启动一个独立 kernel 处理它。即使函数捕获了额外 Tensor,例如 bias[h],编译器也可以把相应加载放进这条计算链。[3]
这里有两种不同的收益:把修改融合进去,省掉中间结果和独立算子调度;把不需要的块从遍历列表中移除,减少矩阵乘和 K/V 加载。前者来自融合,后者需要 BlockMask 提供结构信息。非线性函数、额外加载和索引本身仍有成本,融合并不会让它们免费。
要继续读实现,可以从固定版本源码中的 flex_attention、create_block_mask 入口进入,再看 Inductor 的 kernel/flex/ 目录。[5] 这样能把“规则怎么写”“块如何表示”“kernel 怎么生成”分开追踪,不必一开始就读完整的 Triton 模板。
这套分工也允许底层模板继续演进。2026 年 3 月,PyTorch 官方介绍了基于 FlashAttention-4 的 backend:Inductor 生成 CuTeDSL 形式的 score/mask 修改,再接入 FA4 的计算实现。[9] 本文展开的是经典 Triton 路径,而同一编程接口还可以接入新的计算模板。比较性能时,除了规则和输入形状,也要记录实际使用的 backend。
4. BlockMask 怎样把 mask 变成少算
BlockMask 先把 query-key 平面划成块,再记录每个 query 块需要访问哪些 KV 块。下面用 $N=16,W=8$、每块 $4\times4$ 的小例子看这个过程。左图每个有色单元表示一个允许的配对,右图每个单元代表左图的一整个块。
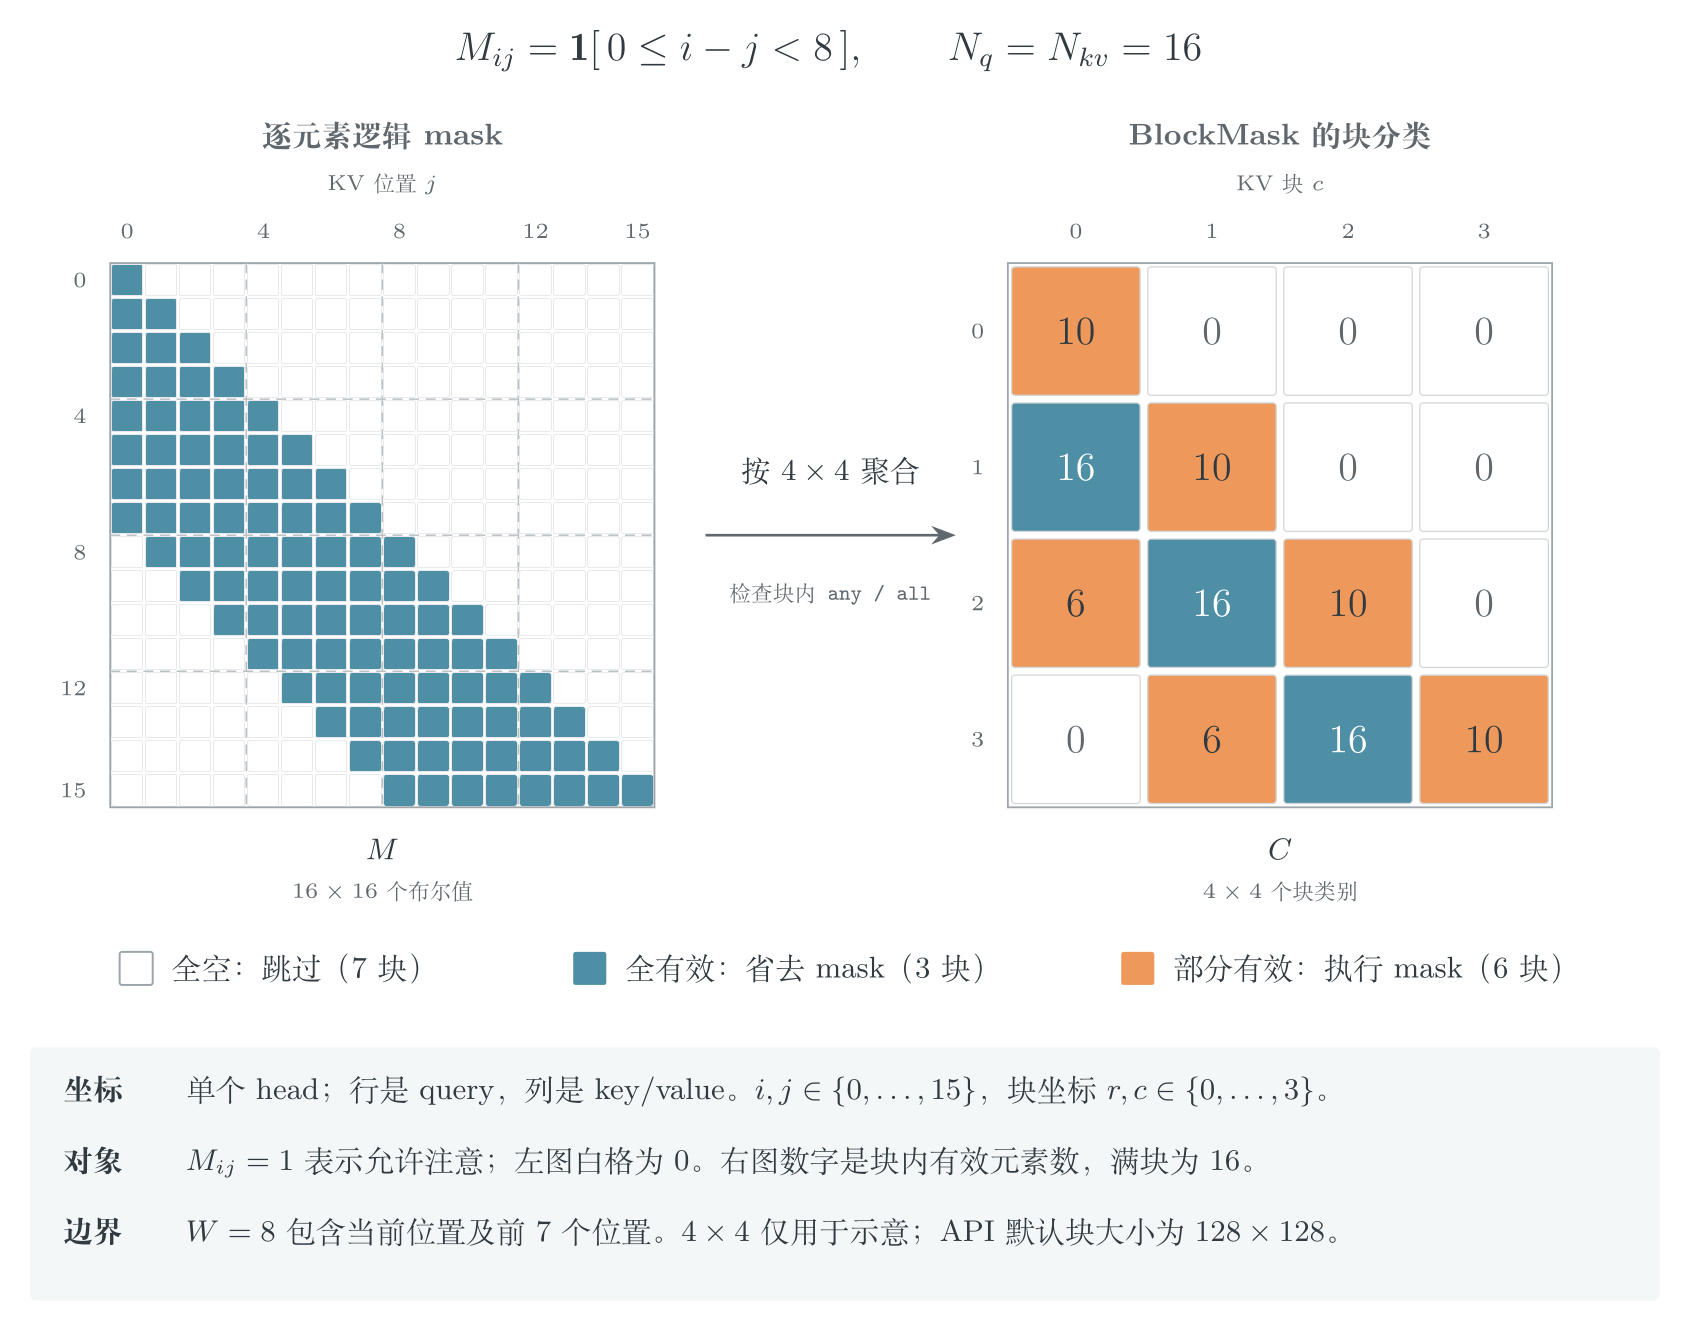
对一个全空块,kernel 可以直接跳过,不加载对应的 K/V,也不执行这块的矩阵乘。全有效块需要计算,但可以省略逐元素 mask_mod。部分有效块仍按块计算,再把其中无效位置屏蔽掉。score_mod 则需要作用于保留下来的全有效块和部分有效块。[2][4]
例如图中最后一个 query 块包含位置 $12$ 到 $15$:KV 块 $0$ 到 $3$ 完全不需要;$4$ 到 $7$ 部分有效;$8$ 到 $11$ 全部有效;$12$ 到 $15$ 又是部分有效。运行时可以直接沿着这份列表访问 K/V,而不必每次扫描完整的 key 维度。
右图是便于阅读的分类图。实际 BlockMask 使用块数量与块索引等 Tensor,并分别保存部分块、全有效块的信息;还需要服务反向传播的 query 方向索引。它属于面向执行的稀疏元数据,不是把右图原样保存成一个彩色矩阵。[4][5]
这里的 $4\times4$ 只为方便看图。示例代码使用 BLOCK_SIZE=128;这个参数描述稀疏元数据的粒度,不能直接当作最终 Triton kernel 的 BLOCK_M、BLOCK_N。计算 tile 还受 backend 配置约束,一个稀疏块可以被进一步分成多个计算 tile。[5]
这也解释了为什么元素稀疏度高,速度不一定快。若有效元素分散在几乎每个块里,块大多成为“部分有效”,矩阵乘仍然要做。滑动窗口、文档边界等规则有较好的块级局部性,更容易形成大片可以跳过的区域。窗口很窄时,边界块多算的元素还可能占很大比例,需要结合块粒度判断收益。
同样,BlockMask 较小也不意味着它没有成本。它把元数据粒度从元素缩小到块,索引缓冲的大小仍与块网格和具体表示有关,不能据此保证全部辅助内存都随 $N$ 线性增长。通用 create_block_mask 还需要求值规则并做块内归约;构造过程的峰值内存和耗时,应与最终 Attention kernel 分开看。[4][5]
5. 把窗口与 soft-cap 接到一次调用里
下面给出完整的 CUDA 示例,API 按 PyTorch 2.14 文档及 v2.14.1 源码核对。该版本仍将 FlexAttention 标为 prototype。这里使用 FP16、相同的 Q/KV head 数和 head 维度,不启用 dropout;这些参数足以把前面的两条规则串起来。[4][5]
import math
import torch
from torch.nn.attention.flex_attention import (
    create_block_mask,
    flex_attention,
)

if not torch.cuda.is_available():
    raise RuntimeError("此示例需要支持 FlexAttention 的 CUDA 环境")

torch.manual_seed(0)
B, H, N, D = 2, 8, 1024, 64
W, CAP = 256, 20.0

def causal_window(b, h, q_idx, kv_idx):
    return (q_idx >= kv_idx) & (q_idx - kv_idx < W)

def soft_cap(score, b, h, q_idx, kv_idx):
    return CAP * torch.tanh(score / CAP)

# mask 与 batch/head 无关,所以只构建一份并广播。
# 当前 API 推荐编译构建函数,不再传弃用的 _compile=True。
build_mask = torch.compile(create_block_mask)
block_mask = build_mask(
    causal_window,
    B=None, H=None,
    Q_LEN=N, KV_LEN=N,
    device="cuda",
    BLOCK_SIZE=128,
)

q, k, v = [
    torch.randn(
        B, H, N, D,
        device="cuda", dtype=torch.float16, requires_grad=True,
    )
    for _ in range(3)
]

compiled_flex = torch.compile(flex_attention)
out = compiled_flex(
    q, k, v,
    score_mod=soft_cap,
    block_mask=block_mask,
)  # 默认 scale = 1 / sqrt(D),out 的形状为 [B, H, N, D]

# 小规模 dense reference 只用于核对语义,不作为高性能实现。
with torch.no_grad():
    pos = torch.arange(N, device="cuda")
    distance = pos[:, None] - pos[None, :]
    keep = (distance >= 0) & (distance < W)
    scores = (q.float() @ k.float().transpose(-2, -1)) / math.sqrt(D)
    scores = CAP * torch.tanh(scores / CAP)
    scores = scores.masked_fill(~keep, float("-inf"))
    ref = torch.softmax(scores, dim=-1) @ v.float()
    torch.testing.assert_close(out.float(), ref, atol=2e-3, rtol=2e-3)

# 检查反向路径能执行;完整训练验证还需对照 reference 梯度。
out.float().square().mean().backward()
for x in (q, k, v):
    assert x.grad is not None and torch.isfinite(x.grad).all()
这段代码在本文准备时做了 API 与语法核查,尚未在本机 CUDA 设备上执行。误差阈值是这组 FP16 示例的检查起点;扩展到不同 dtype、形状或更复杂规则时,应同时验证输出和梯度,并报告实际误差。
有两个参数值得单独看。B=None,H=None 的依据是窗口规则完全不依赖 batch 和 head。如果换成每个样本有不同文档边界的 packed sequence,B 就需要表达这些差异;不能为了减少元数据而把不同样本的规则错误地广播成同一份。
另一个是 W。它决定可见性,也决定 BlockMask 的有效块列表。改变 W 或文档划分后,要重新构建匹配的新 mask。仅仅让闭包读取到新的 Tensor 值,并不会自动修复旧对象中“哪些块为空、哪些块全有效”的记录。
对固定窗口、固定长度,可以缓存并复用 BlockMask;对每个 batch 变化的 document mask,可以在 batch 入口构建一次,让采用相同规则的多个 Attention 层共用。重建 mask 和重新编译 kernel 是两件事:前者更新稀疏元数据,后者生成代码。元数据内容变化不必然触发编译,但形状、dtype、函数图或被特化的 Python 参数变化,仍可能触发重新编译。[3][5]
6. Decode 先解决并行度,再核对位置
训练和 prefill 通常有很多 query,可以沿 query 块分配工作。单 token decode 则是 $N_q=1$、$N_{kv}$ 很长;在 batch 和 head 提供的并行度不足时,只沿 query 分块就很难占满 GPU。
FlexDecoding 为短 query 提供另一条 backend 路径:沿 KV 长度拆分,让多个 program 并行计算局部结果,再合并 softmax 统计量与输出。具体分派受形状和版本实现影响,prefill 与 decode 可以编译成不同 kernel。[6] 这沿用了 Flash-Decoding 的拆分与归并思路。[7]
为什么局部输出不能直接平均?固定一个 query,令第 $r$ 个 KV 分片的局部输出为 $o_r$,局部分数的 log-sum-exp 为:
\[\ell_r=\log\sum_{j\in\mathcal K_r}\exp(\widetilde S_j).\]每个 $o_r$ 已经在自己的分片内归一化。它在全体 key 中应占多大权重,取决于该分片的分母,因此最终输出为:
\[\ell=\operatorname{logsumexp}_r(\ell_r),\qquad o=\sum_r\exp(\ell_r-\ell)\,o_r.\]这正是 online softmax 的可合并性,只是从“一个 program 顺序接收下一块”,变成“多个 program 并行计算后归并”。上式中的局部归一化输出以分片非空为前提;空分片的贡献需要直接置零,避免用零权重乘上未定义的局部输出。[7]
把前面的窗口函数搬到 decode,还有一个更直接的正确性问题:q_idx 是当前 query Tensor 内的位置。只传入一个 query 时,它等于 $0$;这个 token 在完整序列中的位置却可能是 $8191$。若原样使用 q_idx >= kv_idx,就会只留下 cache 的第一个位置。[6]
当 KV Tensor 从全局位置 $0$ 开始、当前 query 的起点是 $t$ 时,应先做位置换算:
\[i_{\mathrm{abs}}=q\_idx+t,\qquad 0\le i_{\mathrm{abs}}-kv\_idx<W.\]这个 offset 同样要传递到依赖相对位置的 score_mod。若 KV 使用环形缓冲或分页存储,还需要把物理位置映射回逻辑位置后再判断规则。
官方推理教程展示过预计算大 BlockMask、decode 时按 query 块取切片的办法。[6] 使用时要同时处理块行、实际 Q/KV 长度和带 offset 的 mask_mod:块编号不等于 token 位置。v2.14.1 的切片实现还要求重新设置切片后的 mask_mod,因此不能把旧教程中的短代码直接当成完整的 decode 实现。[5]
PagedAttention 也在这一层与 FlexAttention 衔接:页表把逻辑 KV 块转换成物理块索引,score/mask 规则再使用对应的逻辑位置。[2][6] 它额外涉及 cache 的存储和地址映射,仅写一个逐元素 bias 函数还不足以完成分页管理。
7. 怎样判断这次改造是否值得
如果模型使用标准 dense 或 causal Attention,可以先从 PyTorch SDPA 开始。SDPA 是统一接口,实际 backend 根据设备、dtype、形状等条件选择;对于标准模式,已有专用 kernel 是很有竞争力的基线。[8] FlexAttention 更有价值的场景,是模型需要组合自定义规则,或者规则能产生可利用的块稀疏性。
从前面的执行过程,可以自然拆出三类成本:
- 首次编译。 图捕获、代码生成,以及启用 autotune 后的候选搜索。它影响冷启动,不能混进每次调用的稳态延迟。
- mask 构建。
create_block_mask的执行、分配和可能的重建。固定模式可摊销;每个 batch 都变化的模式,要按真实调用频率计入。 - Attention 执行。 保留块上的矩阵乘、
score_mod、边界 mask、间接索引与输出归并。训练还要独立测 backward。
在目标 GPU 上,先用较短序列对齐输出和梯度,再预热编译后的相同形状,使用 CUDA events 或带同步的计时方法测稳态调用。记录 PyTorch/Triton 版本、GPU、dtype、$B/H/N_q/N_{kv}/d$、窗口宽度和 mask 块大小,才能解释后续的速度变化。mode="max-autotune" 可以让 Inductor 搜索更多配置,但要把增加的编译成本单独记录。[6]
比较时还要确保 Attention 语义相同。一个滑动窗口 kernel 比完整 causal kernel 快,其中一部分来自模型本来就少看了 key;只有把相同窗口、相同 bias 或 soft-cap 的实现放在一起,才能比较实现本身的效率。
FlexAttention 把 Attention 开发中的分工划得很清楚:框架维护高性能计算模板,模型作者定义变化的规则,BlockMask 把可见性变成可以执行的块列表。实际优化时,顺着这三个位置查下去,往往比只看一个总稀疏率更有效:规则是否被融合、无效块是否被跳过、剩下的构建和索引成本是否值得。
参考
[1] Dao, T., et al. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. NeurIPS 2022. arXiv:2205.14135。
[2] Dong, J., et al. Flex Attention: A Programming Model for Generating Optimized Attention Kernels. 2024,MLSys 2025. arXiv:2412.05496,模板编译、BlockMask 与分页映射见 §4–5。
[3] PyTorch. FlexAttention: The Flexibility of PyTorch with the Performance of FlashAttention. 2024. 官方介绍,含 score/mask 示例与重编译、mask 缓存说明。
[4] PyTorch. torch.nn.attention.flex_attention. 2.14 API 文档,含 flex_attention、create_block_mask、BlockMask 定义。
[5] PyTorch v2.14.1 源码:Python API 与 BlockMask、Inductor FlexAttention、Inductor FlexDecoding。
[6] PyTorch. FlexAttention Part II: FlexAttention for Inference. 2025. 官方博客,涵盖短 query、位置偏移、BlockMask 复用、PagedAttention 与 autotune。
[7] Dao, T., et al. Flash-Decoding for Long-Context Inference. 2023. 官方博客,KV 分片及 log-sum-exp 归并见正文算法说明。
[8] PyTorch. scaled_dot_product_attention. 2.14 API 文档。
[9] PyTorch. FlexAttention + FlashAttention-4: Fast and Flexible. 2026. 官方博客,说明 FA4 模板与 Inductor 生成 CuTeDSL 规则的衔接。