前置阅读:LLM 推理(Inference)性能推导 · 注意力头设计
Agent 每调一次工具,返回的网页、代码或执行结果都会接回上下文,下一轮请求既要处理这些新内容,又要重新用上之前的历史。任务跑得越久,成本就远不止生成几个 token:长输入要做 prefill,历史 KV 占着显存,想跨请求复用,还得把缓存存到主机内存或 SSD,用的时候再搬回 GPU。
DeepSeek V4.1-Flash 把这几笔成本放在一起优化:用 Causal Encoder-Decoder(CED)改变上半网络建立历史记忆的方式,用 Compressed Sparse Attention 2(CSA2)让多层共享缓存和检索结果,再用 SWA Bounded Replay 重建短期的局部状态。[1]
技术报告里有两个数字很容易混:全局 KV 为 890 字节/token,约为 V4-Flash 的四分之一;相同工作负载下,持久化 KV 约为八分之一。 前者主要来自表示方式、跨层共享和精度,后者还叠加了缓存保存策略的变化。下面顺着“谁产生历史、谁读取历史、哪些状态值得长期保存”这条线,把这几件事串起来。
1. KV Cache 还能从哪些地方省
在普通的因果 Transformer 里,新 token 不会改变旧位置已经算好的 K/V,所以解码时把旧 K/V 留着、只算新位置,就不用反复处理整段历史。
如果每层各存一份 K 和 V,单条序列的缓存大小大致是:
\[M_{\mathrm{KV}}\approx 2LNn_{\mathrm{kv}}d_hb.\]这里 $L$ 是层数,$N$ 是历史长度,$n_{\mathrm{kv}}$ 是 KV 头数,$d_h$ 是每个头的维度,$b$ 是每个元素的字节数;系数 2 对应 K、V 两份向量。这个式子只是用来看清成本从哪来的基线,V4.1 的缓存布局没法直接往里套。
GQA/MQA 减少的是 KV 头的副本,MLA 改的是每条历史记录的表示,量化压的是元素位宽。顺着这个式子往下看,还剩两处可以动:历史 token 是不是每个都得存成独立条目,以及不同层是不是非得各存一份。
计算侧也有文章可做。传统 prefill 要拿到深层的 K/V,通常得让长提示词把前面的层完整走一遍。如果上半网络的历史记忆能直接从中间层的输出建立,长输入还有必要一路算到底吗?CED 就是从这里下手的。
2. CED 让 decoder 的全局记忆提前产生
V4.1-Flash 的语言骨干共 40 层,分成 20 层 causal encoder 和 20 层 decoder。两部分都遵守因果可见性,整个网络依然是自回归生成。这里的 encoder 指的是负责形成历史表示的下半网络。[1]
设提示词有 $N$ 个 token,encoder 的输出为:
\[H_{\mathrm{enc}}\in\mathbb R^{N\times d}.\]CED 把 decoder 全局 KV 的来源统一提前到这个输出上。用投影来示意:
\[C_l=H_{\mathrm{enc}}W_l^{\mathrm{KV}},\qquad l>20.\]$W_l^{\mathrm{KV}}\in\mathbb R^{d\times d_{\mathrm{kv}}}$ 把隐藏状态投影成历史 KV 表示,$C_l$ 的形状是 $N\times d_{\mathrm{kv}}$。这里省掉了归一化、位置编码等细节,论文中一般形式的 CED 定义还包括生成压缩权重的投影。重点在于:这部分历史记忆不再需要提示词一层层走过 decoder 才能产生。[1]
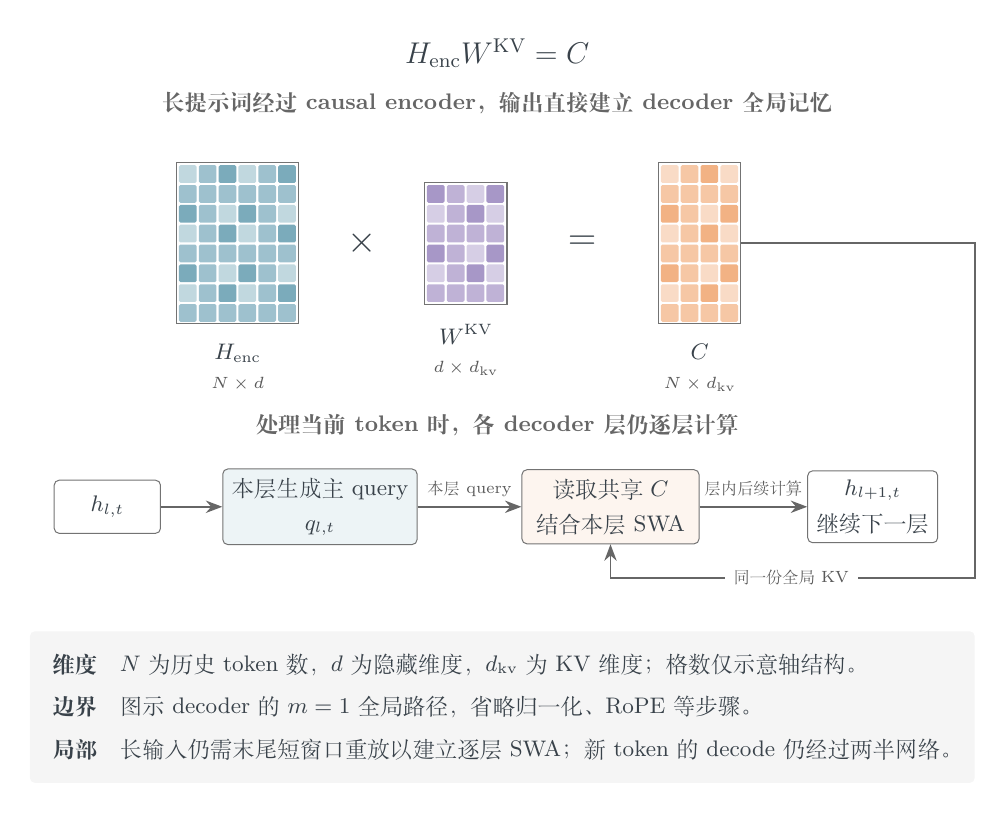
这样一来,prefill 的大部分工作到 encoder 就结束了。Decoder 还要处理提示词末尾的一小段,用来建立每层的局部滑动窗口状态;开始生成后,新 token 也照样要经过 encoder 和 decoder。省下来的,是长提示词大量历史位置在 decoder 里的计算。
用一个简化模型粗算一下。令总层数为 $L$,局部窗口为 $W$,实际重放长度为 $r=\min(N,W)$。假设两半网络每 token 每层的成本相同,先不管全局 KV 投影、调度和 kernel 差异,则:
\[C_{\mathrm{base}}\propto NL,\qquad C_{\mathrm{CED}}\propto N\frac L2+r\frac L2,\] \[\frac{C_{\mathrm{CED}}}{C_{\mathrm{base}}} \approx\frac12+\frac{r}{2N}.\]比如 $N=32768$、$W=128$,token-layer 工作量之比约为 50.2%。输入越长,尾部重放的占比越小;输入短的话,这部分就不能忽略了。当然这只是对工作量的粗算,端到端延迟还要算上实际算子、数据传输和调度的开销。
CED 延续了 YOCO 的思路,让上层读取下层形成的历史记忆。[2] 不过“来自同一份 encoder 输出”不等于“只存一份全局缓存”,不同层完全可以对同一个输入做不同的投影。V4.1 要进一步减少缓存副本,靠的是 CSA2 的共享规则。
3. CSA2 共享历史内容,也共享读取位置
先看单层做了什么。CSA2 维护一份 main KV,存放给主注意力读的历史表示;另有一份小一些的 indexer K,给轻量检索器打分用。当前 token 先通过 indexer 选出少量历史条目,再由主注意力读取这些条目,和本层最近的 SWA 条目一起算出输出。
压缩决定存多少条,稀疏检索决定这次读多少条。 这次没进 Top-k 的全局条目还留在缓存里,后面的 query 仍然可能选中它。
为了把“内容”和“位置”分开,设某个共享组的 main KV 为 $C\in\mathbb R^{M\times d_{\mathrm{kv}}}$,$M$ 是当前因果可见的全局条目数。Indexer 为位置 $t$ 生成分数向量 $a_t\in\mathbb R^M$,从中选出整数索引:
\[S_t=\operatorname{TopKIndices}_k(a_t),\qquad S_{t,j}\in\{0,\ldots,M-1\}.\]然后按这些地址取数值:
\[G_t[j,:]=C[S_{t,j},:],\qquad G_t\in\mathbb R^{k\times d_{\mathrm{kv}}}.\]这里假设可见条目足够、能选满 $k$ 个,短上下文还要处理有效数量和 mask。$S_t$ 只是地址列表,$G_t$ 才是选中的 KV 数值。多个 query head 可以共用同一份选择,但注意力权重还是各自用自己的主 query 来算。
CSA2 把每一层静态地划成三种模式,分别复用这条链路上的不同部分。[1]
Full 建一组 main KV 和对应的 indexer K,再用本层的 indexer query 算出 Top-k,走的是完整的缓存加检索路径。这里的 Full 是说职责完整,主注意力本身仍然是稀疏读取。
Reindex 复用最近一个 Full 层建好的 main KV 和 indexer K,但用自己的 indexer query 重新打分、重新选 Top-k。历史内容是同一份,深层却可以换个方式找信息。
Reuse 连最近一次 Full 或 Reindex 选出的 Top-k 也直接沿用,省掉了新的 indexer query 和打分。它仍会产生本层的主 query、本层的 SWA KV 和新的注意力输出,后面的 MoE 等计算也照常进行。
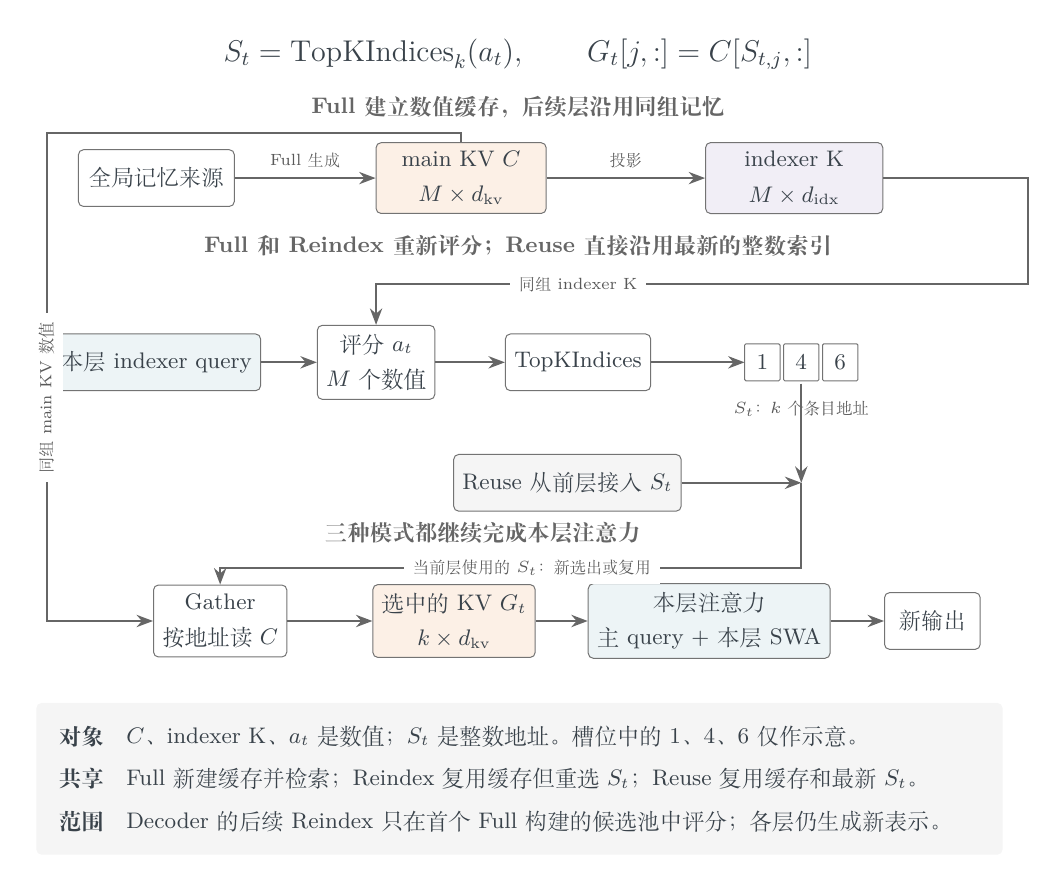
这两种共享省的东西不一样:共享 main KV 和 indexer K,省的是长期驻留的缓存;共享 Top-k,省的是当前 token 在后续层里的重复检索。Reuse 复用的是同一个 query 位置在不同层之间的选择,而不是让以后所有 token 都用同一张地址表。
4. 40 层怎样只留下四组全局缓存
共享关系在官方配置里写得很直白。下面只摘了相关字段,层号从 0 开始:[3]
{
  "n_layers": 40,
  "window_size": 128,
  "kv_source_layers": [2, 8, 14, 20],
  "index_source_layers": [2, 8, 14, 20, 24, 28, 32, 36],
  "index_topk": 512,
  "candidate_source_layer": 20,
  "candidate_topk_blocks": 2048,
  "candidate_block_size": 8
}
为了符合阅读习惯,下表改用从 1 开始的层号。$m$ 表示几个历史 token 合并成一个全局 KV 条目。
| 网络部分 | 层号 | 层模式 | 全局 KV 压缩比 |
|---|---|---|---|
| Encoder 开头 | 1–2 | 仅 SWA | 无全局缓存 |
| Encoder 三个共享组 | 3–8、9–14、15–20 | 每组 Full + 5 Reuse | $m=2$ |
| Decoder 第一个组 | 21–24 | Full + 3 Reuse | $m=1$ |
| Decoder 后四组 | 25–28、29–32、33–36、37–40 | 每组 Reindex + 3 Reuse | $m=1$ |
所以 encoder 有三组全局记忆,每组约 $N/2$ 条;decoder 只有一组,约 $N$ 条,由它的 20 层共用。不计尾部凑不满一组的边界,整个网络的全局条目数是:
\[3\times\frac N2+N=2.5N.\]注意 encoder 的 $m=2$ 只压缩全局缓存的条目数。Encoder 输出仍然为每个输入 token 保留隐藏状态,形状还是 $N\times d$,decoder 才能用 $m=1$ 构造自己的全局记忆。另外,各层的局部 SWA 还是各自维护。
Decoder 还做了一次分层检索。第一个 Full 层扫描所有因果可见的全局条目,选出自己要读的 Top-512,同时建一个更大的候选池。配置里最多选 2048 个 block,每个 block 8 个位置,所以候选池最多有:
\[2048\times8=16384\]个位置。后面的 Reindex 层只在这个候选池里打分,再选各自的 Top-512。[1][3] 候选池管“去哪找”,Top-512 管“最后读什么”。这样后续检索的规模就有了上限,不过第一个 Full 层还是得把全局历史扫一遍。
5. 890 字节/token 是怎么算出来的
四组全局缓存解决了副本数量,FP4 则继续压缩每个条目。main KV 和 indexer K 虽然都是四位元素,缩放格式却不一样。
Main KV 的维度为 512。报告用 E2M1 元素,每 16 个通道配一个 8-bit E4M3 scale,不再额外加全局 scale。所以一条 main KV 的紧凑数据量是:[1]
\[b_{\mathrm{main}} =512\times\frac48+\frac{512}{16}\times1 =256+32=288\ \text{bytes}.\]Indexer K 的维度为 128,用 MXFP4。按 OCP MX 格式,每 32 个四位元素共享一个 8-bit E8M0 scale,一条 indexer K 是:[1][3][4]
\[b_{\mathrm{index}} =128\times\frac48+\frac{128}{32}\times1 =64+4=68\ \text{bytes}.\]再乘上前一节的条目数:
\[\frac{M_{\mathrm{global}}}{N} \approx\left(3\times\frac12+1\right)(288+68) =890\ \text{bytes/token}.\]按模型配置和量化格式重建出来的这笔账,和报告给出的全局 KV 数字对得上。它算的是 main KV、indexer K 以及它们的量化 scale,缓存页填充、分配器开销、临时索引和运行时工作区都不在里面。另外 main KV 本身已经是共享的 latent 表示,所以也不用再乘开头基线公式里 K、V 各一份的系数 2。
以 100 万 token 为例,这部分紧凑数据约 890 MB,约 0.83 GiB。这里面既没有模型权重,也没有各层的 SWA,光凭它看不出整个模型能不能装进某张 GPU。
局部 SWA 对量化更敏感,报告保留了 FP8。Main KV 则在后训练中加入了量化感知训练,在 RoPE 之后量化,读取时再反量化。[1] 所以四位缓存首先是存储格式上的优化,注意力运算本身并没有全换成 FP4 矩阵乘。
6. 局部窗口为什么不再长期保存
全局历史随 $N$ 增长,SWA 只保留最近 $W=128$ 个 token。对一条正在跑的序列来说,局部状态的大小是有上限的;但服务系统要保存的,是许多会话、许多轮次的恢复点。
V4 部署时会在 prompt 结束和输出结束的位置各存一份 SWA 快照。多轮短对话会不断产生这类恢复点,哪怕每份只有一个窗口,累积起来也不小。在报告描述的工作负载里,SWA 约占旧版持久化 KV 容量的一半。[1]
两类状态被复用的时间尺度也不一样。全局前缀可能很久以后还会被命中,局部窗口则主要服务活跃会话里接下来的交互。所以 V4.1 把 encoder 的 SWA 放进保留时间较短的主机内存池,全局 KV 照旧进长期前缀缓存;decoder 的 SWA 则在每次 prefill 时重建,只给随后的 decode 用。
这样八分之一就好算了。设旧的持久化缓存为 $P_{\mathrm{old}}$,其中全局部分约占一半;新的全局部分缩小到约四分之一,SWA 又移出了长期缓存,于是:
\[P_{\mathrm{new}} \approx\frac14G_{\mathrm{old}} \approx\frac14\times\frac12P_{\mathrm{old}} =\frac18P_{\mathrm{old}}.\]这个八分之一依赖报告里的工作负载和原有的缓存构成。运行时照样需要 SWA,短期主机内存池也要占资源,省下来的是长期持久化 KV 这一块。
但这套策略能不能落地,关键在下一个问题:全局前缀命中了,局部状态却已经被淘汰,恢复它要重算多少历史?
7. Bounded Replay 用近似状态限制恢复成本
只看一层的话,恢复最后 128 个位置,好像重算这 128 个 token 就够了。但沿着网络往下追就会发现,这些 token 的隐藏状态依赖下层更早的局部窗口,下层又依赖更早的位置,局部依赖就这样逐层往前扩张。
对 $L_r$ 层、窗口 $W$,按这种扩张估算,精确恢复需要的输入跨度约为 $L_rW$。20 层 decoder、128-token 窗口,对应约 2560 个 token;如果拿完整的 40 层来示意,则约 5120 个。两个数用的层数不同,也都没计较边界上的计数差异,只是跨度的粗估。
SWA Bounded Replay 干脆把重放范围限制在最近一个窗口。设重放起点为 $s$,位置 $i$ 的局部可读范围变成:
\[\mathcal W_i^{\mathrm{replay}} =\{\max(s,i-W+1),\ldots,i\}.\]窗口包含当前 token。原本可能读到 $s$ 之前的位置,现在被截掉了,所以段开头的状态会变,最终恢复出来的是近似的 SWA KV。截断只作用在局部 SWA 分支上,已有的全局记忆照样能读。[1]
拿 $W=4$、重放位置 $100\ldots103$ 举个例子。正常情况下,位置 100 的局部分支能看到 $97\ldots100$,重放时只能看到 100。位置 103 虽然能看到完整的 $100\ldots103$,但这些位置在更低层的表示可能已经被左边界截断影响了。所以即便最后一行的窗口是完整的,深层状态也未必和完整前向一致。
两半网络用这个机制的时机不一样:
- Encoder:全局前缀命中但 SWA 缺失时,重放缓存前缀的最后一个窗口,只恢复局部状态,已有的全局 KV 直接复用,不重算也不覆盖;没缓存过的新后缀则正常产生全局和局部状态。
- Decoder:每次 prefill 都把提示词最后一个窗口的 encoder 输出送进 decoder,在截断后的局部范围内建立 SWA,供随后的 decode 使用。
这也补全了 CED 能成立的条件:长提示词的全局 KV 可以从 encoder 输出直接构造,decoder 省不掉的局部恢复则被限制在一个短窗口里。
技术报告称,在他们的评测里这种近似对回答质量影响很小,后训练时也模拟了 decoder replay,让模型适应这条路径。[1] 但它毕竟改变了计算语义:encoder 新后缀的状态可能随前缀命中位置的不同而变化。复现时要检查不同缓存命中位置下的任务质量,光看“KV 已恢复”说明不了结果是对的。
8. 把这些机制放回一次请求
以一轮追加了工具结果的请求为例:系统先找到可复用的全局前缀;encoder 的局部状态如果还在短期内存池里就直接用,不在就先重放末尾窗口,再处理新增内容。三个 encoder 共享组各自追加全局记忆,最终的 encoder 输出再为 decoder 的共享全局缓存提供新条目。
接着,decoder 只对提示词末尾的窗口建立逐层 SWA。开始生成后,每个新 token 都要走完两半网络:Full 层维护全局记忆并做检索,Reindex 层调整选择,Reuse 层沿用选择,各层再用自己的主 query 和局部状态更新表示。跨请求留下来的长期资产主要是全局前缀,局部状态则按更短的生命周期管理。
要评估这套设计,最有用的是对照几种情形:长输入和短输入,前缀全命中和局部状态缺失。分别记下 prefill 时间、首 token 延迟、decode 吞吐、全局 KV 大小、局部内存池占用和重放质量,才能看清收益来自哪一段。890 字节/token、约八分之一的持久缓存、长输入工作量接近减半,这三个数回答的是三个不同的问题。
这和 DualPath 讨论的缓存加载路径正好能接上:模型先决定要保存什么、哪些状态可以共享或重算,推理系统再决定把它们放在哪、怎么搬。模型结构和缓存管理,也就不再是各管各的两项优化了。
参考
[1] DeepSeek-AI. DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression. 2026. arXiv:2609.19969,本文核对 v1 的 §2.2、§2.3、§2.4.4、§3.2、§4.2.1。
[2] Yutao Sun et al. You Only Cache Once: Decoder-Decoder Architectures for Language Models. 2024. arXiv:2405.05254。
[3] DeepSeek-AI. DeepSeek-V4.1-Flash inference/config.json. 2026. 官方配置,固定提交 517ef625,另见官方模型说明。
[4] Open Compute Project. OCP Microscaling Formats (MX) Specification, Version 1.0. 2023. §5.2,MXFP4 元素、block 与 scale 格式。
[5] Jia-Bin Huang. DeepSeek Splits the Transformer in Two. Here’s Why. 2026-09-30. 视频讲解。本文从该视频的学习笔记整理展开;配图为依据上述机制重绘的逻辑示意。