前置阅读:LLM 推理(Inference)性能推导 · DeepSeek V4.1:拆分 Transformer,压缩 KV Cache
DeepInfer 的部署 Q&A 里有一组挺有意思的数据:每个 rank 60 个并发请求时,把固定长度验证换成 DSpark 的变长验证,平均验证的 draft token 从 5 个降到 3.58 个,表中的平均接受长度只从 3.30 掉到 3.21,官方估计的吞吐却从 13,730 涨到 14,466 tok/s/rank,提高了 5.4%。[3]
drafter 还是同一个,每轮照样生成 5 个候选,调度器只是少送了几个给大模型验证。为什么这样反而更快?
原因在于,一个候选会占掉一个验证位置,但它最后不一定能贡献一个输出 token。低并发时,多验证几个位置的边际成本可能很低;并发一高,这些位置就会挤占整个 batch 的计算容量。DSpark 要做的,就是判断哪些候选值得花这笔成本。
1. 并行生成了一整块,但不是整块都有用
先看普通投机解码的一轮:小模型根据已确认的上下文生成一段草稿 $x_1,\ldots,x_\gamma$,大模型一次前向算出对应的条件分布,再从左到右逐个接受或拒绝这些候选。
设某个位置的目标分布为 $p$,草稿分布为 $q$。对于从 $q$ 抽出的候选 $x$,接受概率为:
\[\alpha(x)=\min\left(1,\frac{p(x)}{q(x)}\right).\]一旦出现第一次拒绝,后面的草稿全部丢弃,从修正分布里采样一个 token;如果草稿全部通过,就由目标模型再采样一个 bonus token。靠这套接受、修正机制,最终输出能保持目标模型的分布。[1]
这里成本上有个不对称:目标模型已经并行算完了后面的位置,接受却只能沿着前缀一步步往前走。 第 2 个候选一旦被拒,第 3、4、5 个位置哪怕单独看都很像正确答案,也没法越过第 2 个留下来。
DFlash 把生成草稿里最贵的那部分并行化了:用块扩散模型一次产出多个位置的预测,并把目标模型的上下文特征注入 drafter。这样草稿网络可以做得更深,又不用为每个位置串行跑一遍完整的 Transformer。[2]
但并行预测有个弱点:各位置之间没法协调“这一块到底选了哪种续写”。前面采样选了一种表达,后面的位置可能还在按另一种表达预测,结果后缀越来越难通过验证。
DSpark 在这个结构上加了一个很轻的串行头。设并行 backbone 给第 $k$ 个位置算出的基础 logits 为 $U_k(v)$,实际使用的草稿分布可以写成:[1]
\[q_k(v\mid x_{<k}) \propto\exp\left(U_k(v)+W_1[x_{k-1}]W_2[:,v]\right).\]第二项是由前一个已采样 token 决定的转移偏置。默认的 Markov head 用秩为 256 的分解,$W_1[x_{k-1}]$ 只是取出一个低维向量,再经 $W_2$ 映射到词表。所以昂贵的 Transformer 还是一次并行算完,只由这个便宜的头从左到右修正分布并采样。
这样块内的依赖关系保住了,每个位置也还有明确归一化的草稿概率,后面的 rejection sampling 照样有 $q_k$ 可用。不过草稿更准只是第一步。只要后缀还会被拒,就还有另一块优化空间:在大模型计算之前,先判断这一段值不值得验证。
2. 一个验证位置,到底值多少输出
DSpark 的 Confidence Head 预测的是:前面的草稿都通过的前提下,本位置被接受的概率,记为 $c_{r,j}$,其中 $r$ 表示请求,$j$ 表示该请求里的草稿位置。
它和“刚抽中的那个 token 的接受概率”还不太一样。对一个还没采样的位置,平均接受概率满足:
\[\begin{aligned} \mathbb E_{x\sim q}[\alpha(x)] &=\sum_v q(v)\min\left(1,\frac{p(v)}{q(v)}\right)\\ &=\sum_v\min\bigl(p(v),q(v)\bigr)\\ &=1-\frac12\lVert p-q\rVert_1. \end{aligned}\]论文就拿最后这一项当 confidence 的监督信号。预测头读的是当前位置的 hidden state 和前一个 token 的 Markov embedding,特意不读当前要决定是否验证的 $x_{r,j}$。[1] 这个限制后面会关系到调度的正确性。
第 $j$ 个候选要真正贡献输出,前面 $j-1$ 个也必须全部通过。所以调度器估计它对期望产出的贡献时,要用前缀存活概率:
\[a_{r,j}=\prod_{i=1}^{j}c_{r,i}.\]这是条件概率的链式分解,不需要假设各位置相互独立。但实际调度用的是模型估计值,所以校准很重要:要是把 0.6 一贯预测成 0.9,哪怕排序大体没错,也会高估多验证几个位置能换来的收益。为此论文用了逐位置的 Sequential Temperature Scaling,来校准累乘后的前缀概率。[1]
现在假设有 $R$ 个请求,请求 $r$ 验证前 $\ell_r$ 个草稿,目标模型实际处理的位置数是:
\[B=\sum_{r=1}^{R}(1+\ell_r).\]除了草稿,每个请求还要一个基础位置,输入是已经确认的末尾 token。对应地,完整一轮的期望输出数为:
\[\tau=\sum_{r=1}^{R}\left(1+\sum_{j=1}^{\ell_r}a_{r,j}\right).\]其中的 1 对应每个请求一定会拿到的那个 correction 或 bonus token。$\tau$ 是整个 batch 每轮的期望产出,包含这一项;$B$ 是目标模型的输入位置数,别把两者混成“接受率”。这里忽略了 EOS 等提前终止的边界情况。[1]
看一个自己设的教学例子:三个请求各有四个候选,一共只给六个额外验证位置。图中标的是累乘后的 $a_{r,j}$:
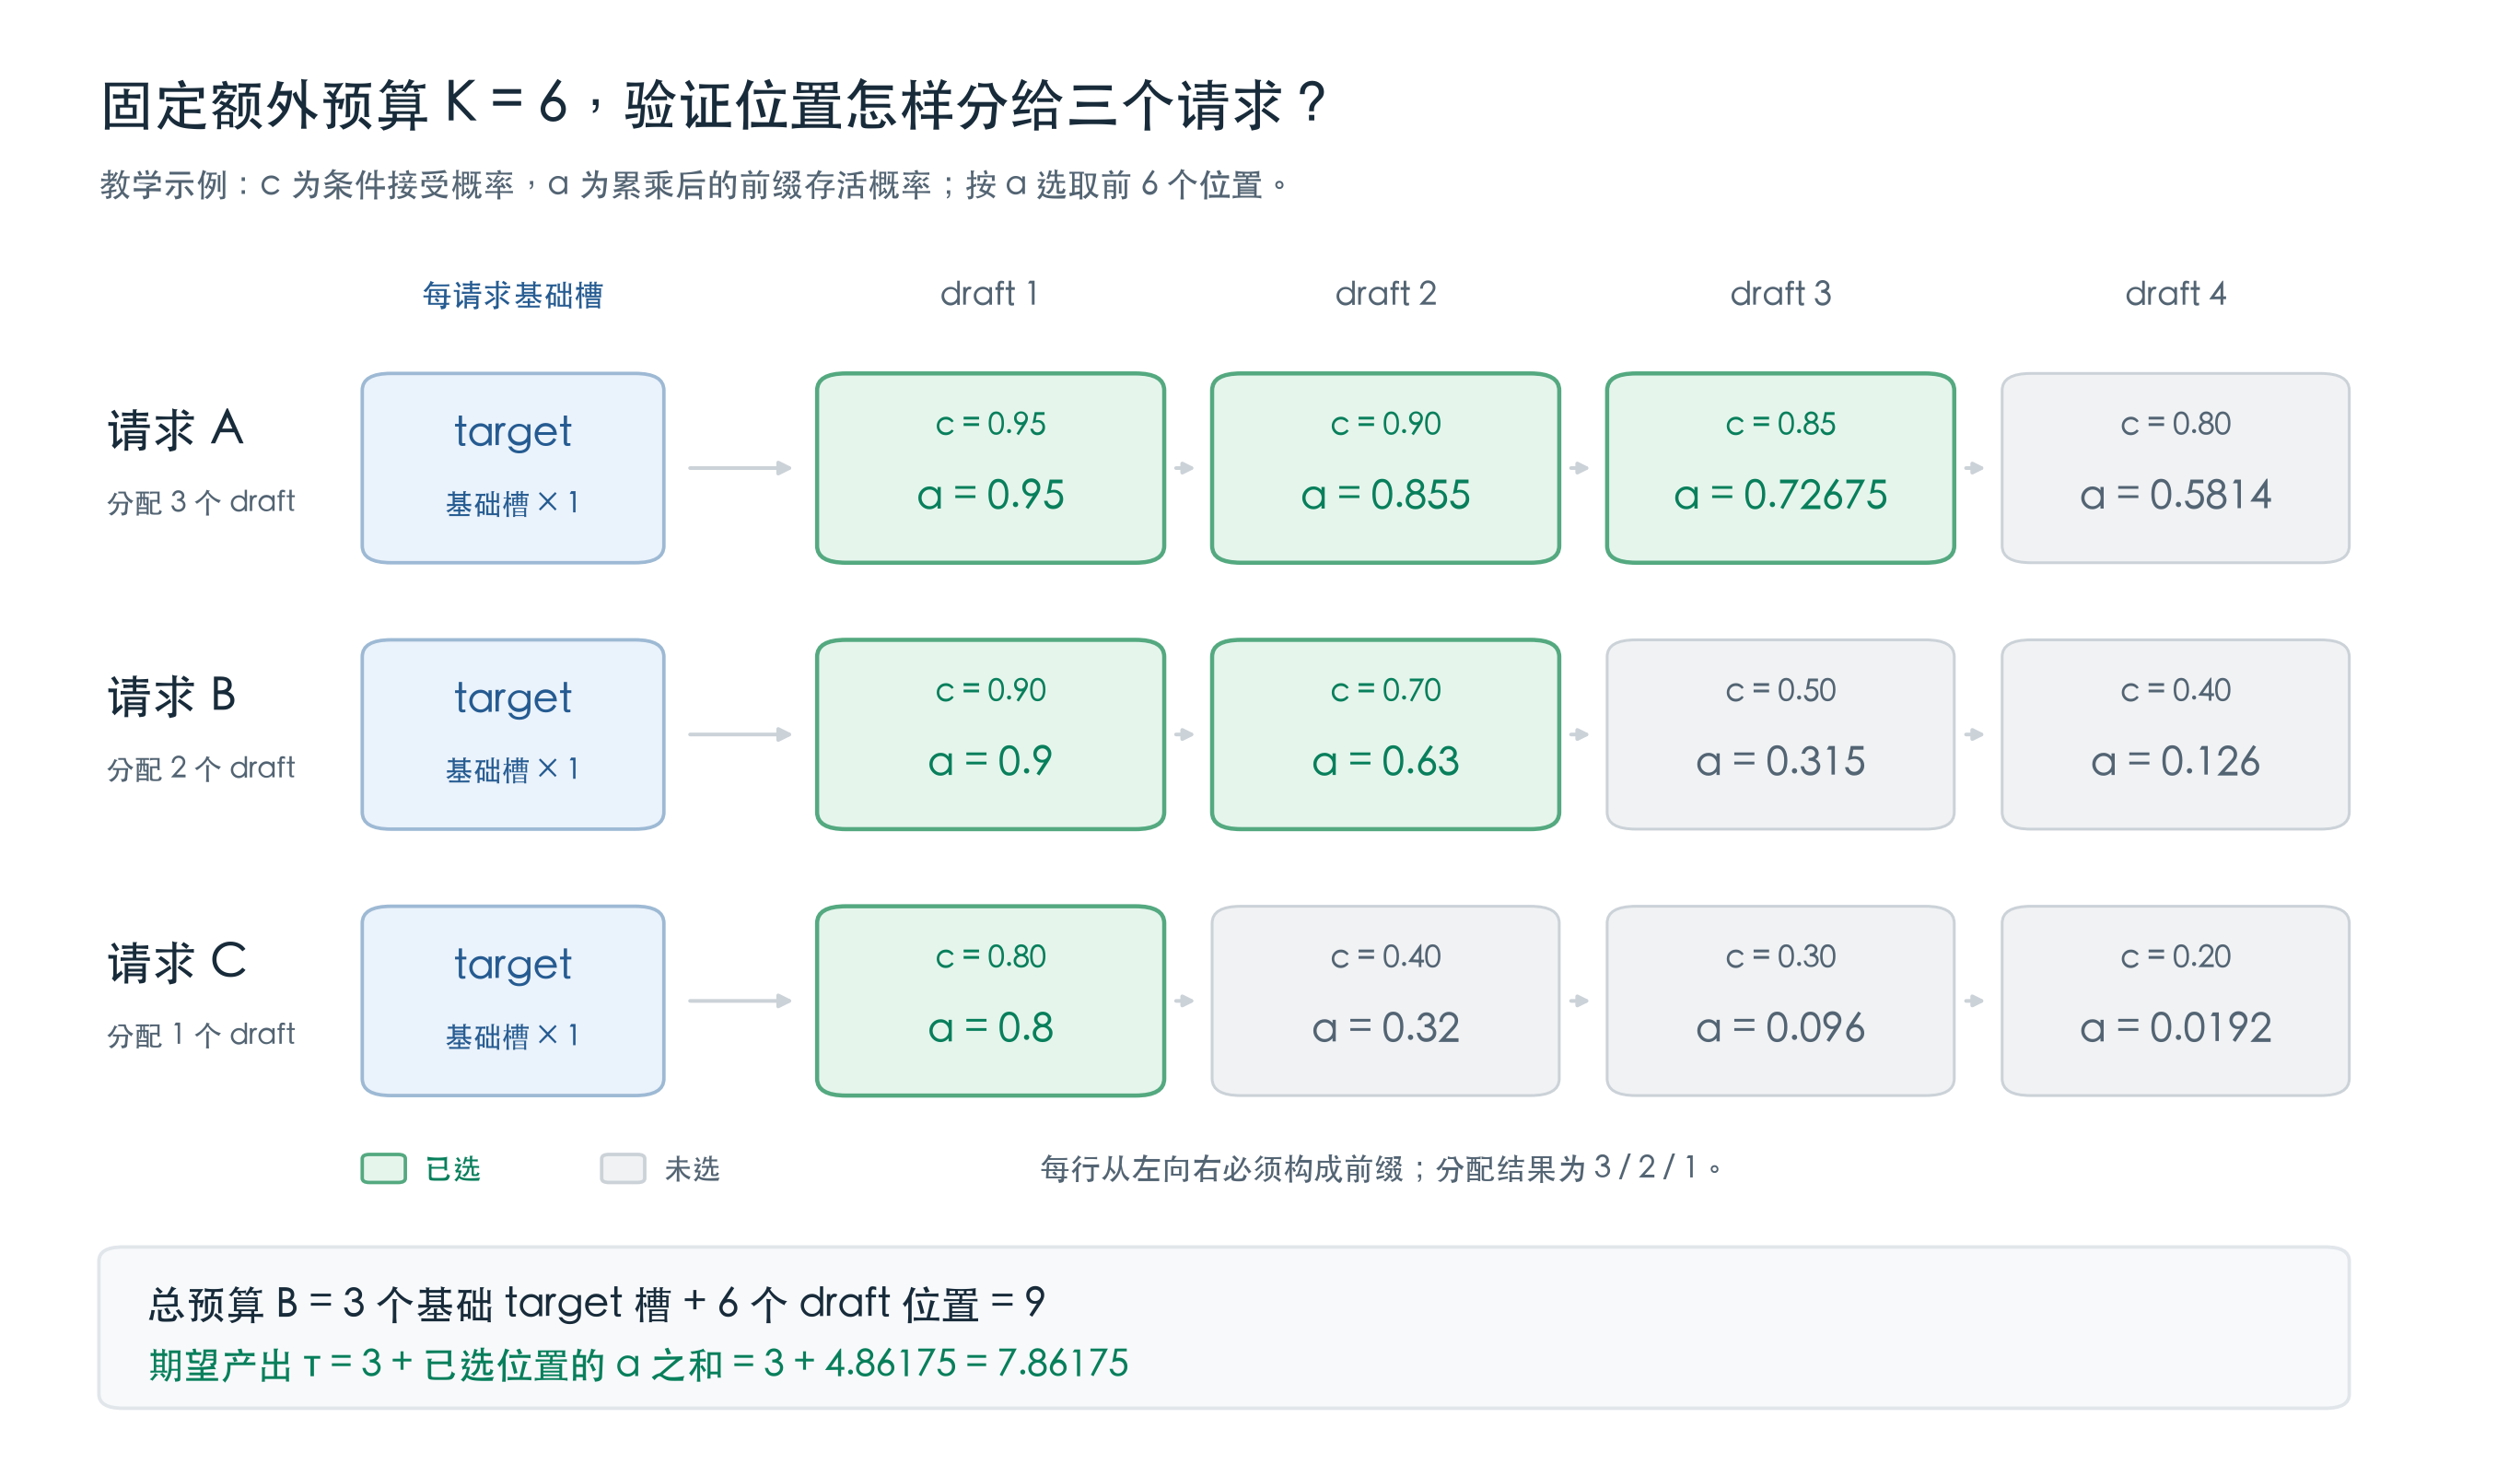
平均分成每个请求两个,并不是收益最高的分法。A 的第 3 个位置还有约 0.727 的前缀存活概率,C 的第 2 个只有 0.320,把后者的位置让给前者,期望产出更高。
固定额外预算 $K=6$,按 $a$ 从大到小挑,结果是 A 取前三个、B 取前两个、C 取第一个。加上三个基础位置,$B=9$,期望产出约为 $\tau=7.862$。不过这只说明了预算给定后怎么分,预算本身该多大还没回答。
因为同一请求的 $a_{r,j}$ 随位置不增,全局排序天然会保留前缀,同分时让靠前的位置优先就行。对固定的 $B$,这样选能让期望产出最大。下一步要把硬件代价算进来。
3. 验证预算要跟着硬件曲线走
设整个推理循环处理 $B$ 个目标模型位置要花 $t(B)$,那调度真正要最大化的是:
\[\Theta(B)=\frac{\tau(B)}{t(B)} =\tau(B)\operatorname{SPS}(B).\]$\operatorname{SPS}$ 是 steps per second,即每秒跑多少轮,乘上每轮产出的 token 数就是 token/s。[1]
道理很直白:验证长度加长,期望产出会增加,每轮也可能变慢。只盯着一边,工作点就会选错。
由此可以推出一个边际条件。设当前每轮用时 $t$、期望产出 $\tau$,再加一个前缀存活概率为 $a$ 的候选,时间增加 $\Delta t$。只有满足
\[\frac{\tau+a}{t+\Delta t}>\frac{\tau}{t} \quad\Longleftrightarrow\quad a>\frac{\tau}{t}\Delta t,\]这次扩展才划算。
右边是新增耗时按当前吞吐折算成的 token 数,新候选带来的期望产出得超过它。比如当前 $\tau=8$、$t=2\ \text{ms}$,新增一个位置多花 $0.1\ \text{ms}$,那它的 $a$ 就得大于 0.4。这个数只是用来演示判据,实际的 $\Delta t$ 要靠硬件实测。
低并发时,大模型跑一轮里可能还有不少固定开销和没用上的算力,多塞几个位置,$\Delta t$ 很小,后缀通过概率不高也值得一试。并发上去以后,继续扩大验证 batch 的代价变高,同样的后缀就可能不划算了。所以同一个请求也不该永远验证一样长的一块。
DeepInfer 的代码把这个目标写得很直接,下面是固定版本 9bd9cf2 里的两行:[4]
const double time_ms = baseline_ms + slope_ms * graph_size + sampler_ms;
const double cur_throughput = cur_expected / time_ms;
cur_expected 从请求数开始累加,再逐个加上候选的前缀存活概率。分母包括 CUDA Graph 档位对应的基准 forward 时间、在线修正,以及采样阶段的耗时。注意这里的 sampler_ms 还包含下一块 drafter 的执行,不只是 softmax 或抽样本身。[4][5]
代码会先把逻辑上的 $B$ 向上取到已捕获的 CUDA Graph 档位,再估算耗时。所以新增一个位置可能不改变 graph,也可能刚好跨进更大的档位;kernel 的 tile、wave 等执行粒度还会带来别的台阶。真实的硬件曲线并不光滑,调度器得在候选预算里搜索,而不能假设“每多验证一个位置都多花同样的时间”。
另外,$t(B)$ 得能代表当前负载。论文里的 V4 部署靠负载均衡同时控制各 rank 的请求数和上下文总长,让这个近似更靠谱;上下文、路由负载或并行配置一变,耗时模型也得跟着更新。[1]
4. 为什么不能看完整块,再挑一个最好的预算
到这里思路好像很自然:草稿已经生成了,confidence 也都有了,把所有可能的预算都试一遍,挑吞吐最高的就行。
问题是,预算怎么选也可能改变输出分布。
论文附录给了一个极简反例:目标模型只生成 A、B,$p(A)=0.7$;草稿模型的 $q(A)=0.5$。假设调度器看到候选是 A 就送去验证,看到 B 就扔掉草稿,直接从目标分布重新采样。
草稿抽到 A 的概率是 0.5,接受概率为 $\min(1,0.7/0.5)=1$;剩下 0.5 的情况退回目标采样。最终输出 A 的概率变成:
\[P(\text{输出 A})=0.5+0.5\times0.7=0.85.\]目标分布本来是 0.7,现在成了 0.85。每次验证或目标采样单独看都没问题,组合起来却引入了选择偏差。[1]
DSpark 的情况更隐蔽。当前位置的 confidence $c_k$ 不读 $x_k$,但下一位置的 $c_{k+1}$ 要读前一个 token,也就是 $x_k$。如果调度器先看后面的 confidence,再回头决定 $x_k$ 值不值得验证,就可能间接拿 $x_k$ 的取值来筛选它。
所以光保证“最后选出来的是一个前缀”还不够,决定是否收录 $x_k$ 时,也得遵守因果约束。 论文的基础调度算法在收益不再增加时就早停,不让更靠后的候选信息反过来改变前面的决定。固定 $B$ 时,前缀选择是最优的;但要跨 $B$ 搜索、靠第一次下降就找到全局最优,还得目标曲线是单峰的。[1]
偏偏真实硬件有台阶:越过一个局部低点,后面可能还有更好的 CUDA Graph 工作点。怎样既能搜索这些档位,又不让当前草稿的具体取值影响总预算?
5. 用旧信息决定做多少,用较新信息决定分给谁
DSpark 的生产方案把两个决定拆开:先定总验证容量,再在这个容量里给各请求分配长度。
统一按“即将执行第 $N$ 步”来编号。DeepInfer 用第 $N-2$ 步的历史 confidence 估计总预算 $B_N$,这一步可以查看完整的历史预测和硬件档位,找到更好的吞吐点;因为它不读当前这一块的候选信息,也就不会出现前面那种回看当前 token 的选择偏差。[1][4]
然后,逐请求的长度用第 $N-1$ 步产生的较新 confidence,在已固定的 $B_N$ 下按前缀存活概率分配。这样既能及时跟上请求难度的变化,总容量又保持不变。
额外预算 $K=B_N-R$ 固定之后,同一请求靠后的位置不会排到靠前的位置前面,同分时也是前位优先。所以要不要把 $x_k$ 排进前 $K$ 个位置,用不到由 $x_k$ 产生的后续 confidence。这样“预算固定”和“保持因果”就对上了。
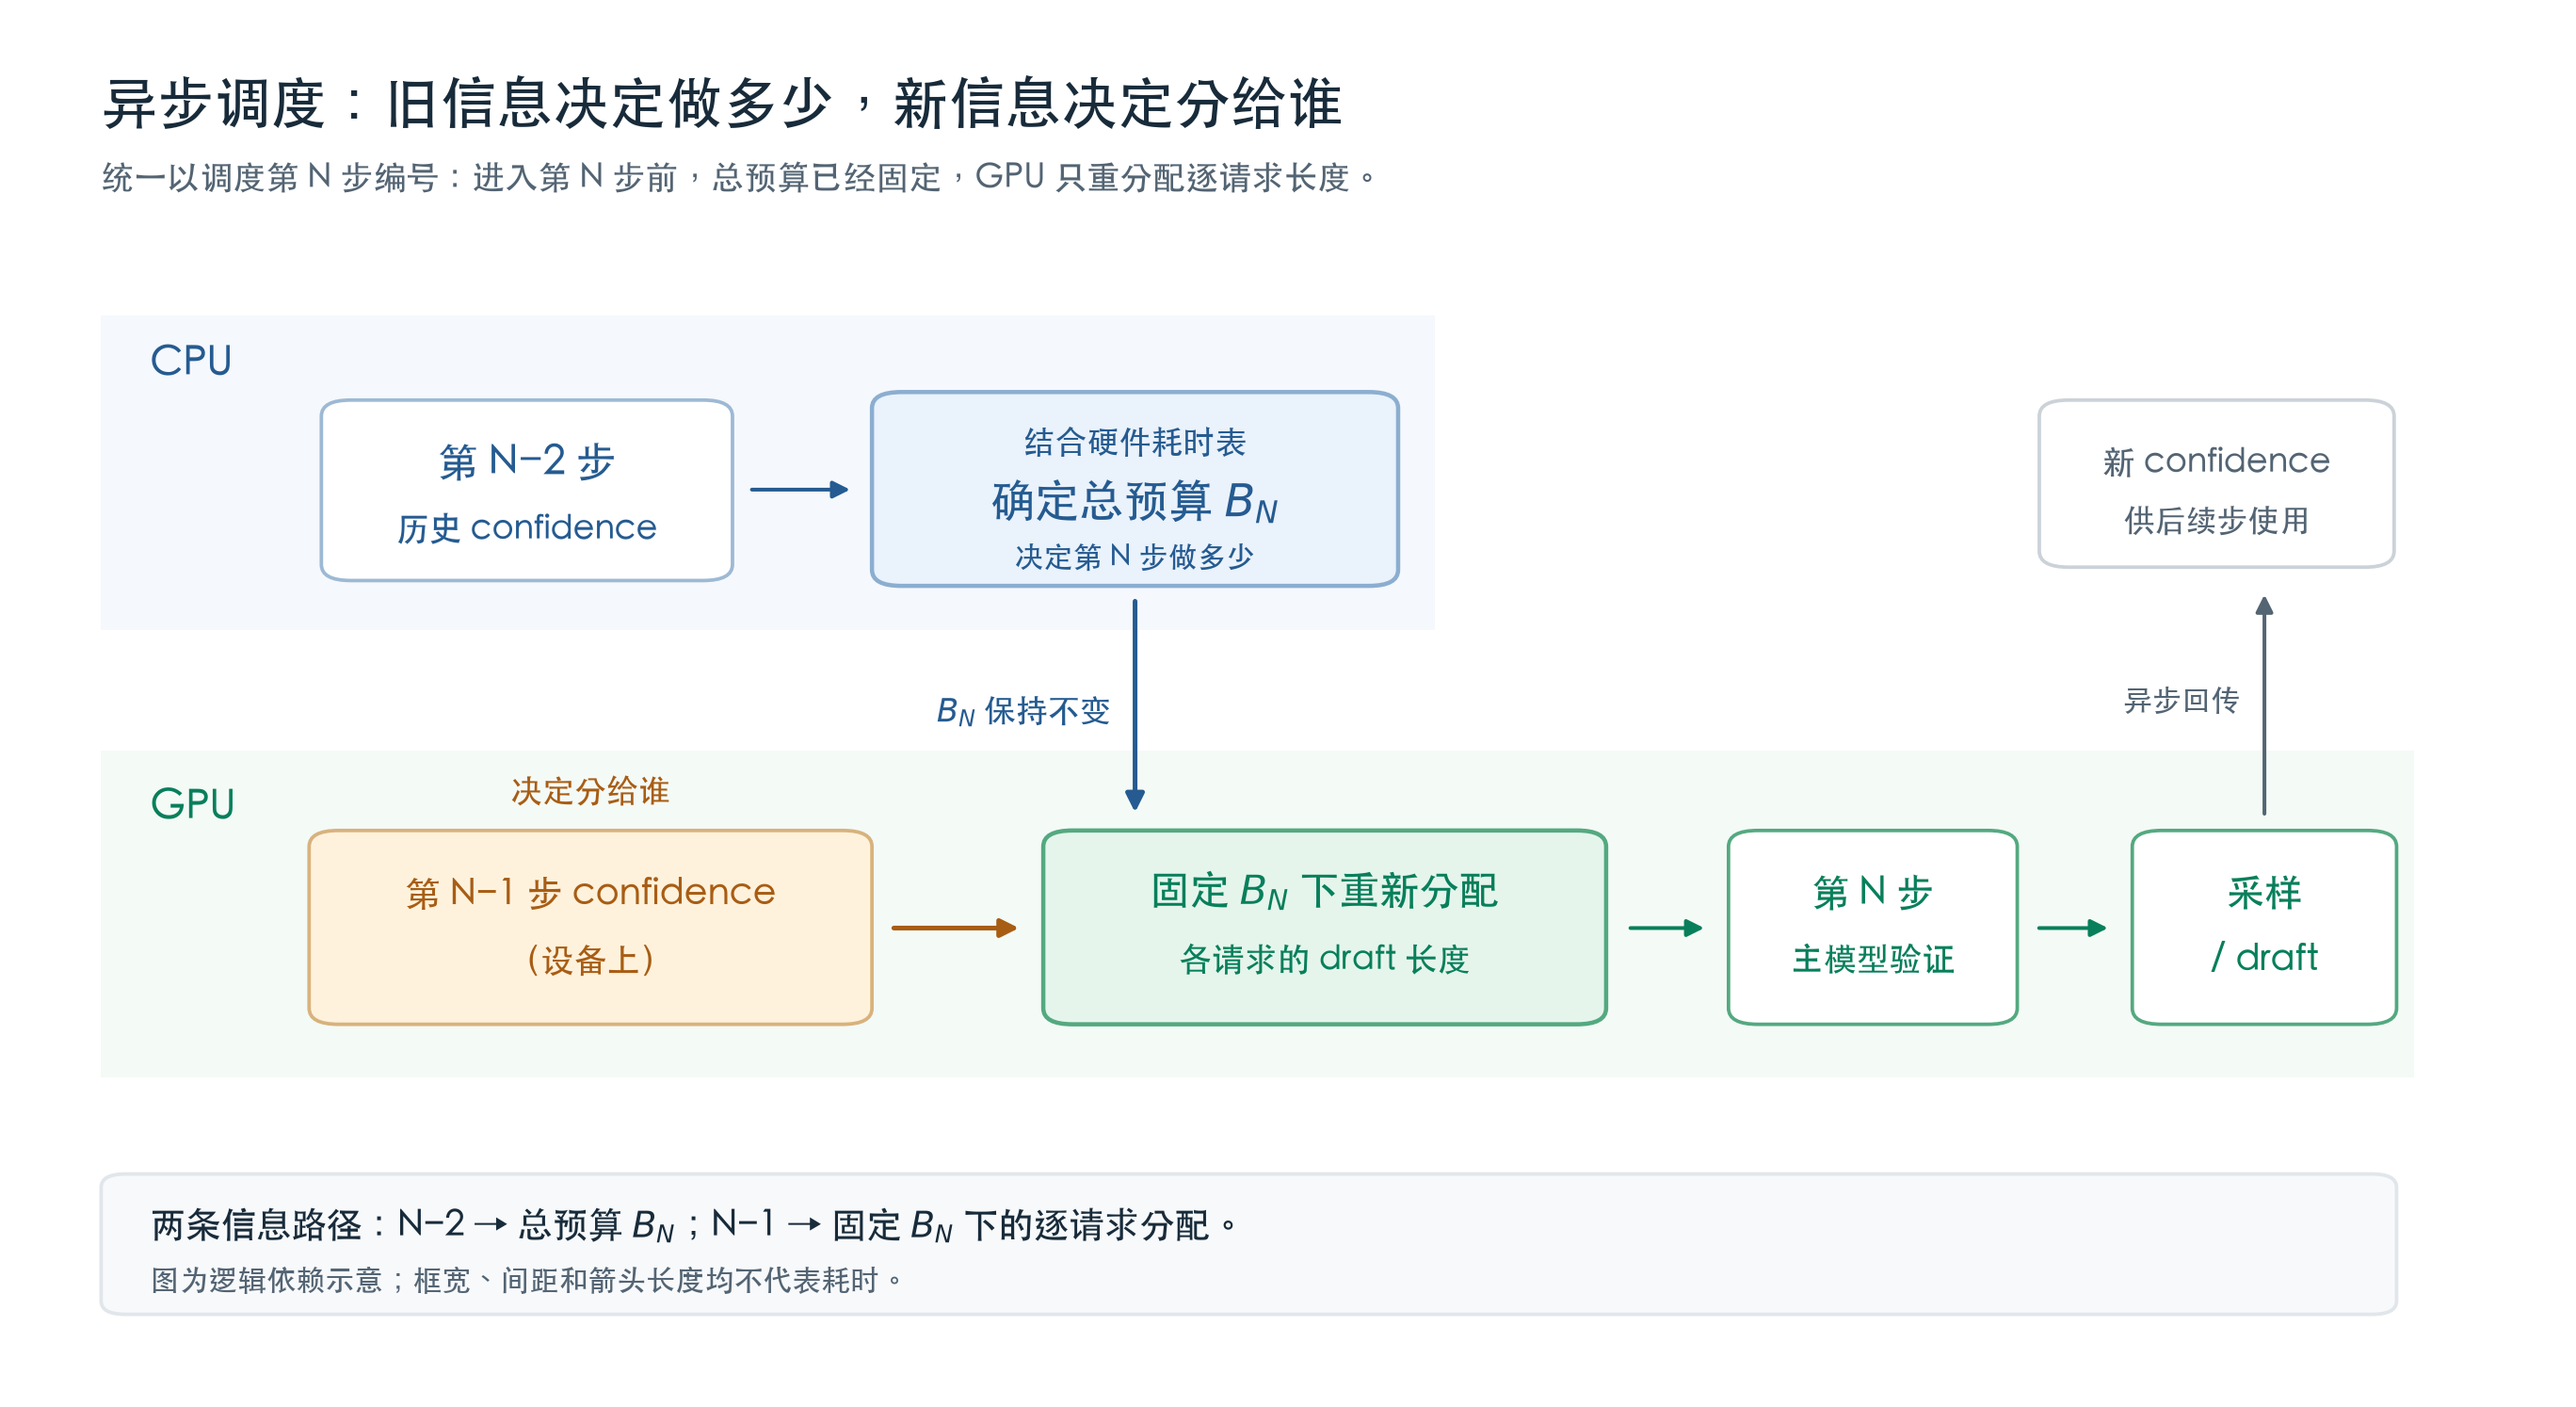
这也正好契合 Zero-Overhead Scheduling(ZOS)的执行方式:为了让调度和计算重叠,CPU 要在设备上当前这步还没跑完时就提前安排下一步。CPU 做预算决策时,最新结果可能还没传回来;而 GPU 可以在下一轮 forward 之前,读取留在设备上的较新 confidence,重新分配同一个总预算。[6]
在固定版本的实现里,GPU 先算各位置 confidence 的累乘,再按全局排名选出预算内的候选,转成每个请求的长度。CUDA 路径用并行 rank counting 实现这个选择,同分按位置顺序处理。它只改“位置分给谁”,不重新选总预算。[6]
这套异步调度同时解决了两个问题:CPU 提前知道 batch 容量,可以继续复用 CUDA Graph;预算搜索也能越过硬件曲线的局部低点,而不用拿当前候选的后续信息来决定这一轮算多少。
代价是总预算有滞后。流量或请求难度突变时,历史估计可能暂时不准;较新的 confidence 能改善容量内部的分配,但消除不了这个滞后。
6. 回到那组“少验证反而更快”的数据
回到开头的工作点。每个 rank 60 个并发请求时,平均验证的草稿位置从 5 降到 3.58,少了 28.4%;官方表里的平均接受长度从 3.30 降到 3.21,变化不大,估计吞吐却提高了 5.4%。可见被裁掉的后缀占了不少验证位置,却没带来相应比例的有效接受。[3]
这里的验证长度只数 draft,理论公式里的 $B$ 还要给每个请求加一个基础位置。Q&A 没有给出表中 accepted length 和完整一步产出之间的统计口径,所以这里不把 3.30 直接代入前面的 $\tau$,也不拿它反推单步耗时。
把并发这个维度展开,收益并不恒定:
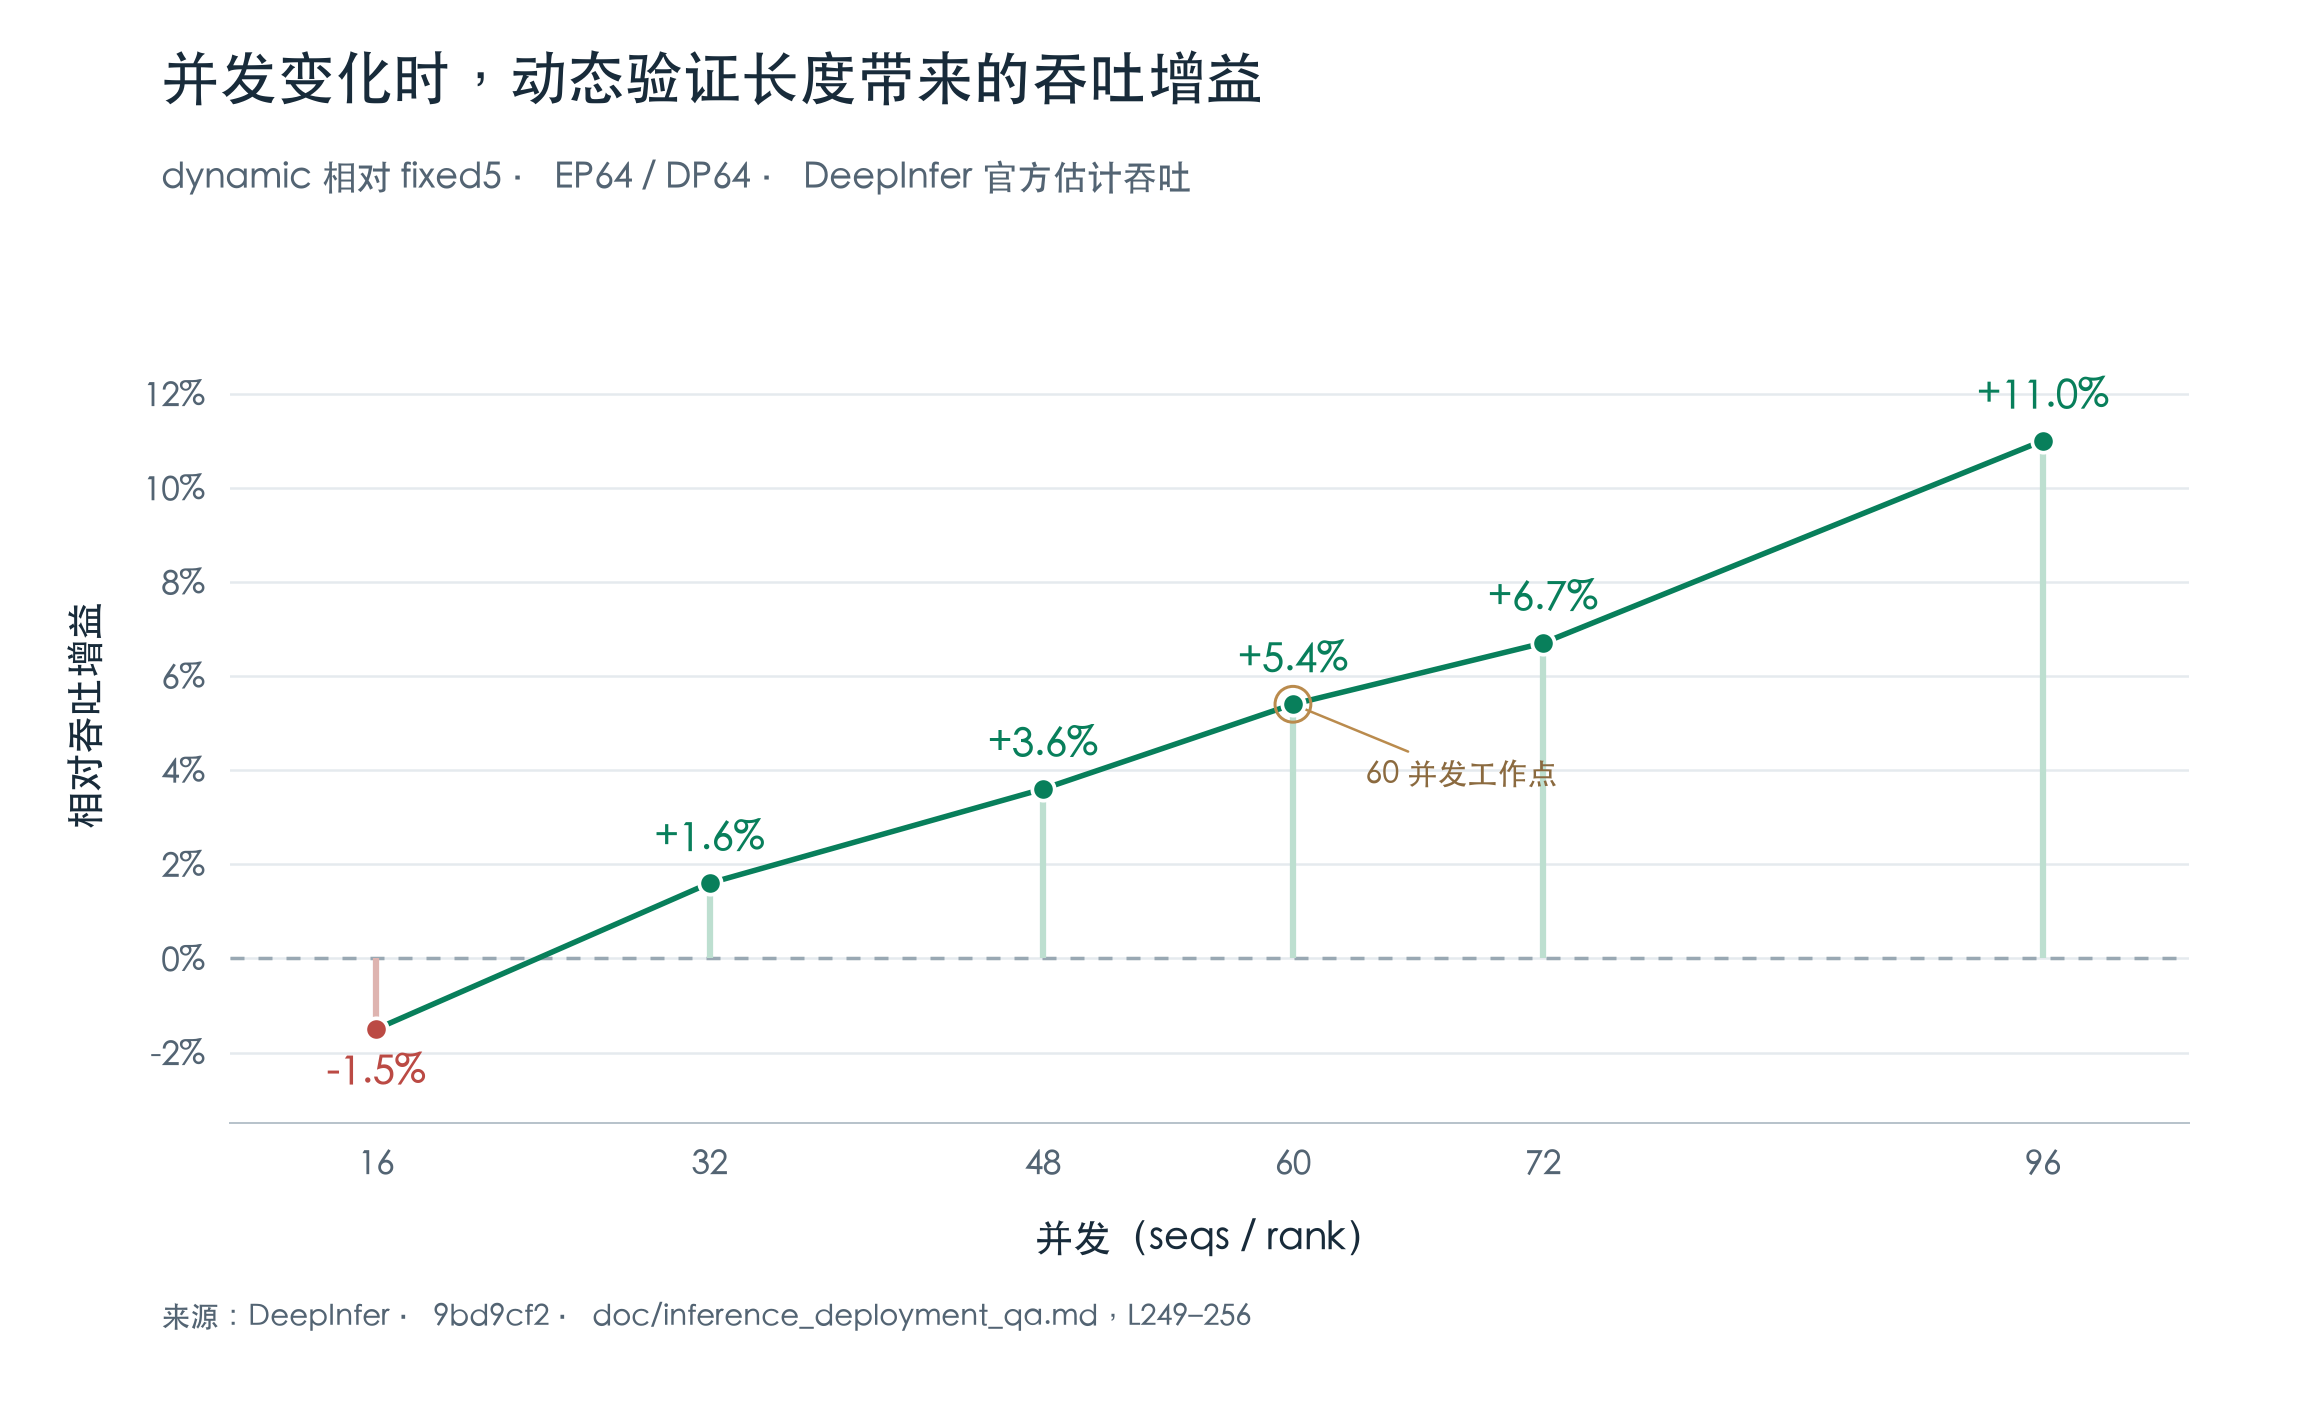
图中数据来自 DeepInfer 部署 Q&A,由 EP64/DP64 benchmark 数据计算,本文没有复测。16 并发时变长验证反而低了 1.5%,96 并发时收益达到 11.0%。低负载下多验证几个候选仍然划算,缩短长度不一定赚;负载高了,低收益后缀消耗的容量才明显成为负担。
DSpark 论文里的线上结果和这组 V4.1 数据不是同一组实验:部署用的是 DeepSeek-V4 Flash/Pro preview,以 MTP-1 为基线,比较的是完整的 DSpark 方案,比如 Flash 在 80 tok/s/user 的服务约束下吞吐提高了 51%。这里面有 drafter 架构、草稿质量和调度的共同作用,不能都算在“少验证”头上。[1]
对本文的问题来说,更直接的证据是 Q&A 里同一 drafter 下固定 5 和变长验证的对比。它把变量收窄到验证预算上:砍掉一部分昂贵计算,同时保住大部分有价值的接受。
7. 接受长度也得有个价格
DSpark 给投机解码补上的,是接受长度的成本模型。
更长的草稿块,只有在增加的期望产出足以抵消新增执行时间时,才会提高吞吐。同样的候选概率,换个并发、换块硬件、换个 CUDA Graph 档位,选择就可能不一样。
所以评估一个投机解码方案,不能只看平均接受长度,还要看它在什么并发下测的、每轮实际处理多少位置、这些位置花了多少时间,以及预算决策有没有保住目标分布。把这几样串起来,才能解释为什么更准的 drafter 有时并不更快,以及为什么少验证一些 token,系统反而能多产出一些 token。
参考
[1] Cheng et al. DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation,2026,本文按 v1 核对。§3.1–3.2 为结构与调度,§5.2 为异步方案,§5.4 为线上实验,Appendix A 为选择偏差反例。https://arxiv.org/html/2607.05147v1
[2] Chen et al. DFlash: Block Diffusion for Flash Speculative Decoding,2026。https://arxiv.org/abs/2602.06036
[3] DeepSeek-AI. DeepSeek V4.1 Flash Inference Deployment Q&A,2026,固定 commit 9bd9cf243fc53ef9afbf8f04d391d989117d6ab9,Speculative decoding 与收益表。
[4] DeepSeek-AI. DeepInfer 验证预算调度器,同一 commit,历史预测与逐请求分配。
[5] DeepSeek-AI. DeepInfer 执行成本测量,同一 commit,forward profile、采样计时与下一块 drafter 调用。
[6] DeepSeek-AI. DeepInfer GPU 侧长度重分配,同一 commit,worker 调用与CUDA 前缀排名实现。